直播计算下沉到边缘节点的直接收益,是让推流链路更短、延迟更低、源站压力更小,同时显著节省带宽成本。这个结论不是理论推演,而是近两年直播平台普遍验证过的路径,下面拆开来看,到底哪些收益最实在,哪些计算值得挪下去,以及具体怎么落地。
直播转码下沉边缘节点 最直接的收益是什么
过去常见的直播架构是推流端把原始流推到中心机房,转码、合流、截图、审核都在那里处理,观众再从中心节点拉流,这个方案的问题在于链路太长,跨地域调度复杂,一旦碰到高峰时段,源站带宽和计算资源双双吃紧。


把直播计算过程下沉到边缘后,架构变成推流端就近接入边缘节点,转码、合流这些计算直接在边缘完成,观众也从最近的边缘节点拉流,这个变化带来的收益可以拆成三层看:
- 延迟层面:推流和拉流都不再绕远路,端到端延迟从常见的3-5秒降到800毫秒到1.5秒区间,连麦和实时互动的体验明显改善。
- 成本层面:回源带宽大幅减少,中心机房只需处理必要的存储和调度任务,服务器资源释放明显。
- 稳定性层面:边缘节点天然分散,单个节点出故障不会波及全网,容错能力更强,卡顿率在多数场景下能下降一个量级。
行业内测过的案例也不少,据业内专家指出,某中型直播平台把转码任务迁移到边缘节点后,源站带宽峰值降低了约四成,这个数字在不同场景下波动,但整体趋势是一致的。
边缘节点 直播延迟 能降多少
直播延迟的构成主要有三段:推流上行耗时、服务端处理耗时、下行分发耗时,传统架构里,服务端处理要在中心机房完成,跨地域的网络跳数本身就消耗时间,再加上转码排队,延迟自然就压不下来。
边缘节点把处理端挪到离推流和拉流都更近的位置,延迟的压缩体现在两个环节:
- 推流端到节点延迟,从几十毫秒降到个位数毫秒,因为节点就在本地网络内。
- 下行分发延迟,观众从最近的节点拉流,不需要跨城调度,这部分能省下大部分时间。
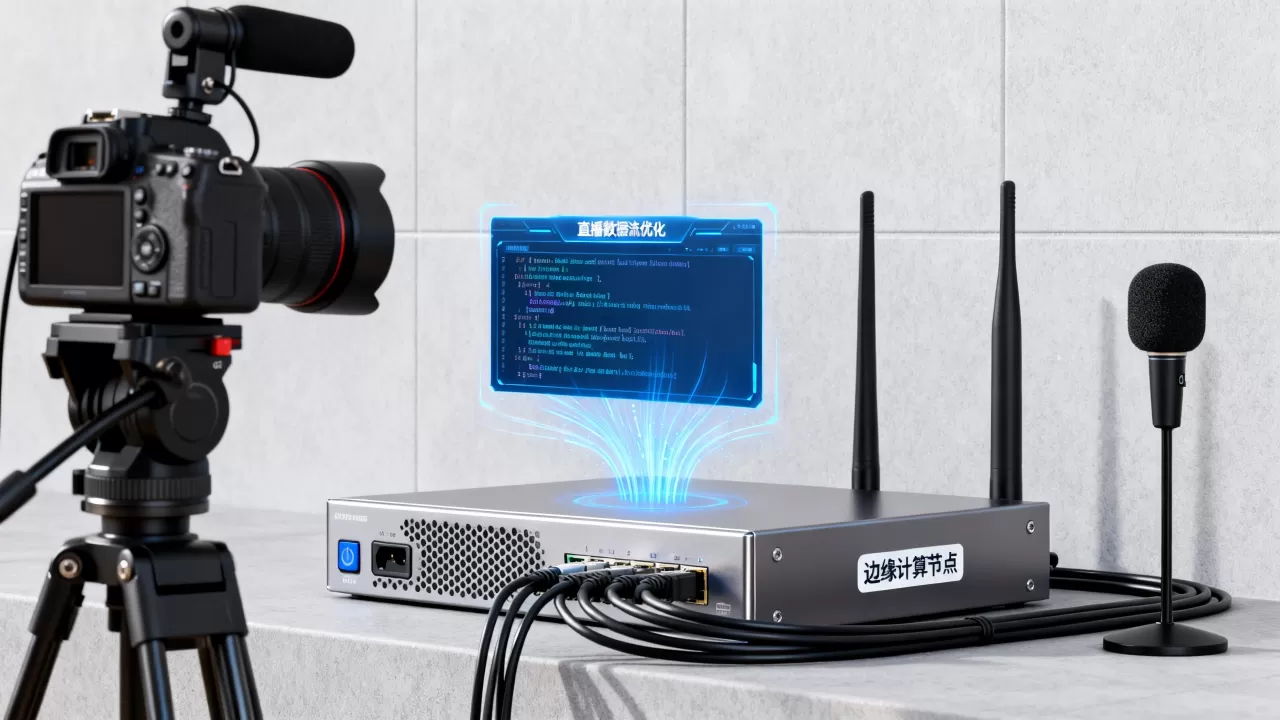
电商直播间场景下的延迟差异
电商直播对延迟的敏感度极高,主播喊“上链接”到观众手机弹出商品卡片,这个间隔超过2秒就会明显影响转化,边缘节点能不能压缩这个窗口,直接决定了互动话术的节奏。
实际效果上,延迟从4秒压到1秒以内,主播就能实时看到弹幕节奏并做出回应,不再出现“观众已经刷屏了主播还在讲上一句话”的尴尬,这对带货转化率的帮助是实打实的,行业共识认为延迟低于1秒基本可以做到“所见即所得”的互动状态。
用户体感上的卡顿对比
延迟和卡顿是两回事,但都会因为计算下沉而改善,延迟解决的是“反应慢”,卡顿解决的是“画面断”,边缘节点就近处理,意味着网络抖动概率降低,首帧加载时间也缩短。
测试数据里的表现是:按需拉流场景下,首帧时间在边缘架构下普遍能快200-500毫秒,实际观看的体感差异,在弱网环境下更明显,比如地铁、高铁这类场景,边缘节点能让画面恢复速度提升一大截。
边缘计算直播场景 有哪些应用值得先落地
不是所有计算都适合下沉,直播链路里的计算任务轻重缓急各不相同,先搞清楚哪些适合边缘、哪些不合适,才能避免白折腾一轮。
- 适合下沉的场景:转码(尤其是画质修复和自适应码率)、合流、弹幕过滤、频道录制、AI字幕、美颜特效。
- 不适合下沉的场景:需要全站数据的风控模型训练、需要跨直播间协同的推荐算法、需要长期冷存储的录像归档。
具体哪些计算任务适合迁移
以转码为例,边缘节点处理转码的好处在于:推流端到节点距离近,上行带宽占用比直接推到中心机房低得多,转码之后的输出流直接存放在边缘节点,观众拉流时无需再从中心回源,这个流程直接把回源流量砍掉一大截。
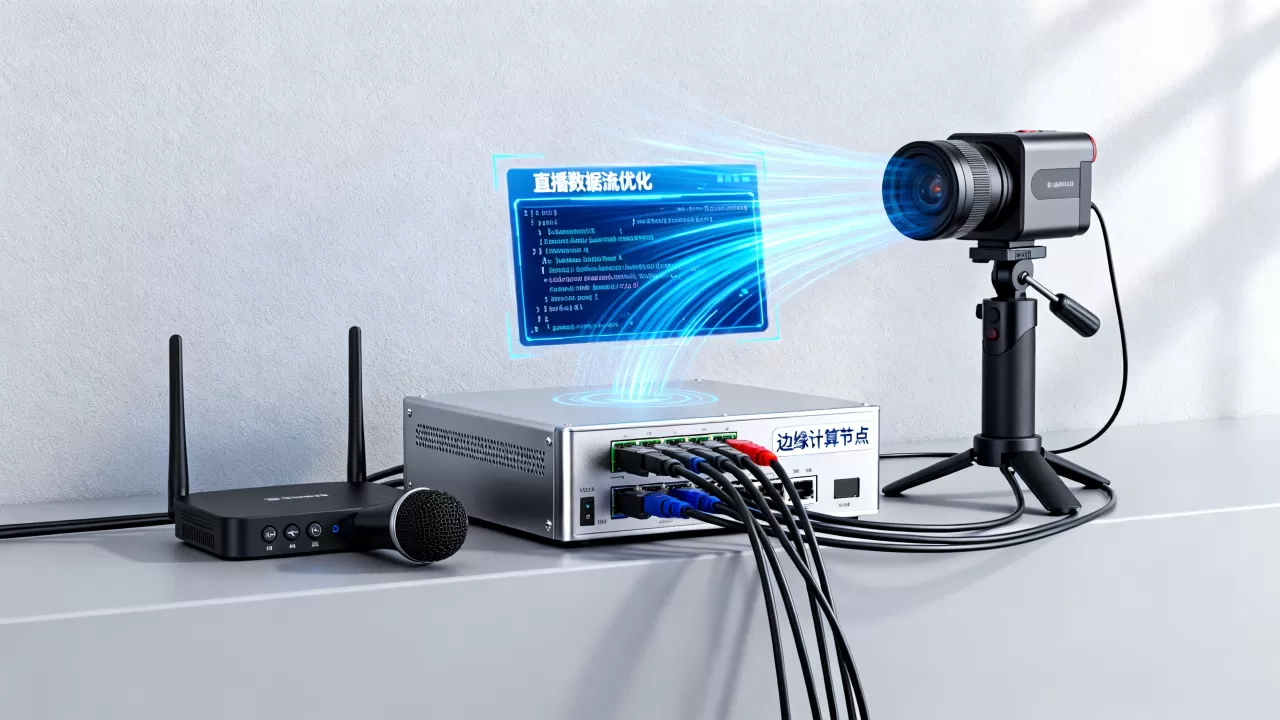
合流也很适合下沉,连麦场景里,主播和连麦观众的流在边缘节点完成画面合成,再推给其他观众,省去了多路流到中心合流再分发的冗余步骤,延迟降下来,画面同步也更自然。
实操落地路径参考
迁移不是把代码仓促丢到边缘节点就完事,需要分步走:
- 梳理现有直播链路,找到消耗计算资源最多的任务清单。
- 按“可拆分、可降级、可缓存”三个标准筛选适合边缘化的任务。
- 选定边缘节点做灰度测试,先切流量的10%-20%对比延迟和成本数据。
- 验证稳定后逐步提升边缘处理比例,保留中心资源做兜底。
这套路径不需要大团队,一个人配合运维就能推进,关键是灰度期间的数据要抓准。
直播CDN边缘节点 自建成本 和租用怎么选
谈到边缘计算,绕不开一个问题:自建节点还是用现成的边缘云服务?这取决于业务体量和预算边界。
- 自建节点适合流量规模大、业务定制需求强的平台,预算门槛高,需要专业的运维团队。
- 租用现成边缘节点适合中小团队和快速试水的项目,按量付费灵活度高,不需要关心硬件和网络调度。
成本对比视角
从成本结构上看,自建边缘节点的固定投入包括机房托管、硬件采购、网络带宽预留,月均成本相当高,而租用模式是按计算和带宽的实际用量计费,前期几乎为零投入。
规模效应是分水岭,当每日直播峰值的带宽消耗稳定在一个较高水平时,自建才可能摊平成本,否则租用模式在性价比上的优势很明显。
另一个容易被忽视的点是运维成本,自建边缘节点需要处理硬件故障、网络链路切换、容量扩容等各种琐碎问题,这些隐性支出会抵消部分硬件成本优势,中小团队盲目自建容易陷入运维泥潭。
怎么判断自己适合哪种模式
- 月带宽消耗达到一定规模,且业务稳定增长时,可以考虑自建。
- 业务处于快速试错的阶段,优先租用,避免投入沉没成本。
- 有强定制算法的需求,比如独家的画质增强、低延迟协议,这些需要深度控制节点硬件,自建更现实。
边缘化改造后 直播流程有哪些实际变化
改完架构后,技术团队需要适应的变化不少,最直观的是监控粒度变细了,不再是集中式看几个大屏,而是要看各个边缘节点的健康度、延迟分布、丢包率。
- 网络排障要从“中心链路是否拥堵”变成“哪个区域节点是否异常”。
- 发布流程要支持灰度到边缘节点,避免全量上线后才发现问题。
- 数据回收和日志采集需要更细的维度,否则边缘节点出问题很难定位。
这些变化不算颠覆性,但对于习惯了中心化运维的团队来说,需要一段适应期,建议先把运维监控体系搭建好,再逐步迁移流量,不要追求一步到位。
常见问题
直播转码放在边缘节点 会不会增加运维复杂度?
会增加一部分复杂度,尤其是监控和日志采集维度变多,但这些都可以通过自动化运维工具覆盖,边缘节点数量多并不等于运维工作量线性增长,对比节省下的带宽成本和用户体验提升,这笔运维投入在多数场景下都是划算的。
边缘节点主要解决延迟问题还是成本问题?
两者兼有,但优先级取决于业务模式,以互动直播为主的场景,延迟优化带来的直接收益是用户留存和转化率提升,这是第一收益,以流量型直播为主的场景,带宽成本节省则会更快反映在财务报表上,多数情况下,延迟优化和成本节省会同时发生,只是权重不同。
写在最后
把计算下沉到边缘,本质上是在距离用户更近的地方处理数据,直播的实时性要求决定了它对边缘计算的需求比大多数业务都迫切,延迟降低和成本节省这两个收益在同一个方向上是同步发生的,至于走多远、用哪种方式,取决于业务规模和团队节奏,但方向本身是清晰的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/714529.html