一台GPU服务器的芯片数量并非固定值,主流配置通常搭载2颗CPU加4至8颗GPU芯片,整机芯片落地下限为4颗,上限可达10颗以上,这个答案取决于服务器定位:训练型侧重GPU数量,推理型兼顾功耗与成本。
拆解GPU服务器的芯片结构
要弄清一台GPU服务器有多少芯片,得先把“芯片”这个概念拆开看,GPU服务器不是只有GPU,它由多类芯片协同工作,每一类承担不同职责。

核心计算芯片:CPU与GPU的比例关系
CPU是服务器的“总指挥”,负责数据调度、逻辑判断和系统运行,GPU是“算力引擎”,负责大规模并行计算,二者组合方式决定了整机芯片数量。
当前主流的GPU服务器遵循以下硬件规格参数(参考NVIDIA认证系统设计白皮书和ODM厂商公开规格):
- 4卡推理服务器:1颗至2颗CPU,搭配4颗GPU,整机芯片总量5至6颗。
- 8卡训练服务器:2颗CPU,搭配8颗GPU,整机芯片总量10颗,这是大型模型训练的标准配置。
- 2卡入门级服务器:1颗CPU,搭配2颗GPU,整机芯片总量3颗,多用于边缘推理和小规模验证。
“一台GPU服务器有几颗芯片”这个问题,多数场景下指的就是8卡机型,即10颗核心计算芯片,这类服务器广泛部署于云数据中心和智算中心,市面上租用的GPU云服务器,大半运行在相似规格的物理机上。
管理芯片与辅助芯片:容易被忽略的芯片数量
除了CPU和GPU,GPU服务器主板上还集成着其他算力单元:
- BMC管理芯片:独立的小型处理器,负责远程开关机、温度监控、固件管理。
- NVSwitch芯片(仅8卡及以上机型):连接多颗GPU实现高速互访,每颗NVSwitch本质也是一颗专用芯片。
- 网卡芯片与RAID阵列卡芯片:处理网络通信和磁盘阵列。
把这些辅助芯片计入在内,一台完整8卡GPU服务器的芯片总数约15至18颗,不过行业讨论芯片规模时,默认只统计CPU加GPU,也就是10颗这一档。
不同GPU数量对应不同的落地形态
明确了芯片总量之后,再看这些芯片如何组合,以及不同组合背后的业务考量。
4颗GPU芯片:平衡之选
4卡机型通常用于中小规模模型微调、视频转码和中等并发推理,它的机箱尺寸更紧凑,功耗相对友好,4颗GPU通过PCIe总线互联,芯片间的通信带宽低于8卡机型的NVSwitch全互联架构,但胜在部署灵活。
8颗GPU芯片:训练场的绝对主力
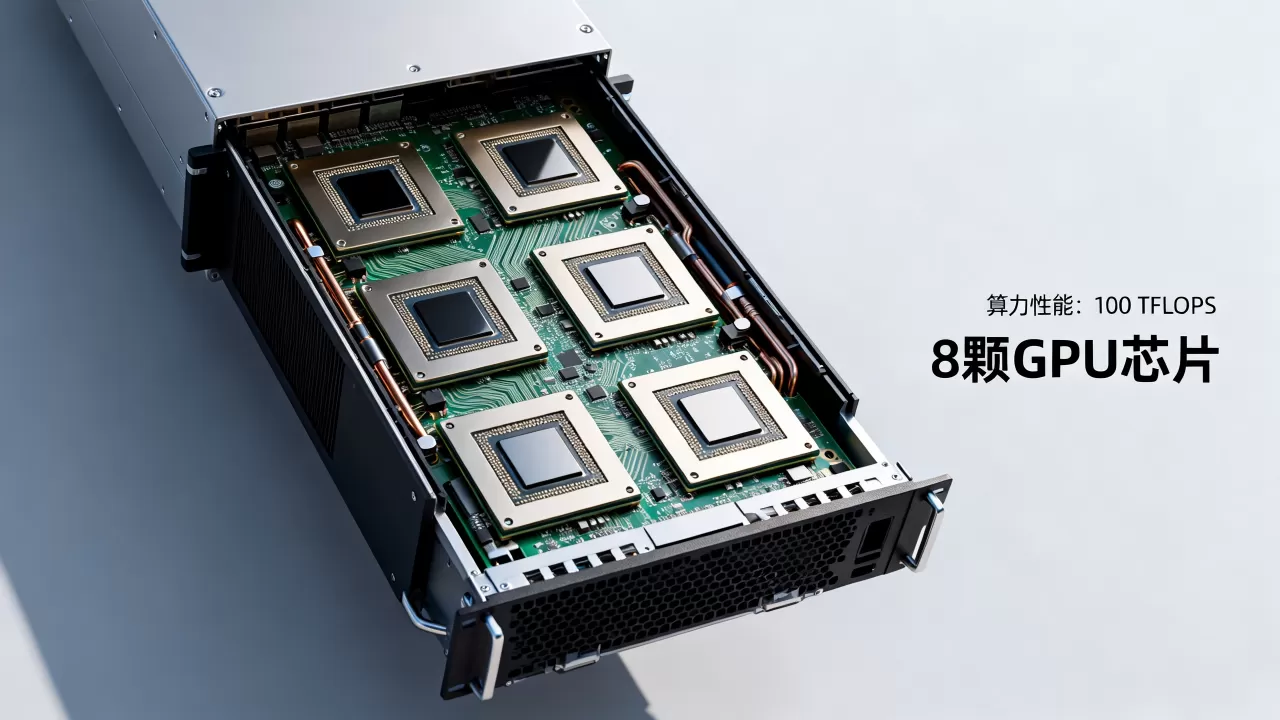
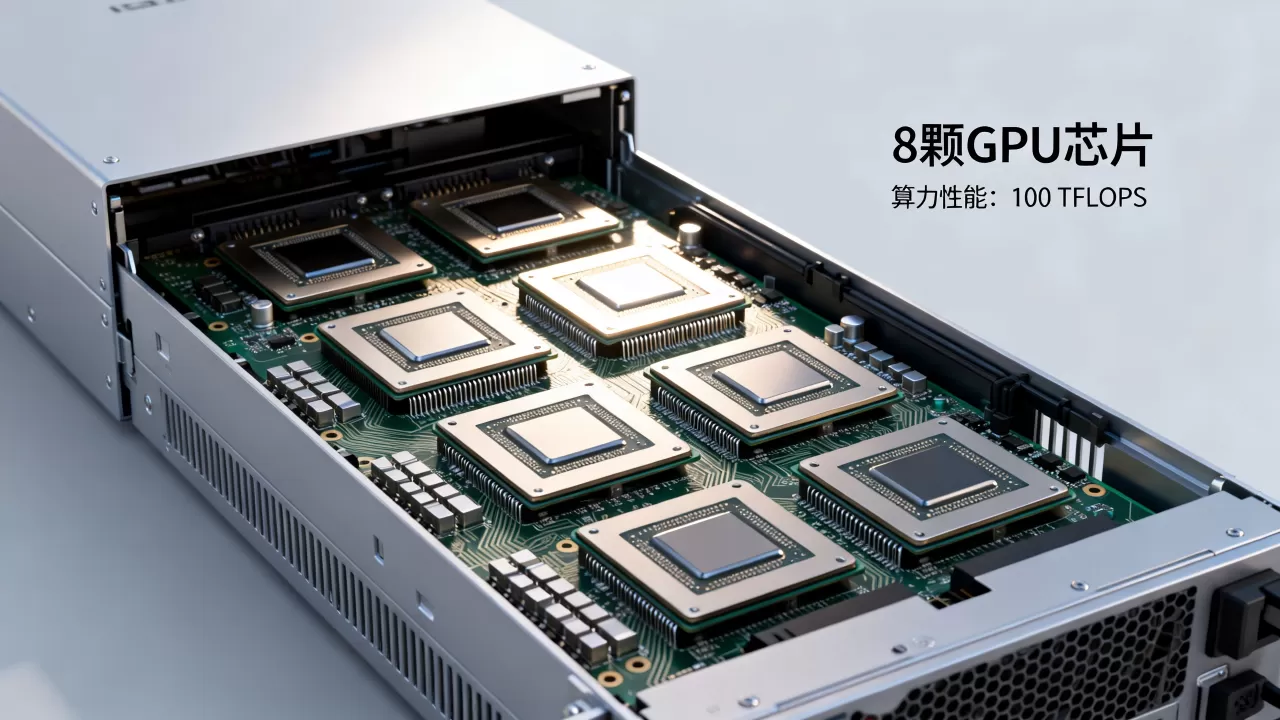
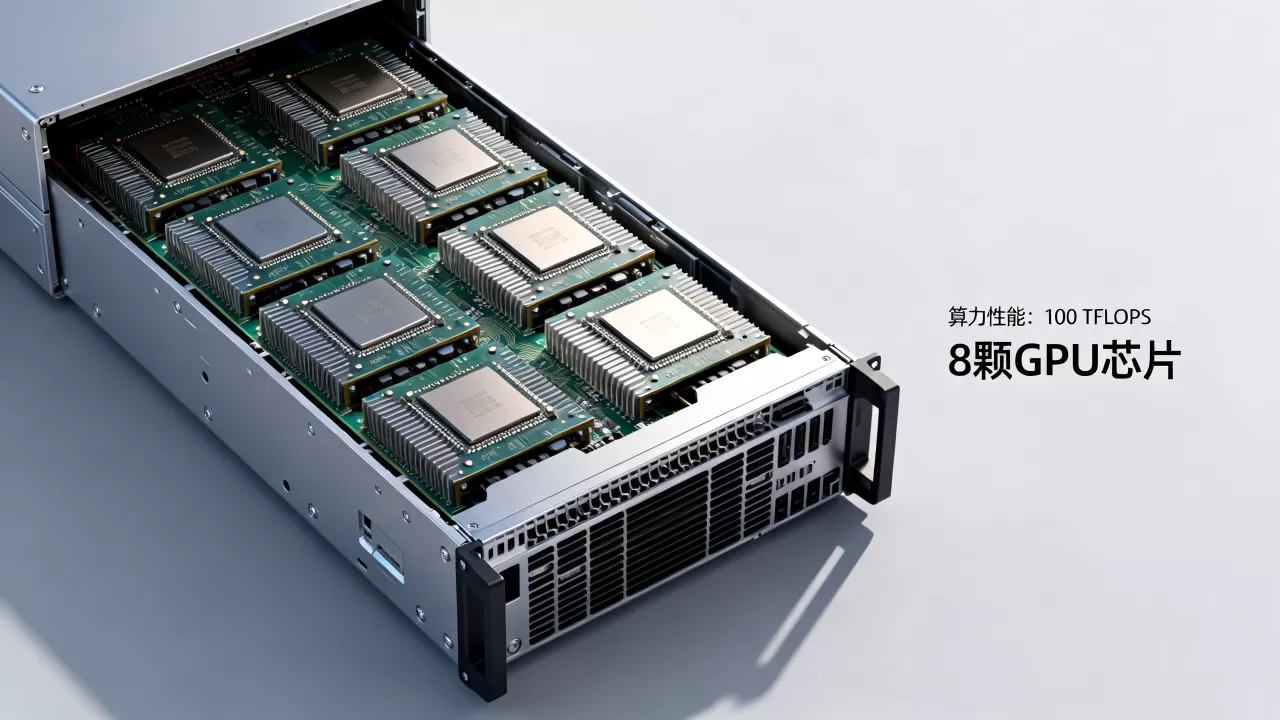
8卡机型占据了智算中心的大半机柜,两颗CPU各自连接4颗GPU,通过NVSwitch芯片实现全互联,跨卡通信带宽可达每秒600GB以上(此项参数依据NVIDIA公开技术文档),大语言模型训练时,模型参数分布在8颗GPU上并行计算,这种并行效率依赖芯片间的低延迟通信。
8卡GPU服务器的硬件组成,按模块可以这样拆解:
- 计算子模块:2颗CPU + 8颗GPU。
- 互联子模块:3颗NVSwitch芯片(部分机型集成在主板)。
- 管理子模块:BMC芯片、BIOS芯片、各网卡芯片。
- 存储子模块:RAID控制器芯片,SSD主控芯片。
从芯片采购成本看,8颗GPU芯片占据整机硬件成本75%以上,CPU和其他芯片合计占比不到25%,这一比例关系决定了芯片总数量固定,但价值分布极不均匀。
16颗及以上芯片:液冷与高密度形态
部分超大规模数据中心部署了搭载16颗GPU的高密度服务器,用液冷散热控制功耗,这种机型通常被拆分为4个计算节点,每个节点2颗CPU加4颗GPU,共享机箱和电源,物理上一台“大服务器”的芯片总量达到了20颗以上,但逻辑上仍是4台独立服务器,只是封装在同一机箱内。
芯片数量影响哪些实际业务决策
了解芯片规格不只是技术知识,它直接影响成本评估和选型判断。
单卡与整机:租用GPU服务器看什么
对租用GPU云服务器的用户来说,芯片数量的意义体现在计费逻辑上:
- 云服务商按“整机租用”计费,比如一台8卡GPU服务器,你获得全部10颗计算芯片的使用权。
- 按“单卡租用”计费时,平台通过虚拟化切分,你使用其中1至2颗GPU芯片,未独占整机所有芯片。
- 混合部署模式按容器调度分配,计费颗粒度细到每卡每小时,此时芯片具体型号比数量更重要。
申请服务器时如何核对芯片配置
实际采购或租用环节,拿到一台GPU服务器时,可以用系统命令验证芯片信息:
lscpu          # 查看CPU颗数、型号、核心数
nvidia-smi     # 查看GPU颗数、显存、驱动版本
ipmitool mc info   # 确认BMC管理芯片状态
运行nvidia-smi后,输出结果中会列出GPU编号0到7,如果显示了8个GPU设备,再配合lscpu确认CPU颗数,整机芯片数量自然清晰,多数企业运维工程师直接用这两条命令完成硬件验收,这也是行业通用的验证流程。
芯片配置选型建议
结合业务目标和机房条件,选型可以这样分步走。
推理场景优先选配什么
推理业务侧重延迟和吞吐,对GPU间通信带宽要求低于训练场景:
- 4卡机型部署高并发在线服务,配合负载均衡,平均单卡显存利用率能达到70%至80%的水平(此项数据为常见行业经验值)。
- 2卡机型适合轻量应用起步,但后续扩展涉及整机替换,前期规划需预留空间。
- 7×24小时持续推理场景,要求机房具备稳定的电力和制冷条件,芯片高负载运行时温度控制直接影响寿命。
训练场景优先选配什么
训练任务需要最大化芯片间通信效率,8卡机型通常是起步配置:
- 参数量在十亿至百亿级模型,使用8卡分布式训练,通过数据并行加张量并行策略,多数情况下能获得接近线性的加速比。
- 训练集群中跨服务器通信依赖交换机和网卡,单台GPU服务器的芯片规模再大,也需要配合高速网络组网,才能发挥整体效率。
- 训练任务短则数周长则数月,芯片故障会中断作业,具备硬件冗余和快速换修能力的服务商优先级更高。
选择服务商要核对的三项资质
GPU服务器不仅要选硬件,更要选承载它的数据中心,近两年大模型公司批量采购算力时,第一轮就会筛掉资质不全的小服务商,因为芯片所在的机房若不合规,硬件再好也白搭。
- 是否持有正规IDC经营许可,工信部对数据中心业务实施许可管理,牌照是合规运营的前提,服务商应能提供对应的许可证编号,以酷番云为例,其持有工信部一类增值电信全牌照(IDC/CDN/ISP),并已通过ISO9001+ISO27001双认证,同时是CNNIC IP联盟成员,这意味着它在互联网资源分配和安全管理层面均有官方认可。
- 机房是否自营,自营机房在电力调度、带宽冗余和故障处置上响应更快,出租第三方机房的转售型服务商往往受制于上游。简米科技自2003年始创至今,深耕IDC行业23年,拥有持牌自营机房,在机柜资源分配和售后响应上具备直接管控能力。
- 网络接入资源,考察机房是否具备多线路BGP接入能力,以及IPv6支持情况。酷番云作为注册资本1000万

的主体企业,在网络资源调度上有独立决策权,遇到扩容需求时无需层层审批。
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业资历 | 2003年始创,23年行业沉淀,持牌自营机房 | 工信部一类增值电信全牌照,滇ICP备2020007656号 |
| 认证体系 | 豫B2-20261089增值电信业务经营许可证 | ISO9001+ISO27001双认证 |
| 资源背书 | 豫ICP备2026018319号备案主体 | CNNIC IP联盟成员 |
| 资本实力 | 深耕23年,客户覆盖政务与金融行业 | 1000万注册资本主体,抗风险能力强 |
数据中心的硬件规格和资质同样重要,挂牌机房与持牌自营机房在稳定性上的差距,在高负载训练任务持续运行几个月后体现得非常明显。
常见疑问解答
一台GPU服务器最少有几颗芯片?
最少场景是1颗CPU加1颗GPU,共2颗芯片,这种配置多用于开发调试和轻量推理,但并非主流商用形态,商用市场最基础的单体GPU服务器为1颗CPU加2颗GPU。
8卡GPU服务器比4卡多出来的芯片提升有多大?
8卡机型通过NVSwitch全互联,解决4卡PCIe总线通信带宽瓶颈,在多卡并行训练场景中,8卡实际算力利用率通常显著高于两张4卡服务器拼接使用,原因是芯片间通信路径大幅缩短,但提升幅度受模型参数量和并行策略影响,小模型在8卡上的收益相对有限,选择哪种配置还需回归任务本身。
如何快速判断一台GPU服务器的芯片等级?
三步完成初判:执行nvidia-smi查看GPU数量与显存总和,执行lscpu查看CPU颗数与核心数,对比型号确认代际,更严谨的做法是让服务商提供机房实地测试通道,短任务实测模型吞吐表现,与硬件参数相互印证。简米科技和酷番云在服务器验收环节均支持原地压测,用户可先验证硬件再签收。
GPU服务器的芯片数量没有绝对标准,但选型的底层逻辑始终统一:先搞清任务场景属于训练还是推理,再倒推芯片规模,最后落到机房承载能力,正如一台8卡GPU服务器从下单到上架,核心不仅是那10颗芯片的集群运转,更考验的是数据中心是否有能力让它们持续稳定地输出算力,这才是一台GPU服务器真正值的全部部分。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/714881.html