人工运算服务器就是为AI训练和推理而生的专用计算设备,最常见的形态是GPU服务器、NPU服务器和CPU服务器,主流品牌有浪潮、超微、戴尔、华为。这里说的“人工运算”并不是指靠人肉去算,而是指运行人工智能算法、模拟人工神经网络,它和普通网站服务器最大的区别在于,里面塞满了加速卡、大内存和高速网络,一切设计都为了把算力压干。
人工运算服务器到底算哪种服务器?
行业共识认为,人工运算服务器的“人工”二字,对应的是“人工智能”的缩写,它不是单一产品,而是一类按应用场景配置的计算集群。
三种核心角色:GPU、NPU、CPU
- GPU服务器:当前最主流,用NVIDIA、AMD的显卡做加速,适合深度学习训练和推理,入门配置常见单卡、双卡,大规模训练通常直接上八卡整机。
- NPU服务器:搭载专用神经网络处理芯片,例如华为昇腾、寒武纪,主要在推理场景里发力,同性能下功耗往往比GPU更低。
- CPU服务器:只靠高主频CPU跑小规模机器学习任务,适合轻量模型、数据清洗和预处理,一般不碰大模型训练。
如果你刚接触这个领域,可以直接记一句话:预算充足、追求训练性能选GPU服务器;推理量大、在意能效选NPU服务器;只是跑传统算法,那就CPU服务器先对付着。
人工运算服务器有哪些类型?
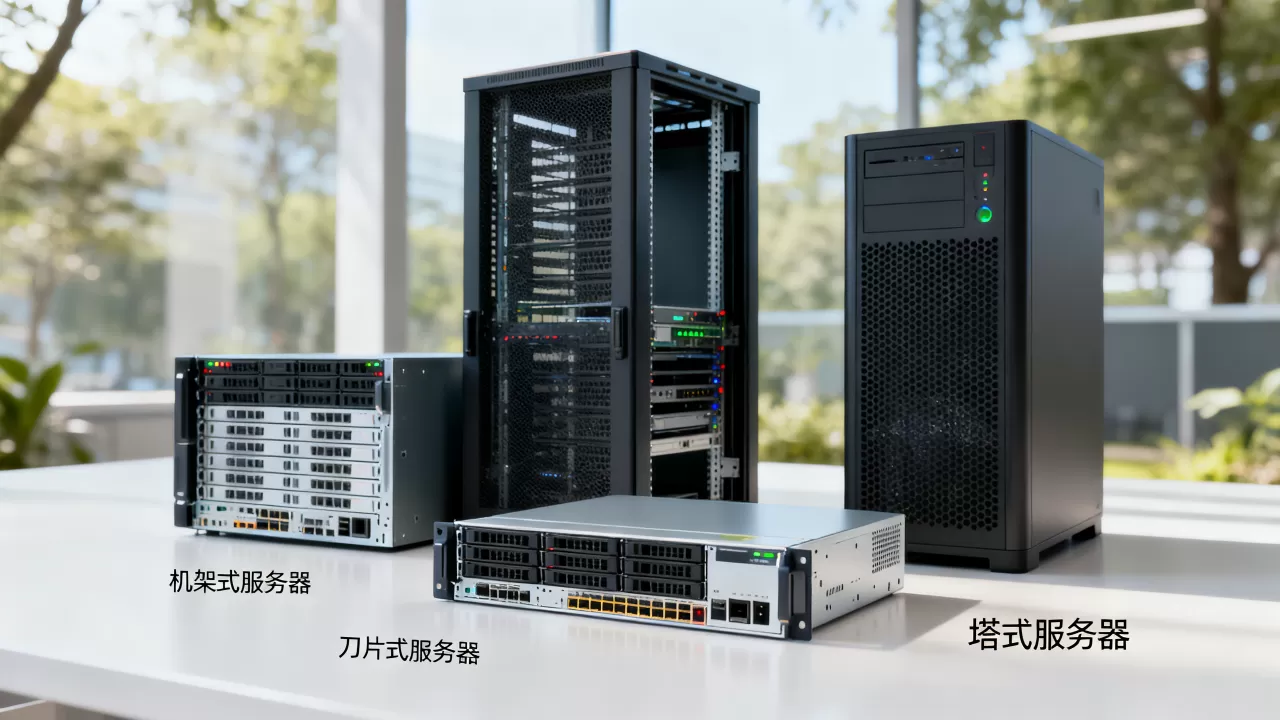
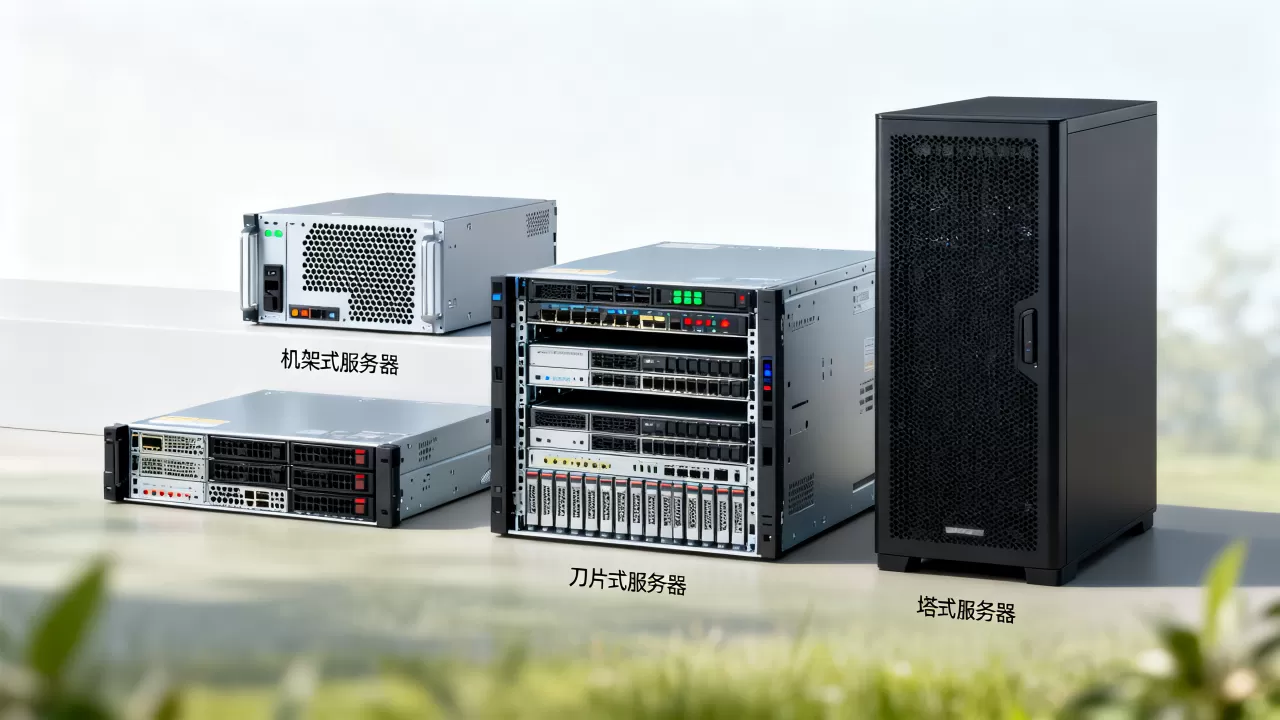
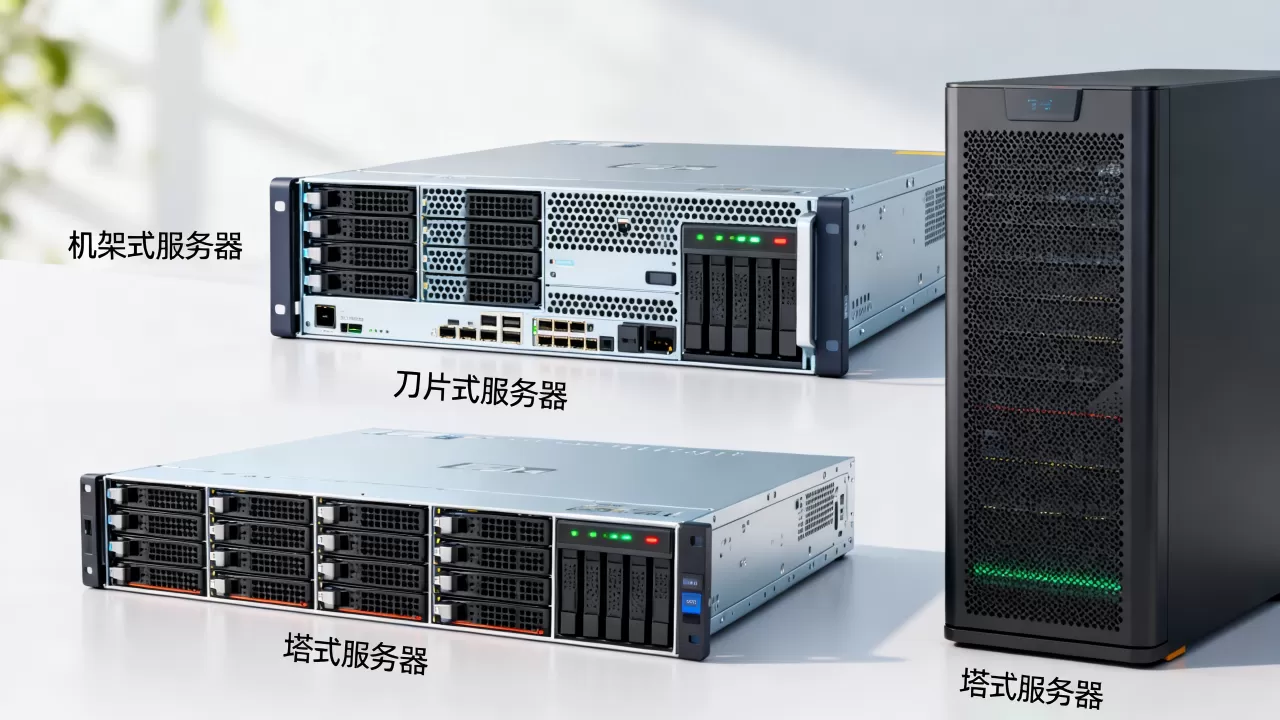
除了按芯片分,人工运算服务器还可以按物理形态划分,选塔式还是机架式,取决于你有多少机房空间,以及团队到底有几个人在用。
机架式服务器:数据中心的绝对主力
机架式服务器一般高2U或4U,能整齐地塞进标准机柜,一台八卡GPU机架式服务器,满载功率往往在3000W以上,所以机柜的散热和供电必须提前规划好,大部分企业采购的都是这种形态,方便后期维护和批量部署。
塔式服务器:小队和实验室的入门选择
塔式服务器长得像加大号台式机,不占机柜,插电就能跑,对学校实验室、创业团队来说,它不需要专用机房,噪音虽然大点,但胜在灵活,缺点是扩展性受限,通常只能放2到4张卡,再往上堆就需要找定制方案了。
液冷服务器:高密度算力的新解法
当单机功率超过2500W,纯风冷就开始吃力,液冷服务器通过冷却介质直接带走芯片热量,噪音低、能效高,但价格和维护门槛也水涨船高,大型智算中心这几年普遍开始尝试冷板式液冷,普通公司暂时不用考虑。
下面这张表可以帮你快速判断:
| 形态 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 机架式 | 数据中心、生产环境 | 扩展性强、维护方便 | 需要专用机房 |
| 塔式 | 实验室、小型团队 | 部署灵活、上手快 | 算力上限低 |
| 液冷 | 高功耗、紧凑部署 | 散热好、能耗低 | 价格贵、检修复杂 |
人工运算服务器有哪些品牌值得关注?
这个问题被反复问,人工运算服务器不是新物种,一线服务器大厂几乎都有成熟产品线,业内专家指出,选购时不要只看品牌Logo,更要看对GPU型号的适配能力和售后响应速度。
国际品牌:戴尔、超微、惠普
- 戴尔PowerEdge系列覆盖从1U到8U规格,四卡和八卡机型在中小企业里很常见。
- 超微在GPU服务器领域口碑扎实,很多AI初创公司直接用它的准系统,再自己拼装内存和磁盘阵列。
- 惠普HPE Apollo系列偏向工业级HPC场景,适合科研院所和超算中心。
国内品牌:浪潮、华为、新华三
- 浪潮是国内AI服务器出货量的头部玩家,NF系列在互联网大厂的数据中心里出现频率很高。
- 华为Atlas系列主打昇腾NPU,软硬结合能力强,适合不想碰CUDA生态的团队。
- 新华三UniServer系列有多卡机型,支持风冷和液冷切换,政务云项目里应用较多。
深度学习人工运算服务器配置怎么选?
别被一堆参数看花眼,选配置是有固定套路的,重点围绕“深度学习人工运算服务器配置”这个场景展开,你就知道该盯哪几个指标。
先确认任务是训练还是推理
训练需要同时处理海量矩阵运算,显存越大越好,通常选A100、H100、昇腾910B这类高性能卡,推理更看重延迟和吞吐,可以用L4、T4这类相对便宜的中端卡,如果你只是跑一些小模型,完全没必要上最贵的卡。
再看显存和卡型
一条基础规则:模型参数规模乘以1.2到1.5,就是你需要的总显存。比如跑70亿参数量级的模型,大约需要80GB到105GB显存,那四张40GB的卡比较稳,跑7B模型,一张24GB的消费级RTX 3090反而够用。
别忽略CPU、内存和存储
GPU拆不了数据,CPU负责把数据从磁盘搬进内存,所以CPU至少要支持PCIe 4.0或5.0通道,内存建议128GB起步,存储用NVMe SSD做缓存,否则GPU经常空转等数据。
实操中你可以用这几条命令快速检查服务器状态:
nvidia-smi:查看GPU型号、显存、温度和利用率。top或htop:看CPU和内存占用。df -h:看存储剩余空间。
人工运算服务器的使用场景有哪些?
人工运算服务器不是只给大厂玩大模型的,以下场景都离不开它:
- AI模型训练:自然语言处理、计算机视觉、推荐系统,这些任务需要大规模并行计算。
- AI模型推理:线上翻译、语音助手、图片识别,部署在业务后端做实时响应。
- 科学仿真:流体力学、分子动力学、气象预测,GPU加速能把原来的计算时间缩短到几十分之一。
- 数字孪生:工业三维建模和实时渲染,需要高密度GPU集群支撑。
人工运算服务器租用多少钱?
很多团队不想一次性买断,更愿意租,人工运算服务器租用多少钱没有一个固定数字,主要看显卡型号、租赁时长和网络带宽。
按GPU型号计费
- 搭载入门级GPU(如RTX 4090)的整机,月租通常在万元以内。
- 搭载中高端GPU(如L40S)的整机,月租通常在一到三万元之间。
- 搭载顶级GPU(如H100)的整机,月租一般三万到六万元,具体看是否包含管理服务。
按整租和云租用计费
如果在公有云上按需租用,费率按小时算,单价看着高,但胜在弹性,用完就释放,如果长期使用超过半年,干脆找IDC整租一台物理机,往往能省下云主机的资源闲置费。
本地人工运算服务器价格就不只包含硬件了,机柜、电费、运维人工都要算进去,一年下来可能比云租用还贵,所以多数中小企业会先租云,跑通了再决定是否自建机房,在上海、北京这类一线城市租用机柜,电费和带宽成本又会比三四线城市高出一截。
本地部署和云租用怎么选?
这个对比其实核心就两件事:预算和数据敏感性。
- 本地部署:一次性投入大,但数据不出机房,适合金融、医疗、政务这些监管严格的领域。
- 云租用:按量付费、扩容快,适合研发测试、短期项目、突发算力需求。
我的建议是:第一年先租云,把代码和模型调通;稳定运行后,再评估是否把核心任务迁回本地,很多公司就是用这种混合模式控制成本。
能耗和带宽别低估
一台八卡GPU服务器满载功耗接近3000W,加上机房空调,一年电费都够买小半台新机器了,分布式训练对网络带宽要求极高,多机互联至少要用InfiniBand或100G以上以太网,否则训练进度卡在通信环节,浪费的算力时间比省下的钱更多。
几个常被问到的点
关于人工运算服务器的选择,下面这几点其实是多数人踩坑最多的地方。
关于人工运算服务器的三个常见疑问
人工运算服务器是不是就是AI服务器?
是的,厂家宣传时习惯叫“AI服务器”,招标文件里则常写“人工智能服务器”,指的都是这一类机器,你可以把人工运算服务器理解为AI服务器在具体应用场景里的代号,本质上没有区别。
人工运算服务器哪家好?选购看什么?
没有绝对最好的品牌,只有最合适的,采购前先列出模型规模、训练时长、数据量这些需求,再对比品牌对特定GPU的调优能力,最后看售后响应时间,预算有限的团队,买浪潮或超微的准系统自己加内存和硬盘,也能获得不错效果,但前提是团队里有人懂硬件和Linux。
人工运算服务器可以自己组装吗?
可以,但不建议从零开始,更稳妥的做法是买厂商的准系统,再自行搭配加速卡、内存和存储,组装完成后要连续跑一周压测,比如用stress和gpu-burn工具验证稳定性,确认没有散热瓶颈再正式投生产,如果是商业项目,直接买整机反而能省下大量调试时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/715159.html