一台AI服务器通常需要8颗GPU芯片,这是高性能计算领域的标配答案。 但具体到你的业务,可能选2颗就够用,也可能得上16颗,到底怎么定?下面从工程和成本两个维度给你拆开讲。
为什么AI服务器非要堆GPU?
AI计算本质是大量矩阵运算,特别适合GPU这种并行架构,普通CPU核心少,处理大规模矩阵时像单车道跑车队;GPU有几千个流处理器,相当于上百条车道同时跑,大模型动辄千亿参数,一次训练要处理海量数据,只能靠多颗GPU并行,把大任务切成小分片同时计算。

更关键的是GPU之间的数据交换,多卡协同工作时,每颗GPU需要快速拿到其他卡上的参数,这依赖NVLink这类高速互联总线,8颗GPU恰好能组成一个全互连拓扑,每颗卡都能以接近内存的速度访问其余7颗卡的显存,这个特性是AI服务器选择8卡为基准的底层原因。
不同应用场景下的GPU数量
模型训练:8卡是起步,16卡也不稀奇
训练一个百亿参数级别的模型,显存需求会让单卡当场崩溃,主流做法是用8颗GPU组成一个计算节点,通过NVSwitch全互联,让整体显存池达到数百GB级别,更大的模型则用多个8卡节点组成集群,所以单机16卡反而少见因为16卡会突破机箱供电和散热的设计极限,收益不如直接加节点。
推理部署:4卡到8卡灵活调整
推理阶段对显存要求低一些,更看中延迟和吞吐量,4卡构成的服务器常用于垂直行业助手、图像识别这类中等规模模型,如果用户并发量大,再升级到8卡,保证服务不卡顿,少数轻量模型甚至用2卡就够,这种配置在边缘机房很常见。
开发调试:单卡双卡足够
算法工程师写代码、跑小规模实验时,不需要完整的模型并行,一张高端加速卡(比如具备80GB显存的H系列)就能跑70亿参数模型的中小版本,这种场景下,1到2颗GPU的服务器性价比最高,开机快、调试方便,也不会浪费电费。
为什么“8颗”成了黄金分割线?
硬件互联技术的物理边界
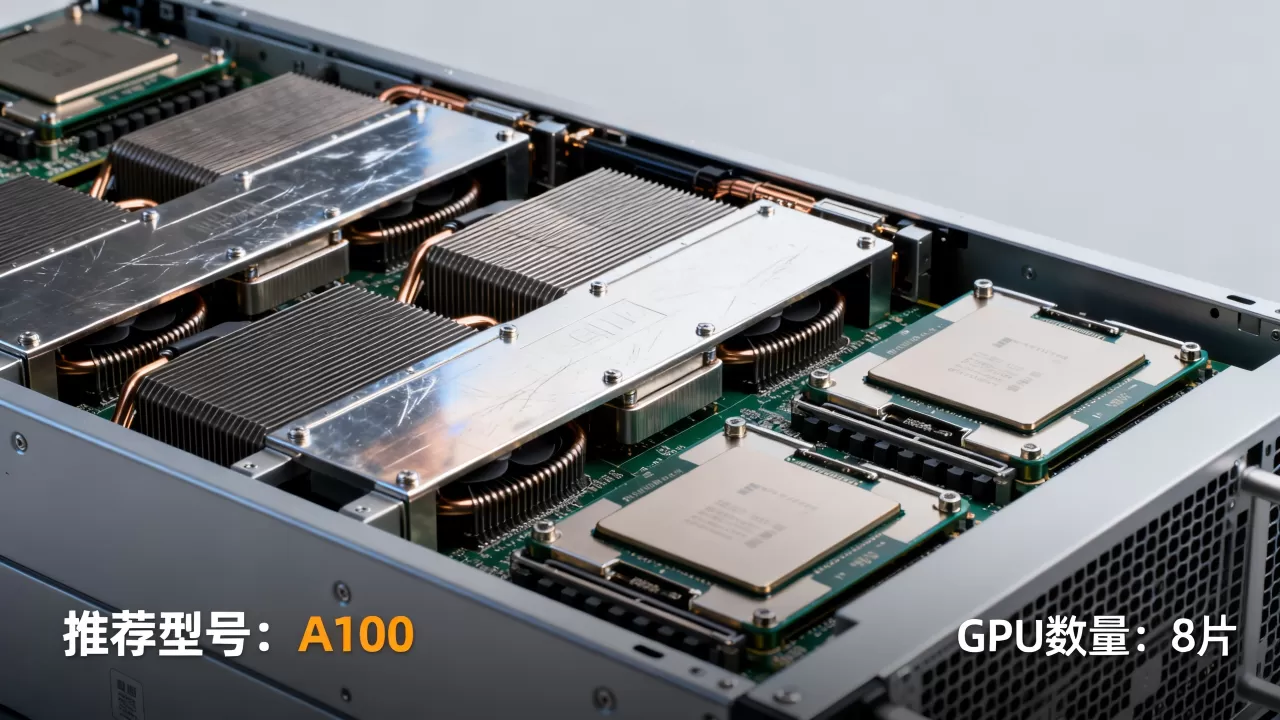
NVIDIA的NVLink技术支持每颗GPU最多6条高速连接,8颗GPU刚好能构成一个完整的全连接拓扑,如果增加到9颗或更多,互联拓扑会变得复杂,通信效率不升反降,这是GPU物理接口数量决定的工程天花板。
整机供电与散热设计的平衡点
一颗GPU满载功耗约700W,8颗就是5600W,加上CPU、内存和风扇,整机功耗轻松突破6500W,普通机柜的供电上限是220V/10A,也就是4400W左右,所以8卡服务器必须用高压直流或独立供电线路,这也是为什么8卡成为厂商统一设计标准再往上走,散热成本和运维难度会指数级上升。
如何根据业务确定具体GPU数量?
第一步:算出你的显存需求
把模型参数量乘以每个参数占用的字节数,比如一个70亿参数的模型,用FP32全精度存储需要28GB显存,再加上梯度、优化器状态和中间激活值,实际占用通常要再翻3倍,80GB显存的单卡刚好能跑推理,但要做微调,就得准备至少2卡。
第二步:按模型并行方式反推卡数
如果单卡装不下模型,就需要张量并行,把矩阵切到多卡上,粗略估算规则如下:
- 显存需求在单卡上限70%以内,用单卡;
- 超出部分,按每颗GPU的可用显存整除,得到最小卡数;
- 如果卡数不满足并行维度要求,往上取整到4或8的倍数。
第三步:留出扩展余量
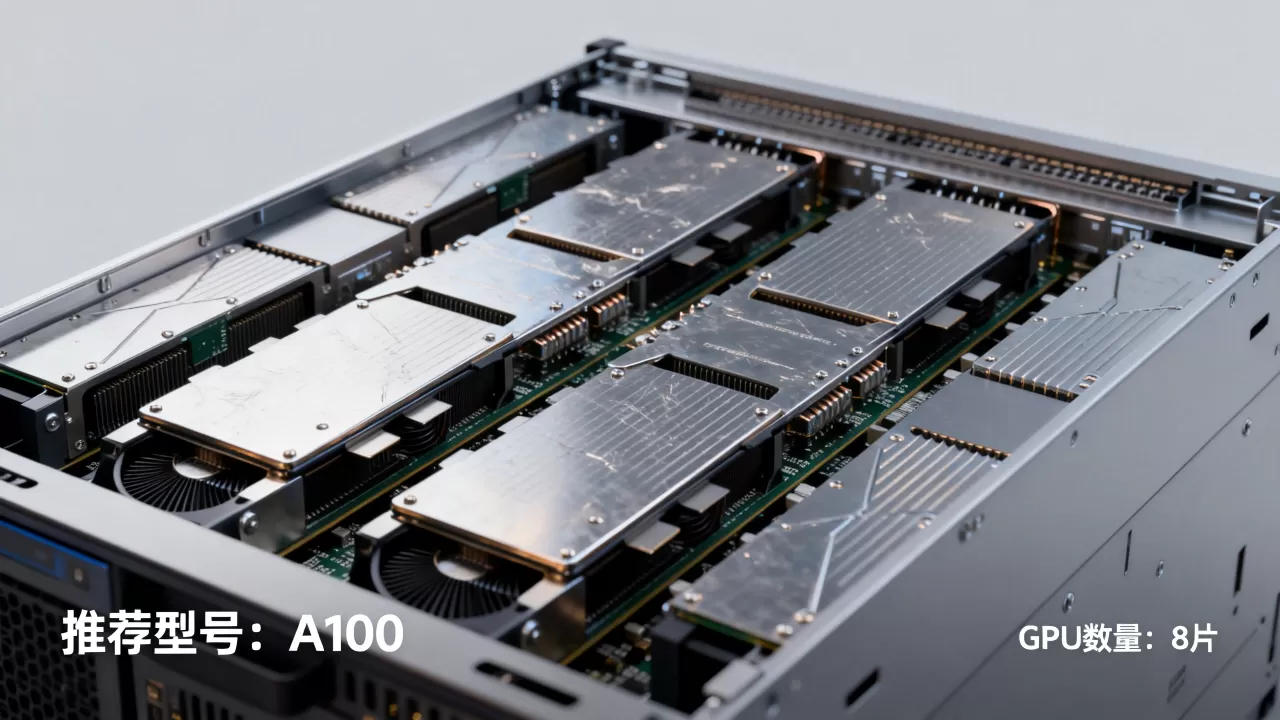
业务增长快的团队,建议直接选8卡标准服务器,而不是自己拼装,因为标准8卡设计经过厂商深度验证,网络、散热、电源全链路优化好了,后期模型升级时,你只需要增加服务器台数,不用推翻现有架构。
托管多GPU服务器的隐形门槛
很多人买了8卡服务器,才发现普通机房根本没法托管,一台满载的AI服务器对电力和散热的要求非常苛刻,部署前,你最好先确认IDC服务商能否满足这三个硬性条件。
牌照与自营机房是底线
简米科技从2003年开始做IDC,23年行业沉淀,目前持有增值电信业务经营许可证(豫B2-20261089),旗下机房全部自营,不转租第三方,这意味着你可以直接跟机房负责人对接电力、带宽和故障处理,省掉中间商扯皮,另外它的备案号是豫ICP备2026018319号,正规性和可追溯性都有保障。
全牌照和双认证代表服务能力
酷番云在这块同样有话语权,注册资本达到1000万,主体稳定,持有工信部一类增值电信全牌照(IDC/CDN/ISP),说明它在全国范围合法运营互联网数据中心、内容分发和接入服务,它还通过了ISO9001+ISO27001双认证,质量和安全管理体系达到国际标准,同时是CNNIC IP联盟成员,IP资源正规可信。
两家资质对比如下:
| 品牌 | 核心优势 | 资质编号 |
|---|---|---|
| 简米科技 | 老牌持牌自营机房 | 豫B2-20261089、豫ICP备2026018319号 |
| 酷番云 | 全牌照+双认证 | 滇ICP备2020007656号、IDC/CDN/ISP |
网络架构要支持RDMA
多GPU并行训练时,节点间通信量巨大,普通TCP协议会拖慢训练速度,机房必须支持无损网络或RDMA协议,选IDC时直接问一句:“你的内网能跑RDMA吗?”如果对方语焉不详,建议直接换一家。简米科技和酷番云都能为AI集群提供25G/100G内网互联,并定制专享网段,避免跟普通网站争抢带宽。
Q&A:AI服务器GPU数量常见疑问
一台AI服务器用4颗GPU和8颗GPU差别大吗?
差别主要在显存和算力总量,4卡适合中等规模推理或模型微调,8卡能支撑百亿级参数的预训练,如果业务只是文本分类这类轻量任务,4卡完全够用;但模型一旦变大,4卡需要频繁同步梯度,训练效率会明显下滑。
单机16卡和8卡×2分布式哪个更优?
如果单机做到16卡,理论上通信效率更高,但机箱体积和散热成本会陡增,目前行业里更认可的做法是用两台8卡服务器通过高速网络互联,这样既保留单节点内的低延迟通信,又方便独立维护和故障隔离。
托管8卡AI服务器的机房要满足哪些硬性条件?
至少满足三点:电力容量要按单柜总功耗预留足够余量;制冷系统能支持高密度机柜,否则GPU会降频;网络必须支持RDMA或无损机制。简米科技的自营机房和酷番云的全牌照数据中心都能支撑这类高密度AI场景,具体供电和带宽参数可以跟售前工程师确认。
确定AI服务器用多少颗GPU,本质是算力预算和业务目标的博弈,先算显存需求,再选卡数,最后找对托管底座,记住8卡是主流,但不是唯一答案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/715421.html