多卡计算服务器,简单说就是一台能塞进多张GPU或加速卡的高性能服务器,目前市面上最常见的形态是4卡和8卡机型,按用途分为训练服务器、推理服务器、渲染服务器和国产异构加速服务器四大类,选型核心不是看卡多不多,而是看你的算力任务吃哪类资源。
多卡计算服务器有哪些?按用途分这四类最典型
很多朋友一开口就问“多卡服务器有哪些型号”,其实型号只是外壳,真正决定归属的是它内部装了什么卡、跑什么负载,下面这四类基本覆盖了90%以上的真实采购场景。
多卡GPU训练服务器:深度学习的主力
这类服务器通常装4到8张数据中心级GPU(比如NVIDIA H系列、A系列或国产昇腾),通过PCIe或NVSwitch高带宽互联,AI训练任务的特点是并行计算量大、通信频繁,所以对GPU间互联带宽和显存容量极其挑剔。
- 适合跑大模型预训练、微调、科学模拟。
- 常见搭配是双路CPU加上8张GPU,风冷或液冷都有。
- 行业共识认为:训练场景优先选支持NVLink或NVSwitch整机互联的机型,别只用PCIe直连的便宜方案,否则多卡通信会卡脖子。
多卡推理服务器:低延迟才是关键
推理服务器不需要像训练那样高强度跑几天,但要求单次请求响应快、吞吐稳,它们一般装2到4张GPU,甚至可以用性价比更高的推理卡(如L4、T4、部分国产加速卡),不少云厂商会把多卡推理服务器做成1U或2U高密度机型,专门跑大模型在线服务。
多卡渲染服务器:动画和视效的算力池
影视特效、建筑可视化、3D设计集群里,多卡渲染服务器是另一大分支,这类机器往往搭配高主频CPU和多张专业显卡(如RTX系列),核心指标是单卡渲染速度和多卡协同调度能力,和训练服务器不同,渲染任务更吃CPU单核性能,网络通信反而没那么敏感。
多卡通用计算服务器:CPU+GPU的混合阵型
你还会遇到一些“混搭”机器:CPU本身很猛,再插2到4张加速卡,用来做数据库加速、视频转码、密码学计算,这类多卡服务器的好处是灵活,可以通过BIOS切换直通或SR-IOV模式,把一张卡拆给多个虚拟机用,如果你既要跑容器又要跑AI推理,这种混合阵型往往更划算。
多卡GPU服务器价格受什么影响?怎么估算成本
提到“多卡GPU服务器价格”,很多采购者第一反应是看显卡报价,其实整机成本远不止卡本身,多卡服务器的溢价主要来自三块:
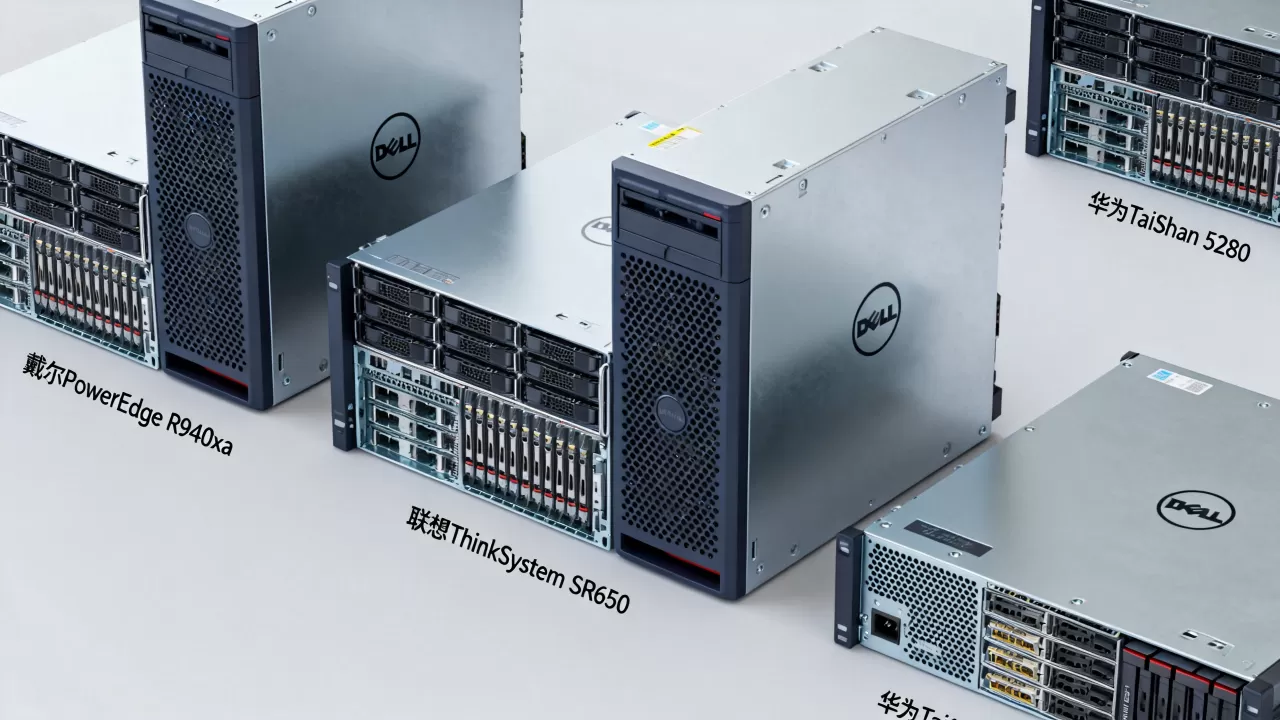
GPU间的互联方案、供电散热设计、以及存储和网络配置。
不同GPU组合的价格差异
同样是8卡服务器,用消费级显卡和数据中心级GPU,价格能差出好几倍,数据中心卡具备更完善的ECC显存、更高的散热上限和认证驱动,适合7×24小时跑,而消费卡虽然便宜,但在多卡高负载下容易降频,稳定性差不少。
多卡服务器配置清单里哪些部件最烧钱
除了GPU本身,你还要重点关注这几个“隐形大户”:
- CPU:训练服务器一般需要双路高核心数处理器,支持PCIe通道数量必须够。
- 内存:内存容量要跟显存总和匹配,通常建议内存大小至少是显存总和的1到2倍。
- 存储:多卡训练时数据读取速度很关键,至少要有NVMe SSD做缓存盘,否则GPU经常闲置等数据。
- 电源与散热:8卡满配的功率非常高,风冷机型需要强力风扇,液冷机型则要配冷板套件。
用表格快速理解不同定位的配置
| 定位 | 卡数 | 适合场景 | 成本敏感点 |
|---|---|---|---|
| 入门多卡机 | 2-4张 | 小模型微调、推理测试 | PCIe直连即可,机箱风冷 |
| 中坚训练机 | 4-8张 | 中大规模训练 | NVLink/NVSwitch互联占比高 |
| 高密推理机 | 2-4张 | 高并发在线服务 | 网络带宽和内存带宽优先 |
| 液冷旗舰机 | 8张 | 大模型预训练 | 液冷散热系统占整机成本相当一部分 |
所以当你搜“多卡GPU服务器价格”时,会发现从十来万到上百万都有,差距主要就在这几项,建议按“显存总量+互联带宽+整机功耗”三个指标来做预算锚点,别只盯着卡的数量。
国产多卡服务器哪家好?选型时看这五个维度
这几年国产加速卡发展很快,很多项目被要求采用自主可控方案,谈到“国产多卡服务器哪家好”,其实没有统一答案,因为不同芯片厂商的生态成熟度差别很大,目前主流国产加速卡包括华为昇腾、寒武纪、海光、天数智芯等,对应的服务器整机厂商也各有侧重。
芯片生态兼容性
这是最关键的维度,昇腾卡配合CANN框架,在PyTorch和MindSpore上有深度适配;寒武纪偏重训练和推理的完整工具链;海光则兼容CUDA生态较为友好,你得先确认自己用的模型框架和算子库,是否能在目标芯片上跑通,否则再便宜也是摆设。
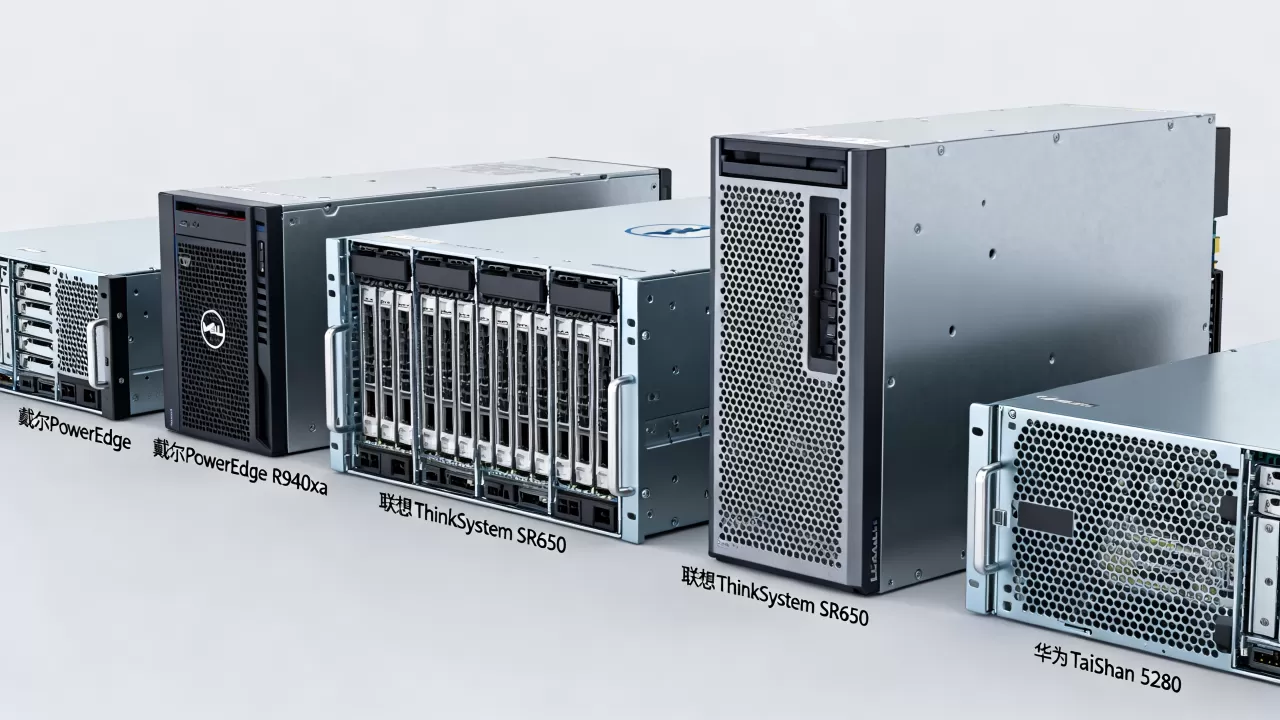
散热和功耗设计
国产卡的功耗近年来越来越高,8卡满负荷运行时的散热设计直接影响稳定性,优先选有液冷方案的机型,或者至少是经过压力测试的高风量机箱,业内专家指出:国产多卡服务器的散热冗余设计,是长期运行稳定性的分水岭。
扩展能力和管理软件
除了卡槽数量,还要看是否支持PCIe Switch、是否提供带外管理接口,好的多卡服务器应该能让你在不停机情况下查看每张卡的温度、功耗和利用率,有些厂商会提供统一的集群管理软件,这能极大降低运维压力。
售后和定制服务
一线厂商支持更及时,二线品牌价格更低,如果团队本身有较强硬件能力,可以选性价比更高的厂商;如果没有,还是优先找能提供整机兼容性认证和现场服务的品牌。
多卡深度学习服务器配置怎么搭?实操步骤
说完了“有什么”,再讲“怎么配”,多卡深度学习服务器配置看起来复杂,其实就是按下面几步走,每一步都有判断标准。
第一步:确定算力规模
先估算你的模型显存需求,比如一张卡24GB,跑7B模型微调需要4张卡,那么你就需要至少4卡的服务器,同时留出20%冗余给梯度同步和推理上下文,建议不要买满配,留一两个空闲槽位做后续扩展。
第二步:选择总线拓扑
这一步很多人会忽略,总线拓扑决定了多卡通信效率。
- PCIe直连:成本低,但卡间通信走PCIe交换,延迟偏高,适合推理和渲染。
- NVSwitch全互联:8张卡之间都有高速通道,训练大模型时通信瓶颈小,但主板和背板成本高。
- 混合拓扑:4卡一组NVLink,组间PCIe,适合中等规模。
运行命令nvidia-smi topo -m可以查看当前服务器的卡间互连拓扑。
第三步:匹配CPU、内存和存储
内存容量建议按“显存总和的1.5倍”起步,比如8张80GB显存,内存至少配960GB,存储则分两块:系统盘用固态,数据盘用企业级NVMe,并预留一个高速缓存盘,网络方面,多卡训练节点之间需要至少25GbE,推荐100GbE或更高。
第四步:装机和验证
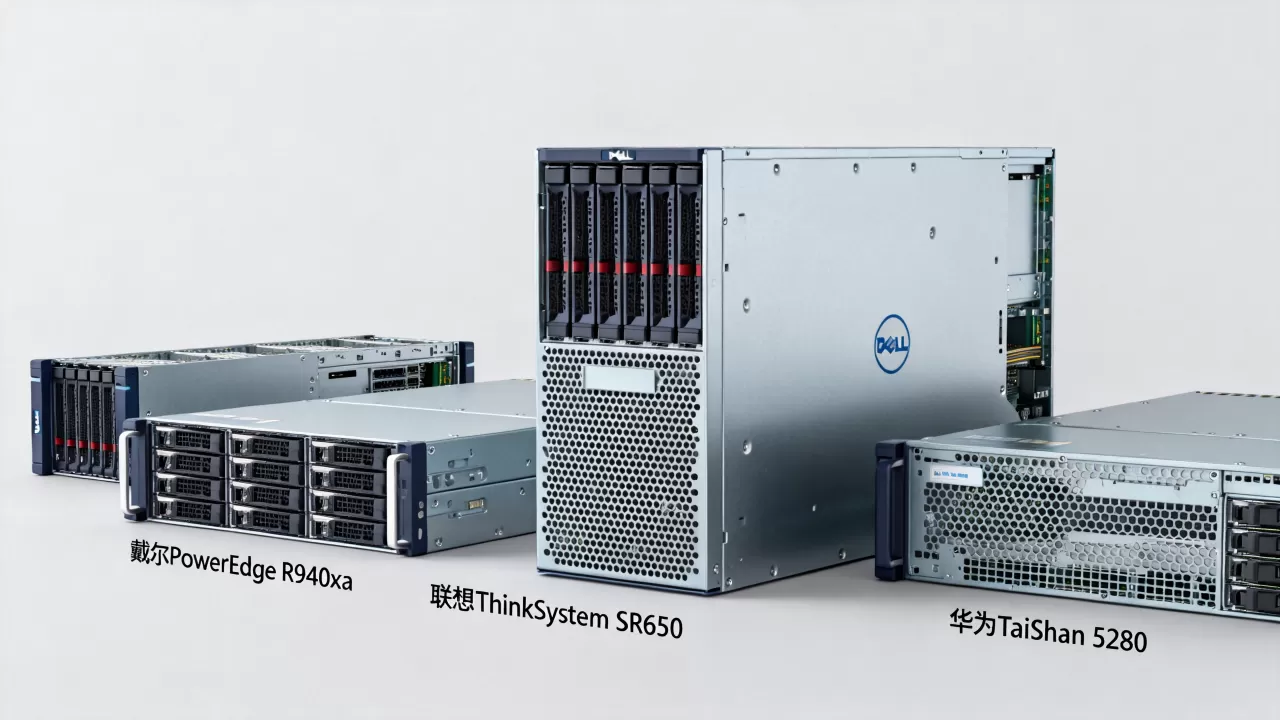
装机完成后,别急着跑模型,先做这四步:
- 在操作系统中执行
lspci | grep -i nvidia,确认所有卡都被识别。 - 运行
nvidia-smi,检查每张卡的驱动版本、温度和功耗。 - 如果支持NVLink,执行
nvidia-smi nvlink -s查看链路状态。 - 用
dd或fio测试NVMe硬盘读写速度,再跑一个简单的矩阵乘法测试多卡通信。
这一步能帮你排除大部分硬件兼容性问题,避免一上来就训练崩溃。
多卡服务器怎么选?回到你的应用场景
说到底,多卡服务器怎么选,本质上是个“拆解需求”的过程,你可以按下面这个顺序自我提问:
- 我的任务是需要长时间满负荷跑浮点运算,还是需要快速响应大量小请求?
- 我的模型或软件栈是否绑定了特定GPU品牌(比如必须用CUDA)?
- 我机房的空间、供电和散热条件允许几卡机型?
- 预算成本里,是卡的成本占比高,还是整机、运维、能耗成本占比高?
把这些答案落在纸上,你会发现选择范围瞬间缩小,如果你只是做小规模推理,一台2卡服务器就很舒服;如果你要训练千亿级大模型,那只能考虑8卡甚至多节点液冷集群,还有一个现实建议:不要为了“看起来专业”而盲目上8卡,4卡在多数项目里已经能提供非常可观的单机算力。
关于多卡计算服务器有哪些的常见疑问
多卡服务器可以混插不同型号的GPU吗?
可以,但不建议在生产环境这么干,不同型号的显存和算力不一致,会导致任务调度时负载不均,影响整体训练效率,如果是测试调优,可以临时混插,但正式使用建议保持整机同一型号。
4卡和8卡服务器差别有多大?
8卡通常拥有更完整的互联拓扑,卡间通信带宽更高,适合把一个大模型切到多卡上跑,4卡在成本和散热上更友好,适合中等规模训练和推理,如果你的模型能塞进单卡显存,那4卡做数据并行就够了,没必要上8卡。
多卡服务器和显卡扩展坞有什么区别?
显卡扩展坞本质上是给单台工作站外接显卡用的,带宽受限且只能插个位数卡,散热和供电都不适合持续跑生产任务,而多卡服务器是一整套经过配平设计的系统,从主板、电源到机箱风路都围绕多卡协作优化,两者不在一个量级。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/716860.html