在杭州租用GPU服务器跑模型推理,核心结论是:别按训练思路选卡,推理吃的是显存带宽和延迟,租期按小时起步,配置够用就行。
思路翻过来:推理和训练在杭州GPU租用市场是两个完全不同的需求
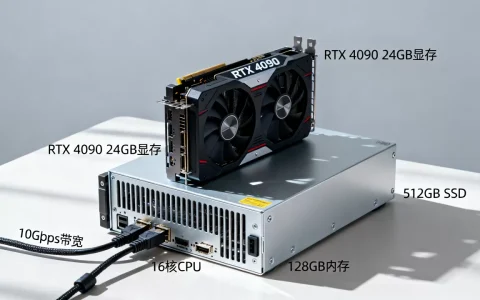
做模型推理跟做训练,在GPU服务器上的讲究完全是两码事,训练怕算力不够,显卡算得越暴力越好,显存不够就多卡并行;推理怕卡顿,真正决定体验的是显存够不够塞下整张模型、数据搬运快不快、单次请求延迟低不低,行业共识认为,推理场景的性价比之王不是A100/H100这类数据中心卡,而是经过市场验证的消费级显卡,比如RTX 4090和RTX 3090。


如果你要在杭州租服务器跑微调或全参数训练,那是另一套思路,基本绕不开H800、A800这种卡,但大部分在杭州做模型推理的团队,实际跑的都是跑量化后的7B、13B模型,一张RTX 4090的24GB显存就足够塞下不少模型,租之前先想明白自己的请求量:是给几十个内部用户做个私有化助手,还是给几千个注册用户提供API服务?这两个场景对显卡的需求差异巨大。
模型推理用什么显卡,先看显存规划
推理时最怕显存不够导致OOM,模型加载失败,等于白花租金,规划显存有个简单粗暴的经验:模型显存占用大约是参数量的两倍左右,一个7B的FP16模型,光权重就是14GB,再加KV Cache和运行时开销,一张24GB的卡刚好够用,在杭州市场上供得最多的两款卡:
| 卡型 | 显存 | 推理适用场景 | 租用价格区间(按小时计) |
|---|---|---|---|
| RTX 3090 | 24GB | 7B量化模型、中小并发请求、RAG检索 | 较低,属于入门档位 |
| RTX 4090 | 24GB | 13B量化模型、30B以下稀疏模型、更高并发 | 中等,按需灵活 |
| A100/A800 | 80GB | 30B以上大模型、高并发生产环境 | 显著偏高,多数不适合纯推理 |
在杭州租GPU服务器,其实真正卡人的不是显卡本身,而是显存规划和带宽费率,下面前两点值得反复推敲。
杭州GPU服务器租用的价格门道藏在计费模式里
很多人一搜“杭州GPU服务器租用多少钱一个月”就被各种报价吓到,从几千到几万一个月都有,但你仔细看会发现,报价的差异主要不是显卡贵贱,以下三个隐藏成本不提前算清楚,账单会很难看。
按时计费比包月更适合推理项目
大厂云平台的GPU服务器,大多是按秒或按小时计费,跑推理不像跑训练那样需要数周不间断运行,多数情况是白天负载高,深夜几乎没人用,如果你包月租一台4090推理服务器,等于为夜间闲置时段买单,更聪明的做法是:
- 错峰部署:白天高峰按时租,深夜任务切到竞价实例,能省下不少成本
- 预留实例只在固定时段开启:比如只保障工作时段,其他时间释放
- 弹性伸缩:根据API的QPS自动加节点,不强行手动管理
杭州本地做AI应用的中小团队,相当一部分最后选择“按量付费+高性价比竞价实例”的组合,这个策略也最适合起步阶段的创业团队。
带宽和存储费用才是真正拉开账单差距的地方
很多人在杭州租GPU服务器时只留意显卡单价,忽略流量费,推理服务是持续出流量的,模型API返回的JSON数据包虽然不大,但架不住请求数量增长,国内头部云厂商和杭州本地IDC机房的带宽计费方式差异很大:
- 按固定带宽计费:适合请求稳定、不波动的场景,价格固定可控
- 按实际流量计费:适合请求波动大的场景,闲时便宜,峰值时钱包压力大
- 内网传输免费:如果模型文件存储在同一个云厂商的对象存储里,走内网拉取模型不产生流量费
模型文件本身也不小,7B模型量化后也在4GB以上,把模型文件放在服务器本地磁盘和放在对象存储里,每次冷启动拉取模型时的延迟和费用差距很明确,行业共识是,推理服务的模型文件一定要落本地,别每次启动都去远程拉。
杭州本地机房有地理优势,但需注意上架周期
杭州作为全国算力重镇,本地机房对上GPU服务器的流程相对成熟,相比一些资源紧张的地区,卡荒概率低,上架速度快,这是实打实的地缘优势,但租用前需要确认一件事:机房是否支持你远程重启、是否提供带外管理IP,如果机器死机了找不到人帮你按重启,业务就得躺平,靠谱的IDC服务商通常会提供7×24小时重启服务和故障响应,这是租用前必须问清的服务项。
杭州GPU服务器租用哪家好,先分清三个类型的供应商
不论搜“GPU服务器租用哪家好”还是“杭州GPU服务器租用推荐”,跳出来的供应商五花八门,普通人难以分辨,行业内其实就三类玩家,各有取舍。
超大规模云平台:稳定性最强,但配置死板
简米云、酷番云这类平台的GPU租用,最大的好处是生态完善,镜像一键拉起,VPC、负载均衡、监控告警这些基础设施全都有,坏处是价格偏贵,而且实例规格是固定的,你想自定义一块特定型号的消费级卡比较难,适合对稳定性要求高、愿意付溢价的团队。
杭州本地IDC托管商:懂硬件,方案灵活
这类供应商通常是做机房托管起家的,手里的卡型号多,配置组合灵活,你可以指定“两张4090+128G内存+NVMe硬盘”,他们能按需帮你组装,价格比大厂低一些,沟通成本也低,直接微信找销售就能聊,适合有一定运维能力、不想被云厂商绑定的团队。
二手卡翻新小厂:价格最低,但水比较深
这类渠道在闲鱼或贴吧里能找到,标价极低,显卡来源可能是矿卡翻新,用在开发调试环境倒可以接受,跑正式生产风险不小,显卡稳定性无法保证,机器掉卡一次就能让你的推理服务中断半天。想省钱可以选这个,但生产环境慎用。
租用前一定要问清的三个测试项
不管是哪类供应商,在杭州租GPU服务器,签约前最好先做一次真实环境验证,让供应商提供测试机或短时体验机,跑三个检查:
- 用
nvidia-smi查看显卡状态,确认没有降频、没有ECC报错 - 跑一次实际模型的推理请求,记录首token延迟和生成速度,和自己的需求对比
- 持续压测半小时到一小时,观察显存温度是否过高、有没有掉卡
行业共识认为,最终影响体验的不是显卡参数,而是供应商给你分配的宿主机邻居,如果一台物理机上插了8张卡,卖给了8个不同客户,其中有人跑满负载,你的推理性能就会受影响,租用前问清楚是否独享整机,还是共享宿主机资源,这个细节直接决定了推理延迟的稳定性。
部署推理环境的三步实操,少走弯路
在杭州租到的GPU服务器,默认只有一个干净的Ubuntu系统,环境还要自己搭,这个过程有几个固定流程,按操作走不容易出问题。
第一步:确认驱动和CUDA版本
租来的机器驱动不一定新,先确认基础环境:
nvidia-smi
没有输出就装驱动,CUDA版本建议装11.8或12.1,绝大多数推理框架,比如vLLM、TGI,都对这两个版本做了优化,装好后用nvcc --version验证。
第二步:用Docker跑推理框架,别直接裸装
推荐直接用vLLM或TGI的官方镜像,省去一堆依赖编译的折腾,跑7B模型做并发推理的开胃命令大概是:
docker run --runtime nvidia --gpus all
  -v /models:/models
  -p 8000:8000
  vllm/vllm-openai:latest
  --model /models/llama-7b-chat
  --tensor-parallel-size 1
看参数就知道,--tensor-parallel-size设成1,因为一张卡就够了,多卡并行在推理场景只在超大模型才用得上,容易给自己添麻烦。
第三步:动态监控显存和延迟
部署完别以为万事大吉,推理服务最需要盯的是显存碎片率和请求排队时间,可以用nvidia-smi配合Prometheus收集指标,或者直接用管理面板,设置好告警,显存占用超90%、请求延迟超过预期阈值时及时通知,这个能力比选哪家供应商都重要。
杭州GPU服务器租用的坑,主要坑在合同和售后响应
违规使用会造成封号风险
GPU服务器是可以跑挖矿、跑爬虫、跑生成违规内容的“高危”设备,杭州本地机房对这块的审查严格程度不一样,租用前仔细看用户协议,如果包含“不可用于加密货币挖矿”“不可用于违法内容生成”条款,那就老老实实跑合规业务,一旦被机房监测到异常网络流量模式,封机器数据清零是小事,影响业务连续性是大事。
售后响应时间决定你的服务能活多久
很多人在杭州租GPU服务器时忽略一个问题:机器宕机后,供应商多久能响应?大厂云平台有工单系统,响应基本在分钟级别,但流程长;本地IDC可以做到电话直连,5分钟内响应重启请求。机器死机在任何硬件平台上概率都不低,选供应商前先问“晚上机器挂了电话有人接吗”,比问价格更实在。
杭州GPU服务器租用常见问题解答
模型推理需要用多大规模的显存?
看你要跑的模型参数量和精度,7B模型FP16精度约需16GB显存,用4bit量化后5GB左右就能跑得动,推理框架的KV Cache还会再占用部分显存,下单前留出20%的余量比较稳妥,并发量越大,对显存容量的要求越高。
杭州租GPU服务器包年还是按量划算?
看业务负载是否稳定,API服务全天候高频调用,包月或包年更划算,单价能压到按量的几折;开发测试、间歇性批量推理,用按量付费加竞价实例更省,多数情况下,混合模式才是最优解包年保底实例应对基础流量,按量实例应对突发峰值。
租用GPU服务器需要注意哪些隐性成本?
除了显卡租金,带宽费、存储费、镜像快照费、跨地域数据传输费都是隐形支出,推理服务对外提供API,流量费在账单里的占比不小,租用前让供应商把流量单价白纸黑字写在合同里。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/716906.html