华为v3服务器查看磁盘状态,核心就三条路:带外管理界面(iBMC)、操作系统内部命令(smartctl/lsblk)以及华为自家的管理工具(FusionDirector),日常巡检直接用SSH登录执行命令行最靠谱。
华为v3服务器磁盘状态查看的方法与核心思路
磁盘状态这件事,放在服务器运维的日常里,优先级一直不低,v3系列服务器在华为的体系里属于均衡型产品,出货量大,部署场景从机房到边缘站点都有,很多维护人员拿到机器第一件事,就是想知道盘到底健不健康,这里的“健康”分两层意思:物理层的通电状态和逻辑层的RAID状态,物理层看硬盘有没有掉线、报错;逻辑层看阵列是否降级、数据是否还在冗余保护之下。
先分清你要看的是哪种“状态”
华为v3服务器磁盘状态粗略划分有五个维度:供电识别、SMART健康度、RAID阵列状态、文件系统使用率、硬盘告警事件,多数情况下,用户问的“怎么看磁盘状态”指的是前三个。
供电识别最简单开机自检阶段,RAID卡或背板会扫描所有槽位的硬盘,服务器前面板的硬盘指示灯,绿色闪烁表示读写,琥珀色常亮说明盘掉了或者预测性报错,部分v3机型支持硬盘热插拔,抽出硬盘看标签,也能判断型号和序列号,但拿不到健康数据。
SMART健康度是操作系统的视角,v3服务器安装了Linux系统后,用smartctl命令直接读取SATA/SAS盘的SMART信息,SSD和HDD的指标不同,HDD主要看Reallocated Sector Count和Current Pending Sector,SSD主要看Media Wearout Indicator和Percentage Used。
RAID阵列状态属于逻辑层面,如果硬RAID卡是华为自家的SR系列,可以通过MegaRAID工具链下的MegaCli64或storcli64查询,软件RAID场景下,mdadm --detail /dev/md0是标准动作。
磁盘smart信息怎么看:从Linux命令行到告警判断
操作系统层面看磁盘,是运维工程师最常走的路径,SSH登录v3服务器后,推荐先执行lsblk和df -h把整体拓扑拿下来,再用smartctl深入体检。
lsblk
df -h
这两条命令能确认系统识别到了哪些盘,以及挂载点的使用率,若某块盘没有出现在lsblk的输出里,说明物理链路或RAID配置出了问题,若盘出现但读写报错,dmesg | grep error能看到内核日志中的I/O异常记录。
smartctl检查步骤分四步
第一步,确认硬盘设备名,SATA盘通常对应/dev/sda、/dev/sdb这样的命名,NVMe盘对应
/dev/nvme0n1,如果机器做了RAID,直通给系统的设备是虚拟盘,SMART信息会从RAID卡透传,部分型号支持,部分不支持。
第二步,smartctl -H /dev/sda,返回PASSED说明SMART整体判定健康;返回FAILED意味着盘的自检已经判定寿命耗尽或可靠性跌破阈值,建议立即更换。
第三步,smartctl -A /dev/sda查看详细属性表,项目很多,重点抓五个:
- Reallocated_Sector_Ct(重映射扇区计数),数值上升说明盘在自我修复坏道,数量持续增加需要警惕
- Current_Pending_Sector(待映射扇区计数),非零意味着盘里存在不稳定扇区,读它的时候可能报错
- Power_On_Hours(通电时长),用于估算磨损周期
- Spin_Retry_Count(电机重试次数),这个指标一旦出现非零值,机械盘基本可以判死刑
- Raw_Read_Error_Rate,SATA盘的标准健康参考项,持续抬升时需要关注
第四步,针对NVMe盘执行nvme smart-log /dev/nvme0n1,重点关注percentage_used字段,这是SSD的“寿命油表”,数值超过100%意味着厂商标称的写入寿命已经耗尽,但实际还能用,只是需要留意随时可能发生的掉盘风险。
行业共识认为,SMART信息是硬盘可靠性的第一道防线,但不可迷信单次输出结果,一次PASSED不代表永久平安,连续监控趋势比看瞬时值更有价值。
通过iBMC带外管理界面巡检物理磁盘
带外管理是华为服务器区别于普通PC的关键能力,v3服务器板载的iBMC管理芯片,独立于操作系统运行,就算系统崩溃、网络中断,只要管理网口通,依然能摸清磁盘状态。
iBMC界面操作路径
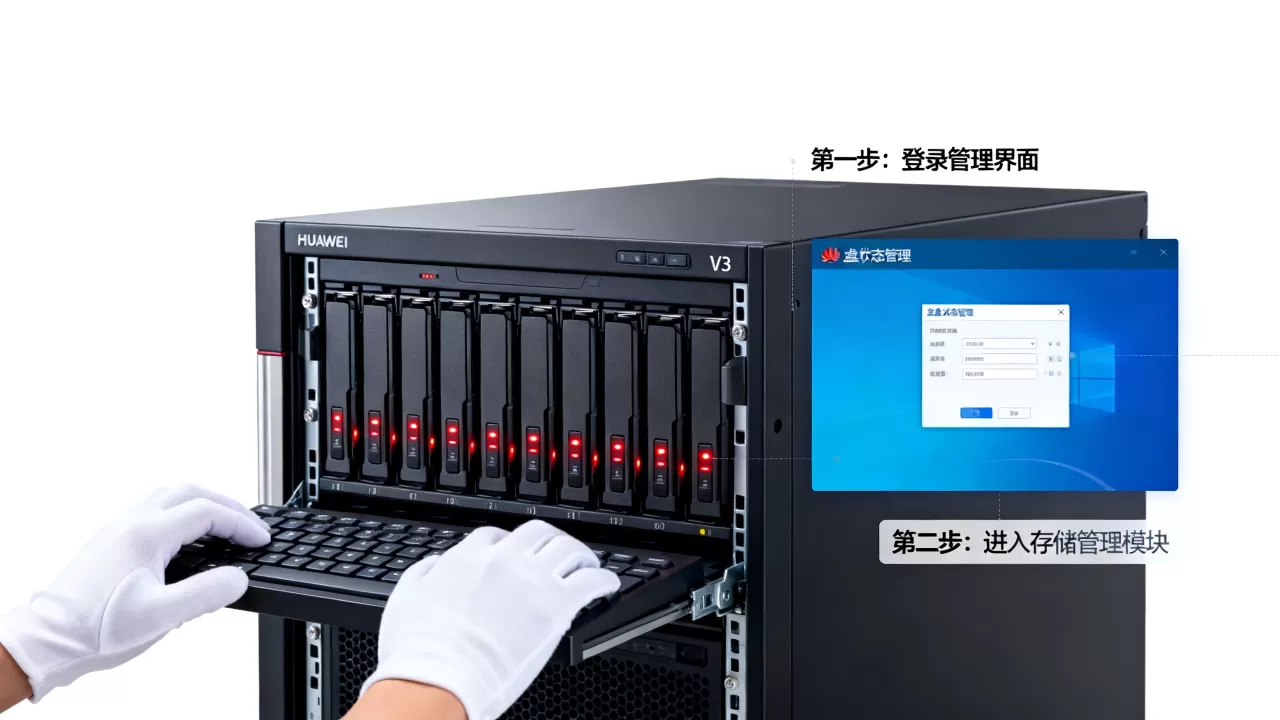
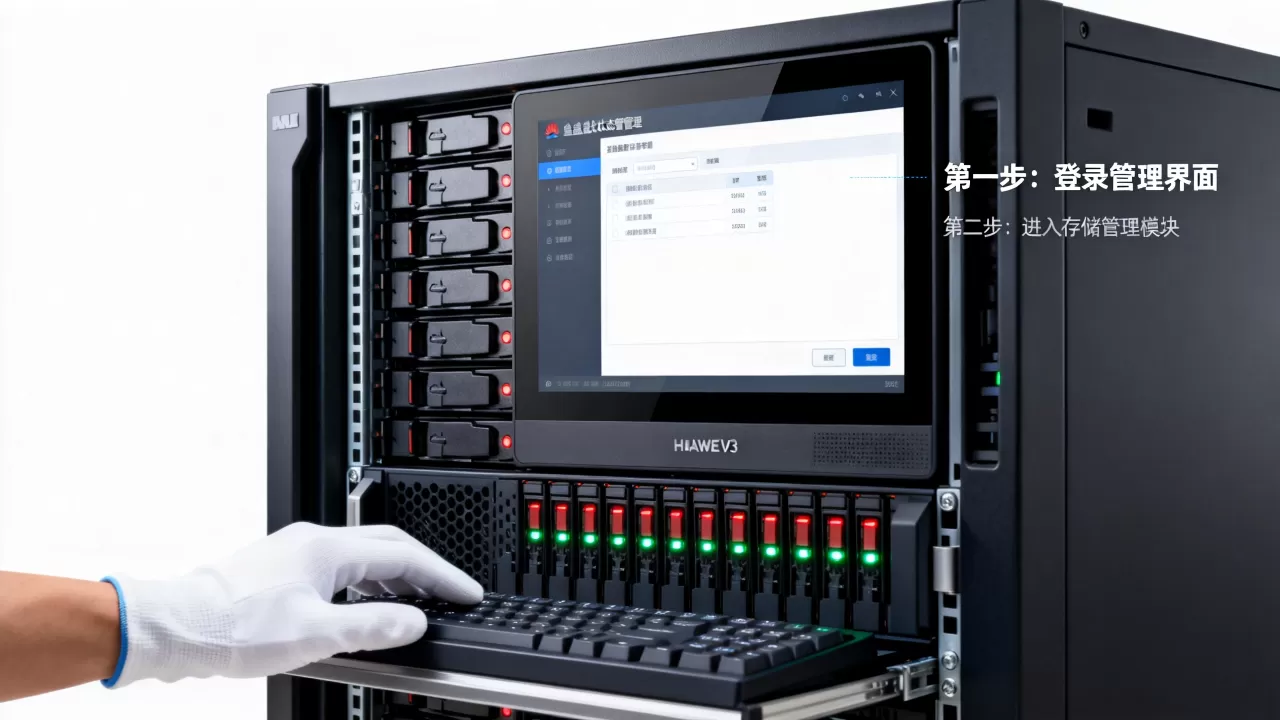
登录iBMC管理地址后,左侧菜单找到“存储”模块,展开“磁盘”,进入“磁盘信息”子页,这里能看到物理盘槽位、容量、型号、固件版本、健康状态和温度,看状态只需要盯两个字段:健康状态显示OK是正常,显示Fault或Warning需要介入;运行状态显示Online是在线,显示Offline或Missing意味着掉盘。
命令行查看磁盘状态的方式
iBMC也开放了SSH和IPMI接口,脚本巡检时直接跑命令效率更高:
ipmitool -I lanplus -H 管理IP -U 用户名 -P 密码 sdr list | grep -i disk
华为的ipmitool版本中,磁盘传感器一般命名为HDD_Status或Disk_Health,读取结果是ok或nr状态,若返回
nr,说明这个盘已经不在正常响应链路上了。
RAID卡层面,iBMC的存储模块也会同步阵列状态,进入“存储 > RAID卡”能看到逻辑盘和物理盘两级树形结构,逻辑盘的状态字段为Optimal是正常,为Degraded表示阵列中至少有一块物理盘失效,在这个界面还能看到Rebuild进度,后台正在重建时,不要强行拔盘或重启机器。
使用华为FusionDirector和MegaCli64高效巡检多个磁盘
v3服务器部署规模一大,单台登录敲命令就不现实了,这时候需要管理面工具聚合查看,华为有这个场景下的公开方案,叫FusionDirector,是数据中心级别的运维软件,能对服务器硬件做批量采集,磁盘健康度、固件版本、寿命百分比这类信息在Web界面就能可视化成列表,出问题时自动标红,它的数据来自每台服务器的iBMC和RAID卡,若要快速掌握某台服务器的磁盘健康概览,优先利用FusionDirector的硬件列表面板,这种方式比逐个登录SSH高效几个量级。
硬RAID卡巡检命令实战
SR系列RAID卡的命令行工具通用性较强。storcli64是较新版本驱动的统一工具,兼容大多数LSI芯片组方案:
storcli64 /call show
storcli64 /call/eall show
第一条显示控制器和逻辑盘状态,第二条显示所有物理盘状态,输出中重点看两列:State列出现UGood是正常;出现Offline、Rebuild、Failed时,说明磁盘状态存在异常。DHS(Dedicated Hot Spare)状态提示当前盘被分配为热备盘,这也是正常现象,无需干预。
MegaCli64在老版本系统中仍有使用空间,命令格式略有不同:
MegaCli64 -LDInfo -LALL -aALL
MegaCli64 -PDList -aALL
前者看逻辑盘,后者看物理盘,PDList输出内容较长,可以在Shell中用管道过滤关键词,比如grep -E "Enclosure|Slot|Firmware state",快速提取盘位状态信息。
磁盘告警后的处理流程与常见误判绕过方式
巡检发现磁盘状态异常,不一定要立即换盘,v3服务器在磁盘报错的处理上有一条标准路径,按顺序排查可以避免很多无效更换。
SMART告警但系统正常运行
这种情况在HDD上很常见,SSD的percentage_used到了100%,但盘体本身还在稳定服务,处理方式是:先备份数据,再观察一周,期间每日记录SMART关键属性,比较数值变化速度,数据备份完成后,可在业务低峰期尝试对SSD做一次安全擦除,让控制器重新整理FTL映射表,擦除后数值仍然增长很快,这就意味着闪存颗粒有体质问题,继续使用会面临突发掉盘风险,建议更换。
RAID阵列告警Degraded
出现Degraded状态,立即确认故障盘的槽位号,去机房现场看指示灯,确认对应槽位的盘是否在正常工作,如果确有硬件故障,热插拔更换同规格硬盘,换上新盘后,阵列会自动开始Rebuild,这段时间不要重启服务器,也不要拔其它盘,重build期间系统性能会明显下降,这属于正常现场表现。
掉盘但物理接触正常
具体表现为某块盘在iBMC中显示Offline,系统里完全找不到,这种情况下,大概率是链路或固件问题而不是盘体损坏,尝试通过iBMC下发一次硬盘重启指令,让盘重新上电,如果指令执行后依然Offline,再检查背板端口是否松动,固件层面的过旧问题也会导致盘偶发性地失联,可在华为的支持官网上查询该型号盘对应的固件版本,做一次原地刷写。
Q&A:华为v3服务器磁盘状态常见疑问
华为v3服务器支持哪些接口类型的硬盘?
v3系列覆盖SATA、SAS和NVMe三种接口形态,SATA和SAS盘主要走背板接RAID卡,NVMe盘直连CPU的PCIe通道,不同机型对NVMe盘的数量支持差异较大,使用前需要确认当前机型的背板是否兼容以及线缆是否插在了正确的端口上。
系统里看不到某块盘,但硬盘指示灯还亮着,这是什么原因?
指示灯亮只能说明供电正常,可能的故障点包括背板端口损坏、硬盘固件卡死、RAID卡未识别到设备,先用iBMC查看槽位是否离线,再进RAID卡BIOS界面扫描设备,确认是卡没扫到还是扫到了但链路不稳定,多数情况下,物理接触不良是主要原因。
风扇转速升高跟磁盘状态有关系吗?
有关系,华为服务器会通过传感器读取硬盘温度,当某个槽位的盘温度超过阈值,iBMC会主动提升风扇转速来加快散热,如果发现某台机器的风扇突然长时间高速运行,可以去iBMC的“传感器”页面查看硬盘温度数据,确认是否存在过热盘,盘温度普遍偏高时,优先检查机房空调和环境通风。
华为v3服务器的磁盘健康检查周期多长一次比较合适?
生产环境建议每天一次自动巡检,用脚本定时执行smartctl读取关键属性和MegaCli64扫描RAID状态,输出结果写入日志文件,每周做一次人工核对,关注数值变化趋势,做不做得到位,不看频率,看趋势追踪是否持续。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/718787.html