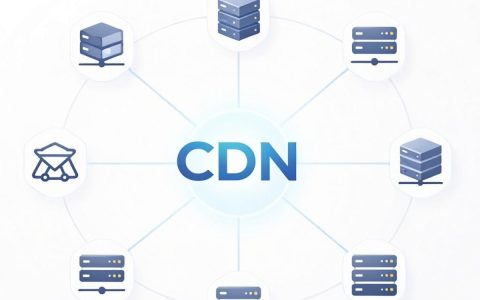
直播间瞬时高并发的接入承压面,核心就在从用户点击到进入房间那几秒内,贯穿DNS解析、CDN边缘节点、负载均衡、接入网关和WebSocket连接管理这五层链路,任何一环掉链子都会直接表现为卡顿、进不去或断流。
接入层承压的核心环节
用户涌进直播间时,流量最先碰撞的是接入层,很多团队把精力放在后端逻辑优化上,结果大主播开播瞬间,还没到业务服务器就先被接入层打垮了,接入承压面其实是一套组合拳,每个环节有各自的脾气。

DNS解析是第一道闸门
用户输入域名那一刻,DNS解析结果决定了用户流向哪个入口,瞬时高并发下,DNS服务器会收到海量查询请求,尤其当直播平台使用自建DNS时,很容易出现解析超时或返回缓慢,行业共识认为,大部分直播平台会选择多家DNS服务商做智能分流,但在极端流量面前,域名解析的TTL设置往往成为隐患,如果TTL设置过长,调度系统无法快速摘除故障节点;设置太短,又加重了DNS服务器的递归查询压力。
实操层面,建议将核心直播域名的TTL设置在60秒到120秒区间,同时开启HTTPDNS或内部DNS缓存,让App端绕过运营商Local DNS的调度故障,很多资深架构师在实际排查时会发现,用户反馈”打不开直播间”的故障里,有相当一部分是运营商DNS缓存了过期记录导致的。
CDN边缘节点的容量天花板
CDN是接入层的第一道物理屏障,负责就近分发静态资源和视频流,但CDN边缘节点也有扛不住的时候,特别是晚八点黄金档,多个大主播同时开播,热门城市的边缘节点带宽会迅速被打满,这里的承压点不只是带宽,还有边缘节点的并发连接数,一台边缘服务器能维持的TCP连接数是有限的,通常在几万到十几万这个量级。
当边缘节点过载时,用户会经历“进了直播间但画面一直转圈”的情况,处理办法是提前做容量预估,根据大主播历史峰值数据乘以1.5到2倍的冗余系数,向CDN厂商预购带宽资源,如果是自建CDN,还需要在边缘节点部署过载保护,让节点在CPU使用率超过80%时自动拒绝新建连接,防止雪崩式的全节点瘫痪。
四层负载均衡与七层网关的分工
CDN后面通常是LVS或Nginx Stream模块这类四层负载均衡,负责将TCP流量分发到后端的接入网关集群,四层负载均衡的瓶颈主要在于
连接跟踪表大小和SYN队列长度,瞬时高并发下,如果SYN队列满了,新连接会直接被内核丢弃,表现就是用户点击进入直播间后一直转菊花。
七层网关则是接入层的业务入口,负责鉴权、协议解析、限流等,这里需要重点关注的是连接建立速率,不是并发数本身,一个网关实例每秒能处理的新建连接数量有限,通常在几千到一万左右,当每秒新建连接请求超过这个阈值,网关的CPU就会飙升,响应时间急剧恶化。
直播间高并发架构设计的关键取舍
架构设计没有银弹,接入层的方案选择直接决定了高并发下的表现,行业内比较成熟的路径是分层解耦,让每一层只干一件事。
连接管理节点独立部署
把WebSocket连接管理单独拆出来做成无状态集群,是直播间高并发接入的核心设计思路,客户端与网关建立长连接后,连接状态统一保存在Redis或内存网格中,网关节点本身不保存用户状态,这样做的直接好处是,网关节点可以随意扩缩容,扩容时新节点自动加入服务发现,流量通过一致性哈希或轮询策略平滑分发。
实际项目中,会遇到长连接存活探活的问题,客户端断网、杀进程、切换Wi-Fi都会让连接处于半开状态,如果网关不及时清理这些死连接,会白白占用内存和文件描述符,建议设置30秒到60秒的心跳间隔,连续三次心跳未响应就主动断开,释放连接资源。
消息分发遵循读写分离原则
接入层收到弹幕、点赞、礼物等上行消息后,不直接写入数据库,而是投递到消息队列中,由下游的消费者异步处理,这样做是为了避免高并发写入把数据库打爆,同时保证接入层的处理速度不受下游抖动影响。
下行消息的分发则是广播模式,接入网关从消息队列拉取聚合后的消息批次,再批量推送给房间内所有连接,这里要注意推送的合并策略,比如每100毫秒合并一次消息批次,减少系统调用次数,能显著提升单机的推送吞吐量。
容量预估与实践中的数字
业内专家指出,做容量预估时不能只按日活用户数来算,要按峰值在线用户数乘以三到五倍来设计接入层容量,比如某平台公布日活1000万,晚高峰在线300万,大促直播时突然涌入500万用户,这时候接入层就要按峰值预留。
在资源成本方面,自建机房的单台裸金属服务器承载的WebSocket连接数约50万到80万,如果使用公有云虚机,单台承载量会打折扣,大约在20万到40万,带宽成本是最容易被忽视的,视频流下行带宽占据整个接入带宽的80%以上,弹幕和信令只占很少一部分,所以接入层的成本大头在CDN和带宽,而不是服务器计算资源。
直播间卡顿怎么解决
从接入层角度看,卡顿的成因可以分为三类:连接建立慢、数据传输丢包、服务端处理瓶颈,针对这三类问题,有对应的优化路径。
连接建立阶段的加速手段
- 启用TCP快速打开,在TCP握手阶段携带数据,减少一次RTT。
- 使用TLS 1.3会话恢复机制,避免每次重连都做完整握手流程。
- 在客户端预创建WebSocket连接,用户点击进入直播间时直接复用已建立的连接,省去握手时间。
- 合理设置连接超时时间,建议3秒左右,超过就快速失败并重试下一个节点,避免用户长时间等待。
数据面传输的优化方向
直播间的数据传输链路是用户侧到边缘节点,再到源站集群,边缘节点与源站之间如果走公网传输,晚高峰时段的丢包率会明显上升,解决思路是搭建专线或使用云厂商的内部网络,让边缘回源走内网链路。
WebSocket本身是基于TCP的,TCP在弱网环境下的表现并不理想,近年来,一些头部平台开始引入WebTransport或QUIC协议来传输信令和弹幕数据,利用UDP的多路复用特性避免队头阻塞,如果技术栈暂时不支持QUIC,可以优化TCP参数,比如调整初始拥塞窗口、开启BBR拥塞控制算法,实测在丢包环境下能有效提升传输效率。
接入层服务的降级预案
高并发场景下,保证核心链路可用比功能完整更重要,接入层需要预设降级策略,比如在压力过大时,自动关闭弹幕拉取功能,只保留视频流和礼物消息,礼貌但有效。
弹幕降级不是直接不给用户看,而是降低拉取频率,从实时推送改为每2秒轮询一次,在用户无感知的情况下为后端减压,如果压力进一步加大,可以启动流量染色机制,只将部分用户转发到完整服务集群,其余用户进入轻量级接入集群,保证所有用户都能进入直播间观看画面。
从接线源头做防护的实用经验
接入层还要考虑恶意流量和异常请求的干扰,秒杀直播间经常会被脚本用户疯狂点击,这些请求的特征与正常用户明显不同,比如建立连接后不发心跳包、连接建立时间集中在同一毫秒级别。
防护措施可以在接入网关做四层过滤,比如限制单IP的并发连接数不超过50个,超出后直接拒绝;也可以做七层过滤,检查User-Agent、请求频率等特征,接入层还可以设置全局的令牌桶限流,每秒只放行一定数量的新建连接请求,确保后端服务不会被瞬时流量冲垮。
扩容操作要形成标准动作,提前制定好扩容SOP,包括云资源申请脚本、预置镜像、负载均衡权重调整步骤,在大促活动前,演练一次全链路压测和扩容流程,以免真正出事时手忙脚乱。
直播间接入面常见问题排查
问了:直播间瞬时涌入上千人,进不去的用户看到白屏,可能是什么原因?
连接建立阶段出了故障,大概率是七层网关的连接速率达到了上限,或者是后端鉴权服务在高压下响应过慢,可以先看网关的连接数和响应时间指标,再检查鉴权服务所在机器的CPU和数据库连接池占用情况。
问了:WebSocket连接数没到上限,但弹幕延迟却很高,怎么定位?
问题大概率出在下游的消息队列消费环节,可以观察消息队列的堆积量,如果积压消息数量持续增长,说明消费者处理不过来,可能是房间聚合计算逻辑消耗过大,也可能是下游写入的存储出现了瓶颈,接入层本身压力不大时,优先排查消费链路而不是继续堆接入节点。
问了:直播高峰期服务器CPU还有余量,却频繁出现用户掉线,怎么回事?
大多是连接探活机制与负载均衡的会话保持策略配合出了问题,检查一下负载均衡的会话超时时间,如果它的空闲超时时间短于应用层的心跳间隔,就会先把空闲连接断了,客户端还没发出心跳,服务端就主动踢掉了,确保负载均衡的超时时间设置为心跳间隔的两倍以上。
接入层的承压能力决定了直播间的体验下限,把DNS到网关的每个环节都做扎实,比盲目堆机器更管用,把接入层的每一层都做成可观测、可降级、可快速扩容的独立单元,就能在流量洪峰到来时稳稳接住。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/718883.html