美颜特效渲染对服务器GPU算力的占用,不是固定值:它由特效栈、分辨率、帧率、并发路数和GPU架构共同决定,轻量磨皮美白可能只占用较小算力,而AI人像分割、3D贴纸、4K高帧率叠加后,单卡并发能力会明显下降。
美颜特效渲染对服务器GPU算力的占用大吗?先拆渲染管线
把服务器GPU想成一个后厨:CUDA核心是灶台,显存是备菜台,NVENC是打包窗口,美颜特效不是一道菜,而是一整条流水线,主播画面进来后,每一步都在抢GPU资源。
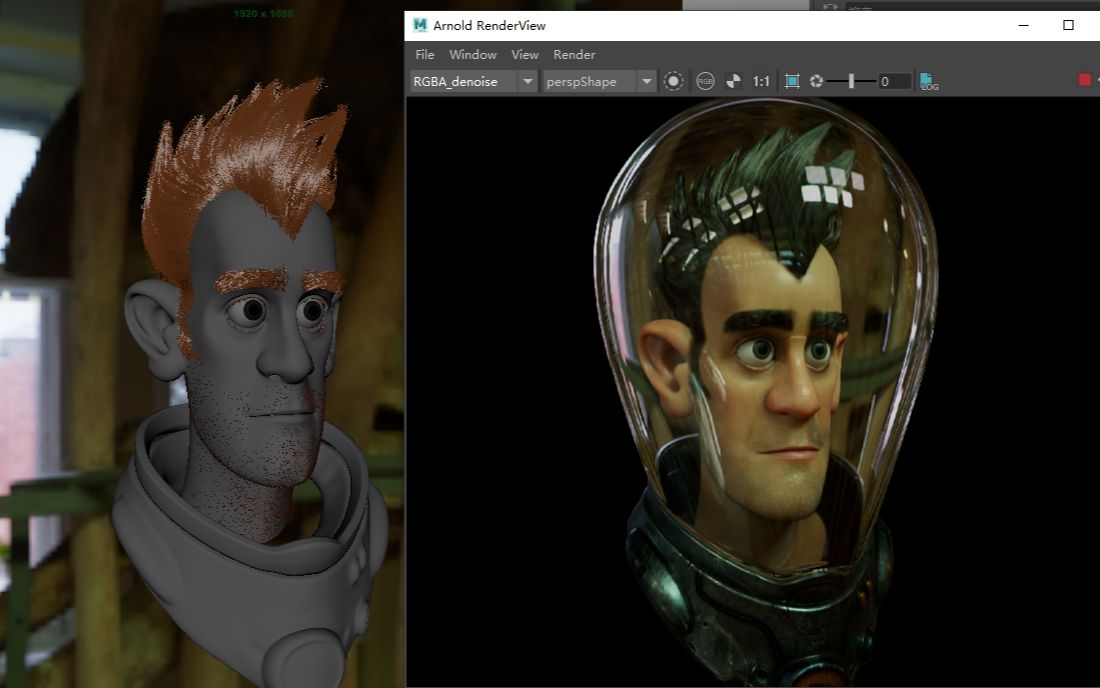

从采集到推流,GPU在哪些环节干活
- 视频采集与解码:拉流、解码、色彩空间转换,用NVDEC时,解码器独立工作,但数据仍要进显存。
- 人脸检测与关键点:定位五官、轮廓、手势,模型越复杂,Tensor Core和显存带宽压力越大。
- 图像增强与美颜:磨皮、美白、红润、锐化、滤镜,多数走Shader,像素吞吐高时吃CUDA和显存带宽。
- 背景分割与虚化:人像分割、发丝分割、背景替换,AI推理密集,通常比普通滤镜更吃算力。
- 贴纸、美妆、AR:3D贴纸、粒子、光效、虚拟妆容,渲染层多,混合复杂,容易拉高GPU占用。
- 编码与推流:H.264/H.265编码,NVENC数量有限,多路并发时可能先于CUDA核心成为瓶颈。
哪些特效最吃GPU
- 磨皮、美白、基础滤镜:单层Shader,开销相对低,但1080p60和4K下像素量暴涨。
- 瘦脸、大眼、美型:需要网格变形和纹理重采样,中等开销。
- 人像分割、背景虚化:AI模型推理,显存带宽和Tensor Core占用高。
- 3D贴纸、粒子、光效:多次渲染和混合,叠加后开销非线性增长。
- 多特效同时开启:不是简单相加,多次纹理读写、显存拷贝、批处理等待,会放大占用。
单路占用不是固定值,场景差异很大
| 场景 | 分辨率/帧率 | GPU主要压力 | 并发能力相对表现 |
|---|---|---|---|
| 语音直播+轻美颜 | 720p30 | Shader、编码 | 较高 |
| 秀场直播+美颜滤镜 | 1080p30 | Shader、NVENC | 中等 |
| 电商直播+人像分割 | 1080p30 | AI推理、显存带宽 | 较低 |
| 短视频批量渲染+3D贴纸 | 1080p60 | 渲染、AI、编码 | 低 |
| 4K虚拟人+AR | 4K30 | 全管线 | 很低 |
据中国信通院公开资料,实时音视频与AI推理的算力需求持续增长,放到美颜特效场景里,增长最快的往往不是磨皮,而是分割、贴纸和超分。
直播美颜特效服务器GPU租用价格怎么算?成本项拆解
GPU型号和显存带宽决定单价
- 推理卡:T4、L4、A10、A100等,编解码器数量、显存、架构不同。
- 消费级卡:4090等单卡强,但虚拟化、保修、机房适配有差异。
- 显存:分割模型、贴纸纹理、批处理缓存都吃显存,显存不足会直接限制并发。
- 带宽:多路高清视频读写,显存带宽和PCIe带宽可能先满。
- 编码器:NVENC是独立单元,路数一多,编码可能比推理更早排队。
云GPU按量还是包月
- 按量计费:适合活动、测试、波峰,停止实例后GPU费用通常停止,但存储和公网IP可能继续计费。
- 包月包年:适合稳定并发,单价更低,但资源闲置也花钱。
- 竞价实例:便宜,可能被回收,不适合强稳定直播。
- 地域差异:一线城市机房延迟好,带宽和电力成本高;中西部电价低,但要实测公网延迟。
- 隐藏成本:加卡、迁移、运维、故障切换、监控告警,都要算进总账。
价格之外,延迟和并发才是隐藏成本
很多团队只看单卡单价,上线后发现单卡跑不了预期路数,加卡后,CPU、PCIe、交换机、带宽又成瓶颈,直播场景对延迟敏感,GPU利用率冲到高位后,排队抖动会直接变成画面卡顿,业内专家指出,美颜特效的GPU开销并不平均,磨皮美白和滤镜通常比AI分割便宜,真正难的是多特效叠加后的显存带宽和编码器压力。
深圳美颜特效渲染服务器GPU算力怎么选?关键指标与优化顺序
先测单路,再算并发
- 固定输入:1080p30,包含人脸、美颜、滤镜、贴纸。
- 用
nvidia-smi dmon观察GPU利用率、显存、编解码。 - 用
dcgmi dmon看SM、Tensor、NVENC占用。 - 逐步叠加路数,直到端到端延迟超过业务阈值。
- 记录单路占用和瓶颈单元,而不是只看总GPU利用率。
- 估算公式:可并发路数 ≈(目标GPU利用率上限 – 基础占用)/ 单路占用。
- 留出余量,应对特效升级、热点活动、流量突增。
优化GPU占用的实操路径
- 模型量化:FP16、INT8,配合TensorRT。
- 动态批处理:Triton Inference Server配置
dynamic_batching,设置max_queue_delay_microseconds。 - 零拷贝:GPU解码到GPU推理,减少CPU往返。
- 编解码:FFmpeg启用
-hwaccel cuda -c:v h264_nvenc。 - 降分辨率/抽帧:人脸检测可隔帧,美颜渲染保持每帧。
- 特效分级:按用户等级、网络状况动态关闭3D贴纸。
- 容器调度:Kubernetes申请
nvidia.com/gpu,或用MIG切分。 - 监控:Prometheus加Grafana采集DCGM指标,设置显存和编码器告警。
美颜特效渲染用云GPU还是自建显卡服务器划算?
| 维度 | 云GPU | 自建显卡服务器 |
|---|---|---|
| 初期投入 | 低 | 高 |
| 弹性 | 强 | 弱 |
| 长期稳定高负载 | 成本可能高 | 成本可能低 |
| 运维 | 云厂商承担 | 自己承担 |
| 适合场景 | 波峰、测试、多地部署 | 稳定大规模、团队有运维能力 |
如果业务波动大、上线急、需要多地就近接入,云GPU更灵活,如果长期稳定高负载,且团队能管机房、电力、带宽和备件,自建或混合云可能更省,行业共识认为,按单路成本反推,比只看单卡单价更可靠。
美颜特效渲染GPU算力占用Q&A
美颜特效渲染对服务器GPU算力的占用大吗?
看特效栈,轻量磨皮美白加滤镜,占用相对小;AI人像分割、3D贴纸、4K高帧率同时开启,占用会显著上升,多数情况下,先到瓶颈的是显存带宽、NVENC或PCIe,而不是CUDA核心数量。
直播美颜特效服务器GPU租用价格怎么算?
通常按卡时或包月,价格由GPU型号、显存、CPU内存、带宽、地域、是否独享决定,按量适合直播波峰,包月适合稳定并发,把单路GPU占用、并发路数、延迟阈值一起算,才能得到可用的单路成本。
美颜特效渲染用云GPU还是自建显卡服务器划算?
波峰明显、上线快、地域分散,云GPU更灵活;长期稳定高负载且团队有运维能力,自建或混合云可能更省,总拥有成本包括GPU采购、机房、电力、带宽、运维和空闲浪费,最终由业务负载曲线决定。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/719299.html