服务器出错的原因涵盖硬件故障、软件配置错误、网络链路异常和安全攻击四大层面,其中软件配置和资源耗尽在日常运维中占比最高。解决服务器问题,首要任务是分清故障发生在哪一层,再对症下药。
硬件层故障:最直观但并非最高频的出错源头
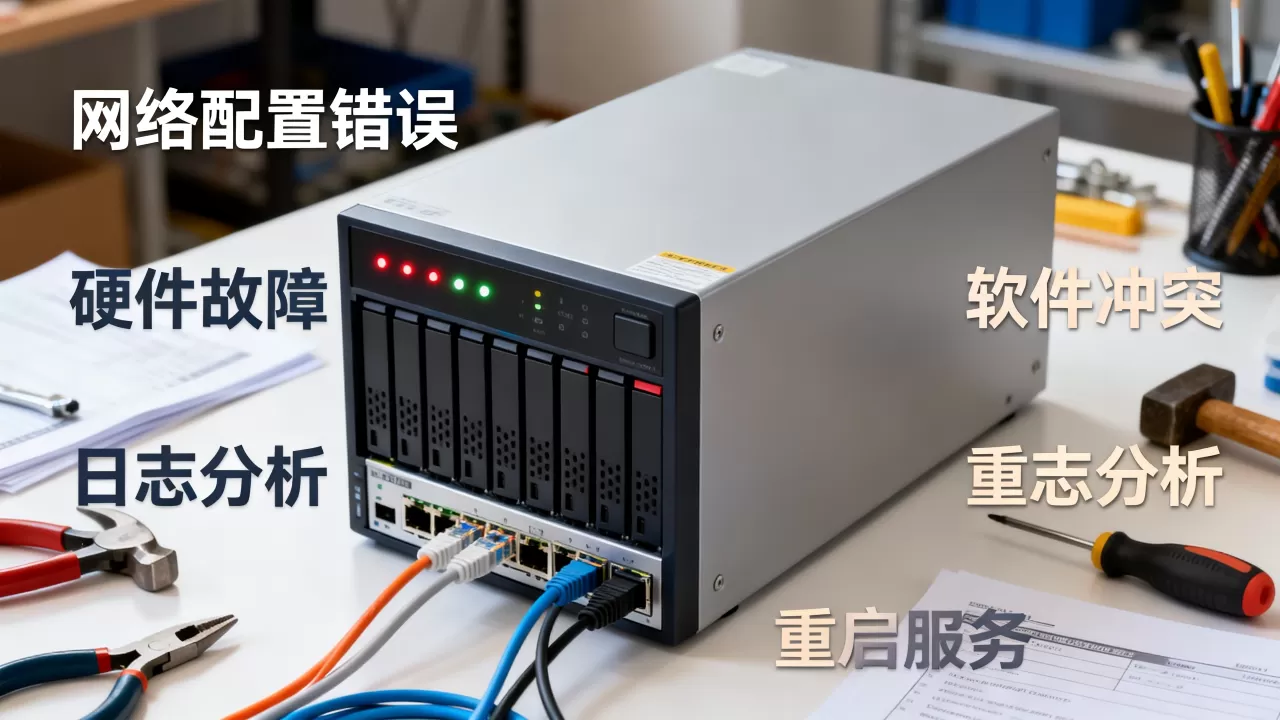
硬件故障在服务器出错原因中占比不高,但一旦发生,往往直接导致服务完全不可用,常见的硬件问题集中在以下几个部件。

电源与散热:物理层面的第一道坎
机房环境温度过高或电源模块老化,容易触发服务器的过热保护或断电重启。服务器电源模块是易损件,尤其在高温季节故障率明显上升,散热风扇积灰或转速异常,也会造成CPU降频甚至宕机,排查硬件故障最简单的做法是查看服务器前面板的状态灯和系统日志,比如戴尔iDRAC或惠普iLO管理界面里记录的硬件告警信息。
硬盘与内存:数据安全的两大命门
硬盘坏道是硬件故障中出现频率最高的问题,尤其是机械硬盘运行三到五年后,当系统日志频繁出现I/O错误,或者存储阵列降级时,基本可以断定硬盘出了问题,内存故障则比较隐蔽,表现多为随机性死机或服务进程无故崩溃,这些硬件故障用系统自带工具就能初步判断,比如运行smartctl -a /dev/sda查看硬盘健康度,或通过memtest86检测内存稳定性。
CPU与主板:少见但影响致命
CPU烧毁或主板电容鼓包,属于极端场景,多由雷击、供电不稳或超频不当引起,这类问题普通用户排查难度较大,需要借助硬件检测工具或送修处理。
软件配置与资源耗尽:服务器宕机原因排查的重灾区
相当一部分服务器出错,根源不在硬件,而在于操作系统、应用服务或中间件配置不当。软件层面的问题更具迷惑性,因为表面看服务器还活着,但服务就是响应不了。
磁盘空间与inode耗尽:最常见的无声杀手
日志文件未做轮转切割,或者数据库临时文件膨胀,很容易把磁盘写满,Linux系统磁盘使用率达到100%时,服务会报错但系统仍能运行,此时排查起来格外棘手,更隐蔽的是inode耗尽,即使
df -h显示还有空间,但df -i显示100%占用,文件压根创建不出来,推荐做法是监控这两项指标,并配置自动清理策略。
内存溢出与Swap颠簸
Java应用或数据库进程发生内存泄漏,会导致系统频繁使用Swap交换分区,进而引发性能断崖式下跌,这类问题在网站服务器不稳定怎么解决的讨论中,属于最常见的技术归因,排查方法可用free -m查看内存余量,再用top按内存排序定位进程,必要时分析堆转储文件。
Web服务与数据库配置不当
Nginx或Apache的worker_processes设置过小,扛不住高峰期并发;MySQL的max_connections设得太低,连接数一多就报”Too many connections”,这类配置问题通常无需重启服务器,调整配置文件后执行nginx -s reload或重启数据库服务即可生效。
网络与链路:服务器500错误原因中容易被忽略的环节
网络问题引发的服务器出错,症状常与软件故障混淆,客户端访问超时,未必是服务端处理慢,也可能是链路中途出了问题。
带宽跑满与丢包
峰值时段带宽跑满,或IDC机房出口链路出现丢包,会造成服务响应极慢甚至超时,查看iftop或sar -n DEV能确认带宽使用情况,若有攻击流量或爬虫过度抓取,需要配合防火墙或CDN进行流量清洗。
DNS解析故障与链路劫持
域名解析错误、解析记录被篡改,或本地DNS缓存污染,都会导致用户无法访问服务器,这类问题的排查路径是先用dig或nslookup检查解析结果,再逐段测试从客户端到服务器的链路连通性。服务器500错误原因有时候并不在服务器本身,而在于链路中某个节点的问题。
机房断电与BGP路由收敛
所在机房意外断电或BGP路由发生异常收敛,会导致整个IP段不可达,这类问题用户端难以干预,只能等待机房恢复,或通过多线BGP、异地容灾方案来规避。
安全攻击与恶意负载:服务器不稳定不可忽视的外部因素
外部攻击是服务器出错的另一大诱因,其特点是突发性强,且伴随明显的流量或进程异常。
DDoS攻击与CC攻击
DDoS攻击通过流量拥塞使服务器无法响应,CC攻击则瞄准应用层,用大量请求耗尽CPU和数据库连接池,行业共识认为,近年来DDoS攻击的规模和频率都在持续上升,中小企业站点的防护能力普遍偏弱,接入高防IP或CDN清洗是主流的应对方式,同时建议在服务器层面配置iptables或fail2ban封锁异常IP。
入侵后门与挖矿木马
服务器被植入后门或挖矿木马,CPU占用率会长期处于高位,系统负载异常飙高,排查时关注top中占用过高且名字可疑的进程,查/etc/crontab有无异常定时任务,再用ss -antlp确认是否有外连可疑地址,这类问题需及时切断外联并修复漏洞,防止再次被入侵。
应用层代码缺陷
高并发下,代码中的死锁、未捕获异常、慢SQL查询等缺陷会被放大,最终拖垮服务器,这类问题定位难度最大,需要结合日志和链路追踪逐步分析。
常见故障排查操作的实用清单
处理服务器出错问题,咨询服务器托管多少钱一台这类方案之前,先掌握一套标准排查流程更有价值。
- 按顺序检查电源指示灯、网络指示灯、系统负载三件事
- 用
uptime查看1分钟、5分钟、15分钟负载趋势,判断是持续高压还是突发抖动 - 用
dmesg -T | tail -20查看内核日志中是否有OOM或硬件报错 - 用
df -h和df -i确认磁盘空间与索引节点余量 - 用
top或htop定位CPU和内存占用最高的进程 - 用
tail -f /var/log/nginx/error.log或对应应用日志查看实时错误输出
不同出错场景的应对思路对比
| 故障特征 | 大概率原因方向 | 首要操作 |
|---|---|---|
| 服务器直接断电重启 | 电源模块、机房供电 | 检查硬件告警灯,联系机房 |
| 服务间歇性超时 | 配置不当、带宽跑满 | 看带宽曲线,压测服务 |
|
页面返回500错误 | 应用代码或后端服务 | 查看应用日志栈信息 |
| 磁盘写满后服务崩溃 | 日志未轮转、数据膨胀 | 清理大文件并配置日志切割 |
| 无故重启且系统日志无异常 | 内存故障、内核panic | 跑内存检测,查看kdump日志 |
Q&A:关于服务器出错原因的常见疑问
服务器频繁宕机需要检查哪些方面?
优先排查硬盘坏道、内存稳定性和散热环境,这三者引发的宕机通常没有明显预警,若硬件无明显异常,再检查内核日志是否出现OOM(内存耗尽)或Call Trace信息,并关注是否因流量攻击导致资源耗尽,重点确认系统日志的断电时间点,若集中在同一时段,可能为机房供电问题,可参考同机柜其他服务器的状态判断。
网站服务器不稳定怎么解决才更有效?
先明确不稳定的具体表现,是随机掉线、响应慢,还是特定时段故障,根据表现分类排查:掉线看网络与硬件,响应慢看资源占用与应用日志,特定时段故障看是否存在计划任务集中执行或流量高峰,定位到根因后再针对性优化,避免盲目重启或无目的地调参,若为持续资源不足,才考虑升级配置或迁移至服务器托管服务。
服务器托管费用与故障处理能力有关联吗?
两者有一定关联但并非绝对,价格较高的数据中心通常配备更完善的电力冗余和网络多线路接入,一定程度上降低因物理环境引发的服务器出错概率,但软件层的问题,无论选择何种价位的托管服务,都需要自身运维能力支撑,托管商一般只负责硬件与网络的可用性,不介入应用层排查,选择价位时,对比的重点应放在电力SLA保障、网络稳定性以及工单响应时效上。
服务器出错的根因往往不是单点问题,硬件、软件、网络、安全四个维度互相影响,日常运维中建立监控告警、日志留存、定期巡检三项机制,绝大多数故障都能在萌芽阶段被拦截,遇到问题时,按照从硬件到系统、从网络到应用、从资源到代码的顺序逐层排查,多数故障都能快速定位。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/719307.html