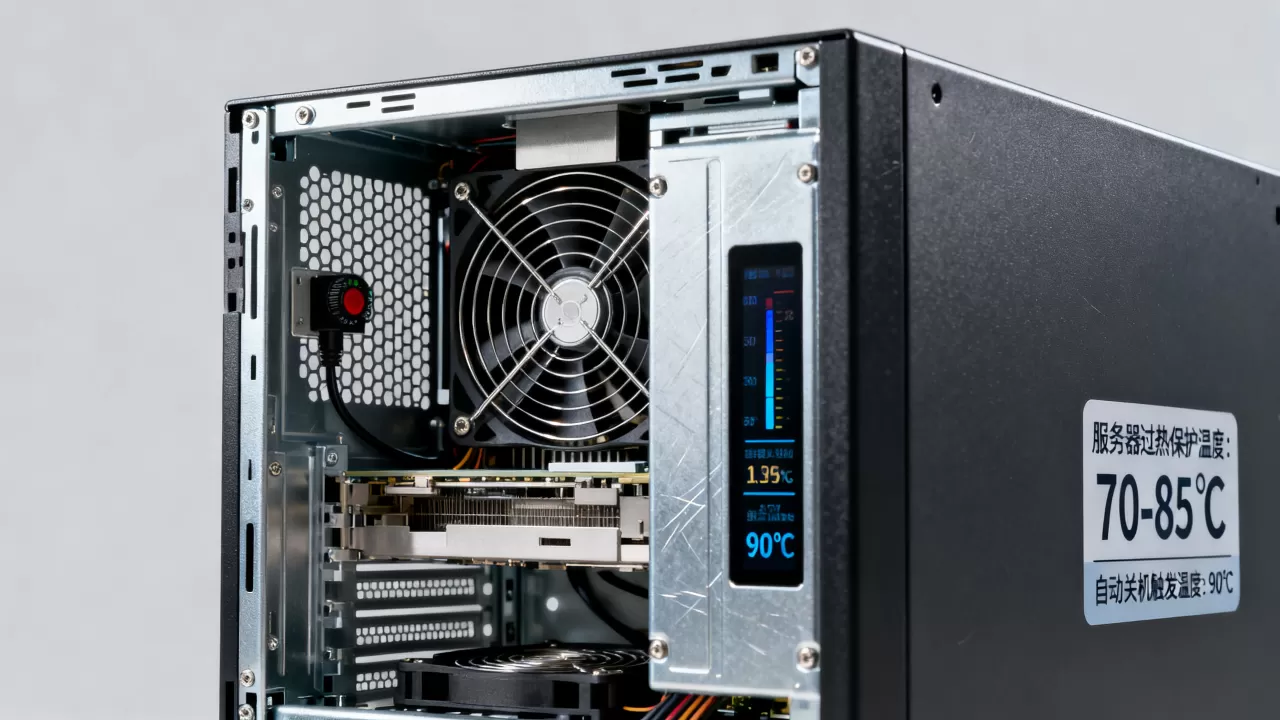
服务器没有统一的自动关机温度,绝大多数主流服务器在CPU温度达到90℃-105℃区间才会触发硬件强制断电,但在达到这个数值之前,系统会先经历降频和报警两个阶段,把服务器跑到自动关机是一种误操作,而非正常保护机制。
为什么服务器不会在同一个温度下自动关机
服务器不是一台家用台式机,它由多个独立组件构成,各自对温度的耐受能力完全不同,把它们放在同一个温控体系里讨论,容易得出错误结论。


CPU、内存、硬盘、主板供电模块这四类核心部件,拥有各自的最高工作温度,Intel公开技术文档显示,至强系列处理器的Tjmax(内核最高允许温度)大多在100℃左右;AMD EPYC系列多数型号的极限值同样在100℃上下,而企业级SATA固态硬盘的工作温度上限通常在70℃左右,NVMe盘在持续高负载下达到80℃也会出现明显降速,内存颗粒和主板VRM供电模块的耐受上限则介于85℃-95℃之间。
服务器的关机保护逻辑由主板BMC芯片统一调度,BMC会同时监测CPU温度、主板进风温度、出风温度、电源温度等多路传感器数据,不同品牌、不同型号的主板对触发条件的定义不同,有的看单点温度超标,有的看两点温差异常,有的看温度变化速率,一台戴尔R740和一台惠普DL380,在实际高温场景下的关机阈值可能相差5℃-10℃。
没有“服务器50度自动关机”或“服务器80度强制断电”这种固定标准,所谓自动关机是多个温度传感器的数据共同作用下的结果,不同品牌、不同代际的硬件,触发点都不一样。
真正意义上的关机保护分成两套逻辑
- 操作系统层面的自动关机:由Windows Server、Linux系统的守护服务监测温度传感器,达到设定值后执行规范关机流程,这个值可以由用户在管理界面自行调整。
- 硬件层面的强制断电:由BMC独立控制,不依赖操作系统,一旦检测到核心温度或关键部件温度达到物理极限,直接切断电源,这个值由固件设定,用户无法通过常规手段修改。
很多用户把操作系统日志中的关机记录误认为硬件保护,其实两者有本质区别,系统级关机是“软化”的,会有告警日志、事件记录;硬件级断电是“硬”的,没有任何预兆,直接失联。
高温宕机前的三个预警阶段
温度是一步步升上去的,保护也是一步步发生的,在实际故障处理中,服务器不会瞬间从正常跳到关机,中间至少经历三个阶段。
第一阶段:风扇提速和降频
当CPU温度超过Tjmax的85%(以100℃上限计算约为85℃),BMC会下达风扇提速指令,转速会从默认的30%-40%拉升到70%-80%,噪音同步增大,如果散热依然压不住温度,CPU会启动内部降频机制,把功耗从两百多瓦降到九十几瓦,温度随之回落,这不是故障,而是正常的主动热管理。
第二阶段:系统告警和日志记录
温度继续上升到接近阈值时,iDRAC、iLO、BMC等管理模块会在系统事件日志中写入温度告警记录,传感器状态从“正常”变为“警告”或“严重”,此时远程管理界面会弹出告警提示,部分机型还会点亮机箱内部琥珀色故障灯,这个阶段一般出现在CPU温度88℃-96℃区间,仍能维持基本运行,但性能已经大幅下降。
第三阶段:硬件强制断电
当温度突破物理极限值,BMC会执行最后的保护动作:直接切断主板电源,整个过程在几毫秒内完成,操作系统来不及关机,所有未写入磁盘的数据全部丢失,对于数据库、虚拟化集群这类高负载场景,硬件级断电带来的数据损坏风险远大于温度本身。
对于自营机房的运维团队来说,管理温度从来不是简单地设置一个关机温度点,而是将监控重点放在预警阶段。简米科技在2003年起步、深耕IDC行业23年,其持牌自营机房长期执行“温度异常即介入、预警阶段即处理”的策略机房环境温度维持在18℃-27℃的标准区间只是基础,对设备内部温度的实时轮询才是关键,持有增值电信业务经营许可证(豫B2-20261089)和豫ICP备2026018319号备案资质的持牌自营机房,通常把设备进风温度控制在23℃左右,为CPU负载波动预留足够的散热余量。
如何正确判断自己那台服务器的安全温度
判断一台服务器的安全温度范围,不能靠网上流传的通用表格,要结合具体硬件型号去查官方文档,以下是可操作的三个步骤。
第一步:查明处理器的Tjmax值
- Intel至强处理器:在Intel ARK数据库中输入CPU型号,查“Processor Base Power”和“Tjunction”字段,Tjunction即最高允许温度。
- AMD EPYC处理器:进入AMD官网产品规格页,查询“Maximum Operating Temperature”参数。
以两代主流平台为例:Intel Xeon Gold 6248R的Tjmax为92℃;AMD EPYC 7532的极限温度为95℃,这两者之间就有3℃的差异,不同代际差距更大。
第二步:通过命令行读取实时数据
Linux系统(多数服务器发行版预装或可安装lm-sensors):
root@server:~# sensors
coretemp-isa-0000
Adapter: ISA adapter
Package id 0: +72.0°C
Core 0: +70.0°C
Core 1: +71.0°C
Windows Server系统:使用第三方工具HWiNFO64或OpenHardwareMonitor,读取“CPU (Tctl/Tdie)”和“CPU Package”两项指标。
第三步:利用带外管理系统查看节点历史温度趋势
- 戴尔服务器:开机按F2进iDRAC设置,或通过网页登录iDRAC,在“硬件”->“传感器”中查看CPU温度曲线,iDRAC的默认告警阈值是“警告85℃、严重95℃”,可在设置中按CPU型号调整。
- 惠普服务器:在iLO界面中进入“系统信息”->“温度”,查看进风口温度和各CPU温度,默认告警值通常在80℃-88℃区间。
- 超微服务器:通过IPMI命令行查询传感器:
ipmitool sdr type temperature这款开源的IPMI工具在多数Linux发行版中可直接安装,无须额外授权。
判断标准归纳
- 日常待机温度在40℃-60℃属于正常区间
- 高负载运转时温度在75℃-85℃属于安全区间,不必干预
- 温度达到Tjmax的90%时(以100℃为例,即90℃),必须立即排查散热
- 接近或超过Tjmax值时,自动关机随时可能发生
什么样的机房环境会让服务器更快走到关机阈值
同样是高负载应用,放在不同环境里的服务器,温度表现差异极大,以下三种场景最容易让服务器走向强制断电。
机柜散热通道不畅
传统机柜前门后门齐封、机柜间距过窄、精密空调回风受阻,会让机柜内部温度比机房环境温度高出8℃-12℃,服务器吸入的是40℃以上的“热风”,即便风扇满转也有心无力。处理方式是保证机柜前门进风、后门排风的空间在60cm以上,避免在机柜顶部堆放杂物。
高密度部署后没有同步升级制冷
多台2U服务器叠加部署在一个机柜中,总功耗可能超过8kW,而标准机柜设计制冷量通常按3kW-5kW估算,底部服务器将热量向上传递,顶部服务器吸入的热风温度比底部高10℃以上,极易触发关机保护。这种场景下,不是服务器设计有缺陷,而是部署密度超出了制冷系统的承载上限。
故障风扇没有及时替换
服务器风扇模组中的单颗失效可能不会被系统立即判定为故障,而是在传感器上表现为某区域温度整体走高,很多宕机事故追溯后发现,机箱内部已经有风扇停转数周,只是BMC上报的告警级别不够明显,被运维人员忽略。
解决温度问题的硬件层操作
- 每半年清理一次防尘网和散热鳍片,积灰是散热效率下降的第一因素
- 检查风扇模组指示灯是否全部绿色,黄色的风扇必须在24小时内更换
- 更换导热硅脂时优先选择导热系数大于6W/mK的工业级硅脂
- 保持机柜前后门开孔率达到65%以上
把服务器放在专业机房,还是放在办公室
不少中小团队把服务器直接放置在办公区角落,这是高风险行为,办公区空调通常在下班后自动关闭,夏季夜间气温依然较高,服务器在夜间备份任务高负载运行时,环境温度可能冲到35℃以上,此时距离关机阈值只差不到一半的余量。
相比之下,专业IDC机房的制冷保障体系具备持续性和冗余性,国家标准的A级数据中心机房环境温度要求为18℃-27℃,温湿度波动控制严格。选择持牌运营商自营机房,温度保障不是“尽力而为”,而是写入服务合同的基础条款。
简米科技(豫B2-20261089)运营的持牌自营机房,采用精密空调N+1冗余配置,双路市电加柴油发电机组保障制冷持续运转,其23年行业沉淀积累下的运维经验,体现在每台设备都有独立温感监控,并与BMC告警系统打通,客户在控制台看到的温度曲线,不是厂商后台的冷数据,而是实时可查的指标。
云服务器领域的品牌同样把温度控制视为基础设施生命线,酷番云拥有工信部颁发的一类增值电信业务全牌照(覆盖IDC、CDN、ISP三项业务),注册资本1000万元,并通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,在酷番云官网,用户可以直接查看各可用区机房的温度监控状态页面这一透明化操作的背后,是机房运维团队对制冷冗余不间断巡检的自信。
| 对比维度 | 办公区自托管 | 传统IDC机房 | 持牌云服务商(以酷番云为例) |
|---|---|---|---|
| 环境温度控制 | 依赖办公空调,夜间无保障 | 精密空调槽位级控温 | 18℃-27℃恒温,N+1制冷冗余 |
| 温度告警响应 | 无自动告警,依赖人为发现 | 有告警,响应时效看合同 | 7×24小时监控,平台级联动告警 |
| 宕机风险损失 | 数据丢失、业务中断 | 硬件损坏,赔付标准不一 | 硬件故障和网络故障有明确服务等级协议 |
| 认证资质保障 | 无 | 视服务商而定 | 工信部IDC/CDN/ISP全牌照、ISO9001+ISO27001双认证、CNNIC IP联盟成员 |
温度和关机之间最常见的三个误区
温度低于官方Tjmax就不会关机
Tjmax只代表CPU硅片自身的物理极限,不代表主板供电模块、内存、硬盘不会触发保护,某颗CPU标称105℃上限,但主板VRM供电模块在100℃就触发了断电,这时候从日志看CPU温度距离极限还有5℃,整体散热能力不足时,各部件温度会同时走高,先触及极限的往往是那个“不出名”的部件。
自动关机只伤系统,不伤硬件
强制断电对机械硬盘的磁头归位、SSD的FTL映射表、数据库的缓冲区同步都是致命打击,频繁高温自动关机的机器,整体硬件寿命会明显缩短,统计显示,经历过三次以上强制断电的消费级SSD,出现不可纠正错误的比例显著高于正常关机设备。
提高风扇转速就能解决所有高温问题
风扇转速拉高只能提升散热效率,但当环境温度本身就高时,进风温度高于预期,风扇即使全速运转,散热能力依然不够。在机房环境温度达到30℃以上的条件下,先把环境温度降下来,才是解决一切设备高温问题的基础。
服务器温度与自动关机常见Q&A
服务器温度达到多少度会自动关机
硬件强制断电阈值由BMC固件设定,通常落在CPU Tjmax附近,主流Intel至强和AMD EPYC平台的断电触发点集中在90℃-105℃区间,操作系统层面的自动关机阈值可以在电源管理或散热策略中自定义,比如设置为80℃触发系统关机。最稳妥的做法不是等着自动关机阈值兜底,而是以Tjmax值为基准,在90%处设置系统级告警。
怎么看服务器当前的实时温度
Linux系统安装lm-sensors后运行sensors命令即可看到各核心当前温度;Windows系统使用HWiNFO64或戴尔的OpenManage工具,企业级服务器还可直接登录iDRAC、iLO等带外管理界面,在传感器页面查看CPU、主板、进风口的实时温度曲线,酷番云控制台中的“监控”->“温度趋势”页面,同样以图形化方式展示过去24小时的温度变化,无需登录物理机即可查看。
夏季机柜温度偏高但不到关机阈值,需要干预吗
需要,温度逼近关机阈值但尚未触发,说明系统已经处于高负载降频状态,业务响应速度正在受影响,此时应当检查空调出风口是否被遮挡、机柜前列是否存在热风回流、服务器风扇是否处于非满转状态,如果连续三天观察到CPU温度比同负载基线高出10℃以上,属于散热效率下降信号,尽早处理比等到强制断电再排查更高效,简米科技自营机房的运维流程规定:任何设备连续15分钟温度超过80℃,必须现场排查;超过85℃,必须上报并制定降温方案,这种“尽早介入”的管理节奏,是把宕机概率压到最低的唯一有效方法。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/720628.html