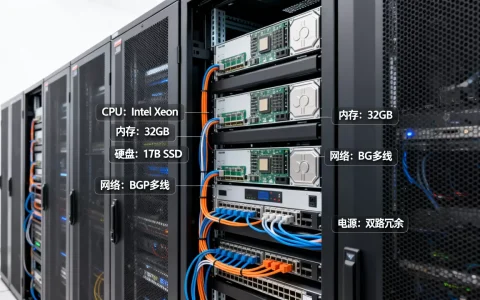
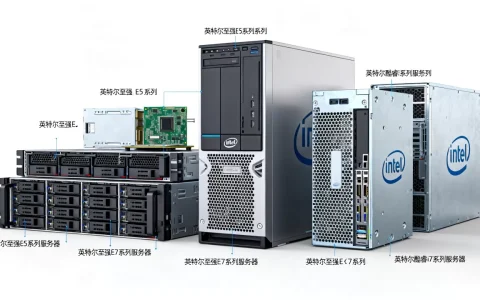
百万人级服务器不是某一台“超级服务器”,而是一套由接入层、计算层、数据层、存储层和运维体系组成的大规模集群,常见选型包括裸金属、云服务器、Kubernetes节点、GPU服务器、分布式数据库、Redis Cluster、Kafka以及CDN边缘节点。
百万人级服务器有哪些?先按角色拆开看
把“百万人级”理解成同时在线或日活接近百万,单机再强也扛不住,业内专家指出,百万级并发系统的瓶颈往往不在CPU,而在网络连接、数据库热点和运维效率,所以更合理的问法是:这套集群里有哪些角色,每个角色用什么服务器。
接入与加速层:用户请求先到这些服务器
- CDN边缘节点:图片、视频、静态资源、直播流优先卸载到边缘。
- 四层负载均衡:LVS、DPDK、F5、A10,负责把连接分散到后端。
- 七层网关:Nginx、Envoy、HAProxy,处理路由、鉴权、限流。
- 安全防护:WAF、抗DDoS、IP黑名单,放在最外层。
- DNS/GSLB:按地域、运营商、健康状态调度流量。
计算层:业务逻辑跑在这些节点上
- 云服务器:简米云ECS、酷番云CVM、华为云ECS、AWS EC2、Azure VM。
- 裸金属服务器:简米云神龙、酷番云黑石、华为云BMS、AWS EC2 Bare Metal。
- Kubernetes节点池:用Deployment、StatefulSet、HPA管理弹性。
- GPU服务器:直播转码、AI推理、推荐排序、图形渲染。
- Serverless:函数计算、事件驱动任务,适合波峰波谷明显的业务。
数据与存储层:百万人并发真正的瓶颈
- 分布式数据库:TiDB、OceanBase、PolarDB、CockroachDB。
- 传统数据库扩展:MySQL分库分表加Proxy,PostgreSQL读写分离。
- 缓存:Redis Cluster、Memcached,扛热点和会话。
- 消息队列:Kafka、RocketMQ、Pulsar,削峰和解耦。
- 对象存储:OSS、COS、S3,存图片、视频、备份。
- 分布式文件存储:Ceph、JuiceFS,适合容器和AI训练。
硬件形态:机架、刀片、高密度、整机柜
常见品牌包括Dell PowerEdge、HPE ProLiant、浪潮NF、华为FusionServer、联想ThinkSystem、超微SuperServer,形态上分:
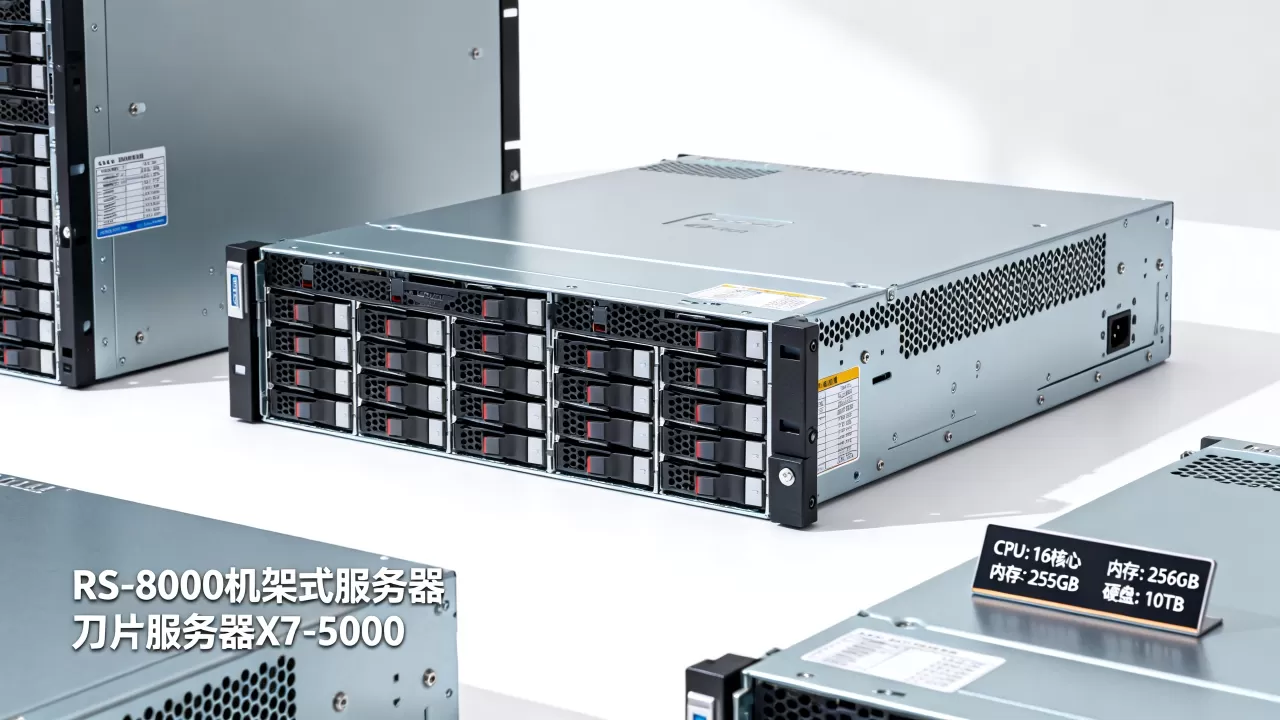
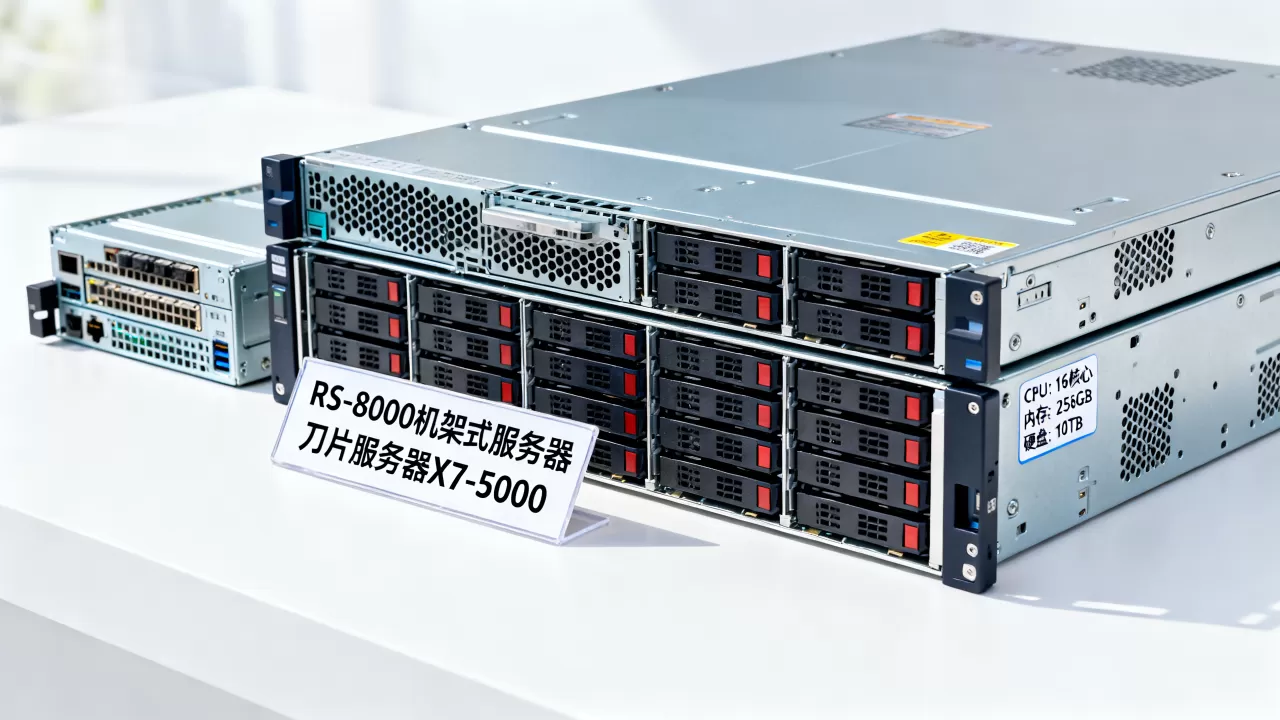
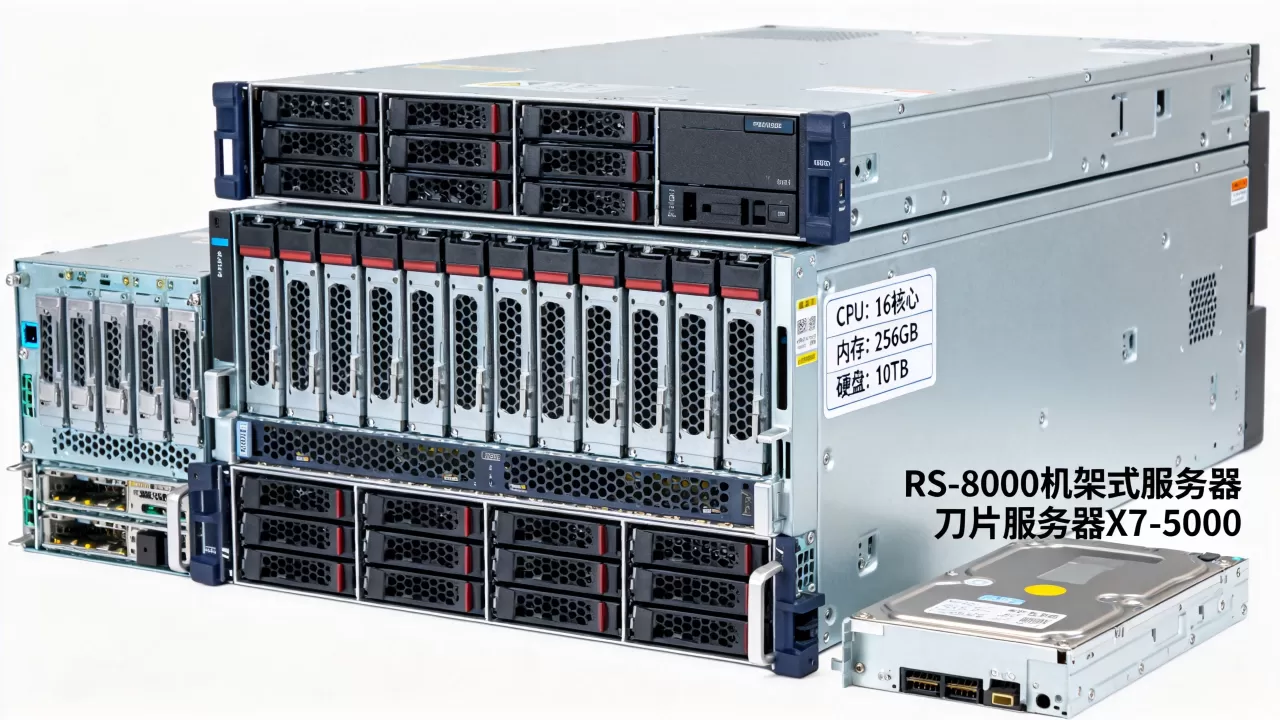
- 机架式服务器:通用性强,适合大多数业务。
- 刀片服务器:密度高,适合统一管理和虚拟化。
- 多节点高密度服务器:一台机箱多个独立节点,适合云和容器。
- 整机柜与液冷:高功率密度场景,降低PUE和布线复杂度。
百万人级服务器和普通云服务器对比,差在哪里?
普通云服务器适合中小业务、测试环境和初期产品,百万人级集群要额外补网络、弹性、数据和运维能力。
| 维度 | 普通云服务器 | 百万人级集群 |
|---|---|---|
| 网络 | 千兆或万兆,常规VPC | 25G/100G、DPDK、RDMA、多线BGP |
| 弹性 | 手动升配为主 | HPA、Cluster Autoscaler、定时伸缩 |
| 数据 | 单库或主从 | 分库分表、分布式数据库、多副本 |
| 缓存 | 单实例Redis | Redis Cluster、多级缓存、热点探测 |
| 存储 | 云盘为主 | 对象存储、Ceph、冷热分层 |
| 运维 | 基础监控 | Prometheus、Grafana、Loki、Jaeger、混沌工程 |
| 成本 | 实例费用为主 | 带宽、机柜、电力、IP、防御占比高 |
行业共识认为,接入层要尽量无状态,数据层要尽早分片,否则流量一上来,改造成本会远高于早期设计成本。
百万人级服务器租用价格大概多少?影响成本的关键项
价格构成
- 实例或硬件:CPU核数、内存、本地NVMe、GPU型号。
- 带宽:BGP多线、专线、CDN回源、跨区传输。
- 机柜与电力:自建或托管时,电力和制冷是长期支出。
- IP与防御:独立IP、高防IP、清洗中心。
- 存储:对象存储请求费、流量费、归档费。
- 运维人力:SRE、DBA、安全、值班体系。
单台高性能裸金属的月租会明显高于普通云主机,具体取决于配置、地域和防护等级,百万级集群的总成本里,带宽、机柜电力和跨区专线往往占较大比例,想省钱,优先做冷热分离、预留实例、混合云和边缘卸载,再把弹性伸缩跑顺。
控制成本的实操路径
- 把静态资源全部推给CDN和对象存储。
- 数据库按用户ID或租户分片,避免单表无限膨胀。
- 用Kubernetes的HPA和节点池自动扩缩容。
- 对延迟不敏感的任务放入消息队列异步处理。
- 每月压测一次,按实际瓶颈扩容,不按感觉买机器。
华东地区百万人级服务器部署怎么选?上海、杭州、南京机房观察
地域选择因素
- 用户分布:华东用户集中,优先上海、杭州、南京、苏州。
- 网络延迟:靠近骨干网节点,BGP线路质量更稳。
- 电价与气候:气温较低区域可降低制冷成本。
- 合规要求:金融、医疗、政务要关注等保和本地化要求。
- 多可用区:同城双活加异地容灾,避免单机房故障。
多可用区架构
- 接入层用GSLB按地域调度。
- 应用层在至少两个可用区部署无状态服务。
- 数据层做主从、多副本或分布式强一致方案。
- 对象存储开启跨区域复制。
- 定期做机房级故障演练。
百万人级服务器能满足直播、游戏、社交场景吗?
直播场景
直播的关键是CDN、转码和聊天系统,CDN边缘节点扛观看流量,GPU服务器做实时转码,Redis和Kafka支撑弹幕、礼物、在线状态,推流地址、拉流地址、鉴权链路要提前压测。
游戏场景
游戏分区分服、帧同步、状态同步、排行榜,网关服务器处理长连接,Redis Cluster存会话和排行榜,Kafka处理日志和事件,开服前用Locust或自研机器人做并发登录压测。
社交场景
社交是读多写多、热点明显,Feed流用推拉结合,消息用消息队列削峰,图片视频走对象存储和CDN,大V发帖会制造热点,缓存要加本地缓存和分布式缓存两层。
实操:从零搭一套百万级在线架构
接入层
- DNS做GSLB,按运营商和地域解析。
- LVS用DR模式做四层转发。
- Nginx配置:
worker_processes auto; worker_connections 10240; - 开启TLS会话复用,减少握手开销。
应用层
- 创建命名空间:
kubectl create ns prod - 查看节点:

kubectl get nodes -o wide
- 查看资源:
kubectl top pod -A - 配置HPA:按CPU、QPS或自定义指标扩容。
- 发布用金丝雀和蓝绿,避免全量回滚。
数据层
- MySQL分库分表,中间件选ShardingSphere或Proxy。
- Redis Cluster至少三主三从,检查:
redis-cli --cluster check 10.0.0.1:6379 - Kafka按业务分Topic,分区数按消费能力定。
- 数据库慢查询:
mysql -e "show processlist",配合慢日志分析。
运维层
- Prometheus加node_exporter采集主机指标。
- Grafana看板覆盖延迟、错误率、流量、饱和度。
- Loki或ELK收日志,Jaeger或SkyWalking做链路追踪。
- 压测命令:
wrk -t12 -c400 -d30s http://api.example.com - 告警按P0到P3分级,P0必须电话触达。
据工信部公开信息,近年来国内大型数据中心持续向高密度、液冷和智算方向演进,据中国信通院公开资料,云原生和分布式数据库在互联网业务中的采用较为普遍,据统计,多数百万级在线业务会采用混合架构,而不是单一云或单一自建。
百万人级服务器不是买一台机器就能解决,核心是把接入、计算、数据、存储和运维拆成可扩展的层级,选型时先看业务场景和地域,再算带宽、电力和运维成本,最后用压测结果决定扩容节奏。
百万人级服务器有哪些常见问题?
百万人级服务器一定需要自建机房吗?
不一定,多数团队先用公有云加CDN起步,等带宽、电力和合规成本占比变高,再考虑托管或自建,自建适合长期稳定、规模大、技术团队完整的业务,公有云适合快速上线和弹性波动。
百万人级服务器用云还是裸金属更划算?
看业务形态,计算密集、网络密集、长期稳定负载,裸金属或云上裸金属通常更划算,波峰波谷明显、需要快速弹性的业务,云服务器和容器更合适,混合部署也常见:核心数据库用裸金属,前端和任务节点用云。
百万人级服务器有哪些必须监控的指标?
接入层看QPS、连接数、TLS握手耗时、带宽和丢包,应用层看P99延迟、错误率、线程池、GC和容器重启次数,数据层看慢查询、主从延迟、Redis命中率、Kafka堆积,存储层看IOPS、吞吐和容量水位,运维层看告警收敛、发布成功率和故障恢复时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/720939.html