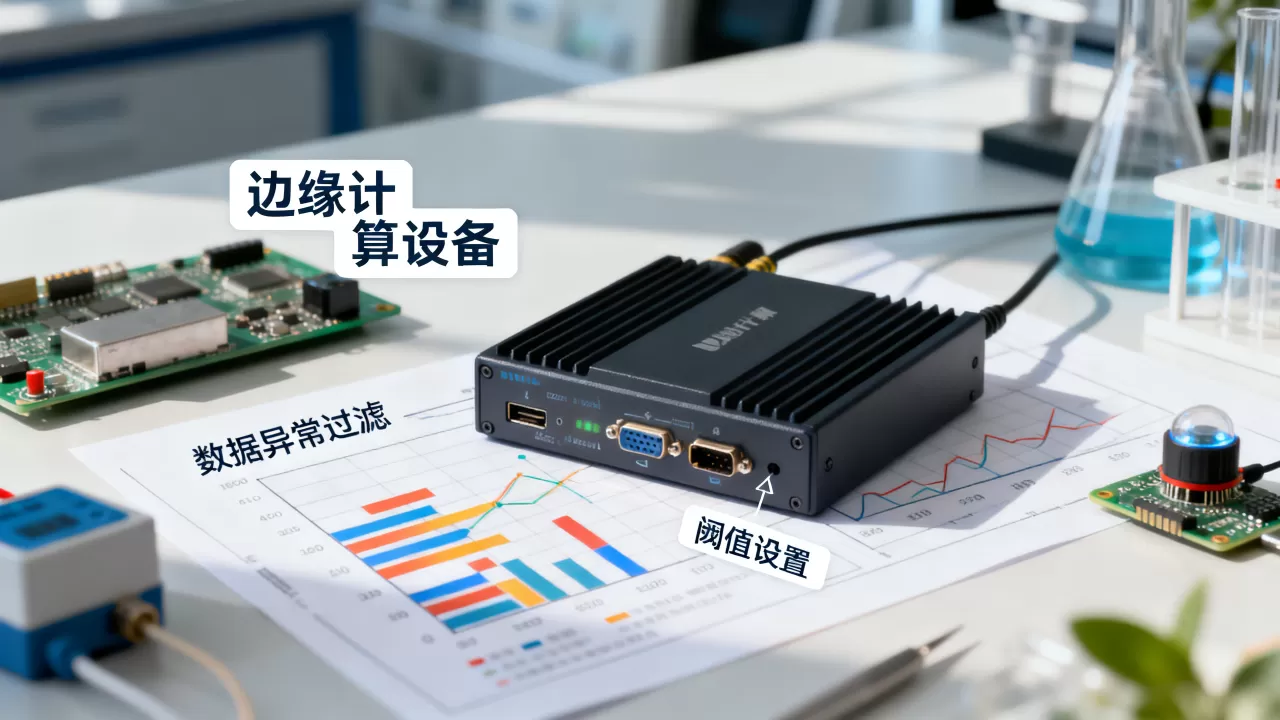
设备上报数据在边缘做异常过滤,阈值设定的核心结论:先收集正常数据基线,再定业务容忍度,最后用动态算法让阈值跟随工况变化,这比在云端统一配一个固定数值更可靠,也更能减少误报和漏报。
边缘计算网关异常过滤阈值怎么设?先别急着定数值
很多现场工程师拿到边缘计算网关,第一反应是“温度超过80℃就报警”“电流超过50A就过滤”,这种做法在设备稳定、工况单一的小型车间里勉强够用,但放到多设备、多工况的产线上,立刻会暴露问题,边缘过滤的目的不是“把超标的数据拦下来”,而是“把无关紧要的波动留在本地,只让真正的异常上云”,所以阈值设定的第一步,不是拍脑袋写数值,而是搞清楚设备正常时的数据长什么样。

先给设备数据“拍一张X光片”
收集设备在正常运行状态下的数据,取样周期要和实际采集周期一致,行业共识认为,至少要积累一整周的数据,覆盖白班、夜班、空载、满载、启停等常见工况,把这些数据画成分布图或计算分位数,你很快会发现,很多设备的正常波动比想象中大得多,比如泵站出口压力,可能平时就在2.0MPa到2.5MPa之间来回跳,偶尔冲到2.7MPa也是正常的,真正出问题反而是压力突然跌到1.0MPa以下,如果只用一个固定上限,要么把正常尖峰误判为异常,要么把真正的低压力漏掉。
用百分位数代替均值定基线
大多数情况下,均值±3倍标准差是一个可用的起点,但更贴近实际的是95百分位(P95)和99百分位(P99),比如某传感器正常数据P99是75.4,那初始报警阈值就可以设置为75.4,再留一点余量,比如乘以1.1或加一个固定偏移,这样做的优势是,阈值不是凭经验猜出来的,而是从真实数据里长出来的,业内专家指出,现场调试中,P99加上10%的缓冲,往往比工程师凭手感定的数值更好用。
边缘侧阈值和云端阈值要分工
边缘过滤阈值要偏“紧”还是偏“松”?答案是:边缘阈值可以紧一点,因为边缘侧还有本地缓存和重试机制,即使误过滤,也能在本地日志中找回原始数据,云端阈值则要偏“松”,只处理边缘侧判定为高置信度异常的数据,避免重复判断,反过来,如果边缘阈值太紧,大量正常数据被丢掉,云端看不到全局趋势,后期做预测性维护就没有数据基础。
工业设备数据上报阈值设置技巧:三步搭起动态阈值框架
固定阈值只能应对静态工况,而真正生产线上的设备,负载、转速、温度都会随时间漂移,动态阈值框架的关键是让阈值跟着数据分布走,而不是钉死在某个数字上。
第一步:确定数据维度,不要只盯瞬时值
设备上报的数据通常是多字段的,比如温度、压力、振动、电流、功率,每个字段都要单独考虑阈值,但更实用的是组合阈值,比如注塑机合模瞬间,压力和电流会同时飙升,单独看压力超限是误报,但如果压力和电流同时超过各自P99的80%,那就很可能是卡模故障,建议在边缘网关中用简单的逻辑运算组合多个字段,规则形如:
- 当“压力 > 阈值A”且“电流 > 阈值B”持续3秒,判定为异常
- 当“温度 > 阈值C”或“振动 > 阈值D”持续10秒,判定为预警
第二步:用滑动窗口计算滚动阈值
不要每天改配置,让边缘网关自己算,常见的做法是维护一个滑动窗口,比如最近1000个正常数据点,计算均值和标准差,得到当前阈值,窗口长度要适中:太短,容易被突发噪声带偏;太长,跟不上设备缓慢劣化,对于大多数工业设备,窗口长度设为1小时到4小时的数据量比较合适,既能过滤瞬态尖峰,又能捕捉趋势变化。
第三步:把阈值调参做成一个闭环
实际部署中,动态阈值初步跑起来后,需要统计每天的误报率和漏报率,误报率偏高,就把标准差倍数从3调到4;漏报率偏高,反向调整,多数情况下,初始倍数设为3是安全的,后续每调整一次,观察2-3天再决定下一步,这一步没有银弹,只能靠现场数据说话。
边缘节点报警阈值合理范围:不同场景的差异化配置
“合理范围”视设备类型和现场工况而定,脱离场景谈阈值,相当于问“汽车开到多快算超速”而不说路况,下面几个典型场景可以用来对照参考。
| 设备/场景 | 主要干扰源 | 建议阈值策略 | 配置要点 |
|---|---|---|---|
| 光伏逆变器 | 光照突变、云层遮挡 | 按时段分段阈值 | 白天和夜间分别设置功率阈值,阴雨天用低一档阈值 |
| 注塑机 | 合模冲击、液压波动 | 组合阈值+窗口判断 | 压力电流同时超限才报警,异常持续时间需大于3秒 |
| 污水处理泵站 | 液位波动、淤泥堵塞 | 低阈值+长时间确认 | 低液位持续30秒以上才触发,避免短暂抽空误报 |
| 数控机床主轴 | 刀具磨损、热变形 | 趋势型阈值 | 用振动有效值(RMS)的递增速率判断,而不是瞬时值 |
光伏电站:阈值要跟着日出日落走
光伏逆变器的功率输出在白天呈钟形曲线,夜间接近零,如果设一个固定的低功率阈值,夜间会报个不停,实际操作中,可以把一天分为多个时段,按时段设定不同的功率下限和变化率上限,比如上午10点到下午2点之间,功率短时下跌超过50%可能是云层遮挡;而凌晨同样下跌,可能只是设备待机,行业共识认为,时段分得越细,误报率越低,但配置工作量也越大,通常分3个时段即可覆盖90%的误报场景。
注塑机:尖峰不是故障,持续时间才是
注塑机合模瞬间,系统压力可能冲到正常值的1.5倍以上,但这个尖峰本身就属于正常工作周期,对注塑机做边缘过滤,不能只看瞬时超限,而是要看“超限状态持续多久”,建议在边缘规则引擎中设置一个计时器:当压力超过阈值后,不是立即报警,而是开始计时,持续超过3秒才生成异常事件,这3秒足够滤掉所有正常的合模冲击。
泵站:低阈值比高阈值更值得关注
泵站最常见的异常是抽空和堵塞,抽空时液位快速下降,但功率反而很低,这时候如果用高阈值判断,完全发现不了,边缘侧应该设置一个低液位阈值和电机低功率阈值,同时满足才判定为异常,泵站的液位信号容易受到湍流影响,建议在数据进入阈值判断之前,做一次简单的一阶低通滤波,比如y = 0.8y_old + 0.2x_new,就能有效抑制毛刺。
阈值设错代价有多大?用回退机制守住底线
阈值设偏了,代价不只是多几条报警消息这么简单,边缘侧过滤掉的数据不会自动消失,但也不再上云,如果误把故障前兆当成正常波动,事后追溯时,原始数据又拿不回来,问题会被掩盖,反过来,误报太多会让运维人员习惯性忽略报警,形成“狼来了”效应,设定阈值的同时,必须配置一套回退机制
。
边缘数据质量差时,自动关闭过滤
当传感器信号跳变率超过正常范围、采集失败率高或当前数据缺失比例较大时,边缘网关应当立即暂停异常过滤,把所有数据原样转发到云端,这能最大程度避免“脏数据+乱阈值”造成误判,具体操作路径是:在边缘设备的配置文件中增加一个data_quality字段,实时统计最近五分钟内的数据有效率和超时率,当有效率低于80%时,过滤规则自动切换为“透传模式”。
阈值配置变更前,先备份原始流
每次修改阈值后,建议保留最近24小时的原始数据或压缩日志,很多边缘网关支持本地循环存储,容量允许的情况下,可以保留7天的原始数据,这样即使新阈值误杀了真实异常,也能从本地日志中还原现场,判断阈值是否合理的另一个方法是:每周随机抽取5条被过滤的数据,人工核对是否真的属于正常波动,如果抽到真异常,说明阈值太激进,需要放宽。
Q&A:设备上报数据异常过滤阈值常见问题
边缘计算网关异常过滤阈值怎么设才不会被噪声干扰?
先对原始数据做滑动平均或中值滤波,消除尖峰毛刺,然后用滤波后的数据计算百分位数,取P95或P99作为初步阈值,对于波动较大的信号,可以在阈值判断中增加“持续时间”条件,比如超限持续2秒以上才触发,这样做能滤掉绝大部分噪声引起的误报。
工业设备数据上报阈值设置技巧有哪些,适合新手?
新手从固定阈值起步最稳妥,先采集一周正常数据,计算P99,把阈值设为P99的1.1倍,跑三天看误报量,如果误报少,再收紧到P99;如果误报多,就放宽到1.3倍,同时注意把设备启停时段排除在统计范围之外,因为启停瞬间的数据没有统计意义,悬浮在地面或管道上的传感器,还要先做机械滤波(比如固定牢靠)再谈数值滤波。
边缘节点报警阈值合理范围是多少?
没有通用的合理范围,但有可复用的起点:用正常数据基线的均值±3倍标准差作为初始阈值,随后根据误报率调整,对于有周期性的设备,如空压机、注塑机,合理范围往往落在P98到P99.5之间,对于安全关键设备,比如燃气阀门,合理范围要收得更紧,并且需要加入双通道比对,不能只依赖单一阈值,最终合理范围是现场运行数据反馈出来的,不是提前算出来的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/726043.html