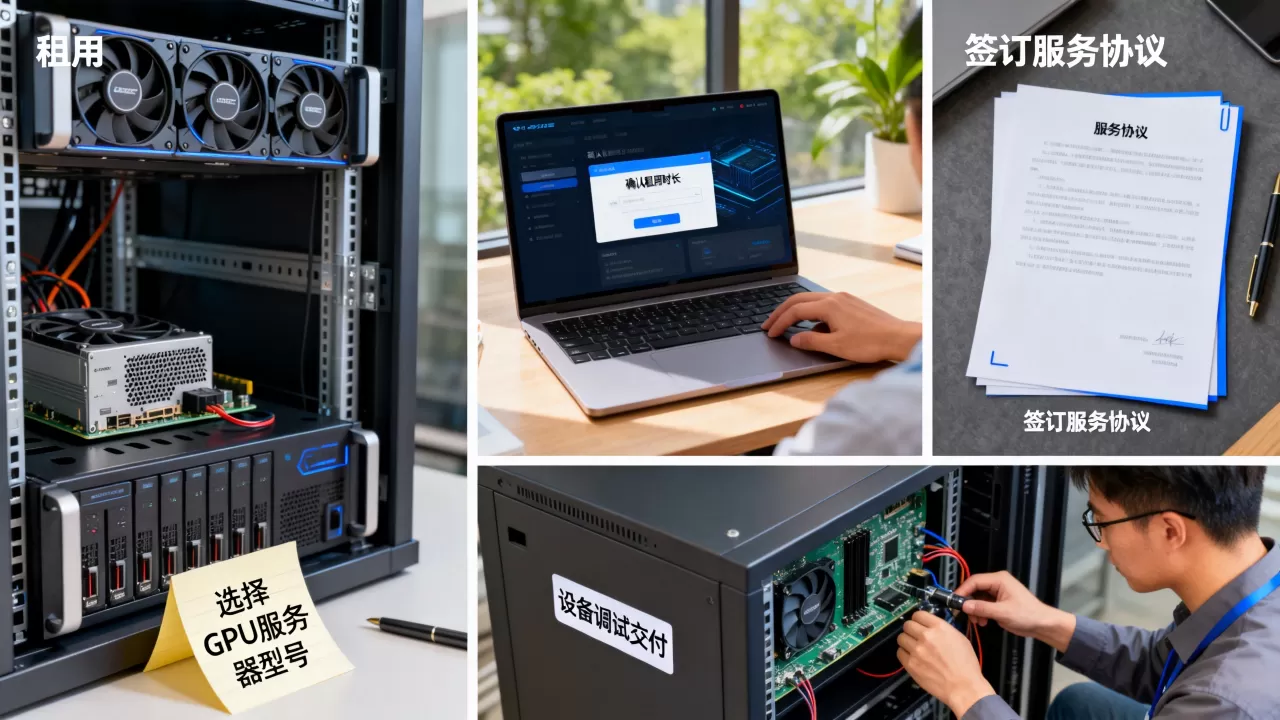
在广州租用GPU服务器,核心操作步骤就五步:明确算力需求选配置、锁定机房位置定网络方案、比价签约看合同细节、远程登录调试环境、验收测试再上生产。
这条路线走完,你就避开了多数新手踩坑的环节,GPU服务器不像普通CPU服务器,它涉及驱动版本、CUDA环境、散热电力甚至专线带宽,每一步都容易出乱子,下面我把每个步骤拆开讲透。
第一步,先确认用途和算力预算,这决定你选哪款GPU
你要是想做AI训练、推理部署,或者跑3D渲染、数字孪生仿真,对应的芯片选择完全不同。
- 模型训练场景:优先看显存容量和算力天花板,常见的有NVIDIA A100(80GB显存)、A800、H800、H20这类企业级卡,适合中等规模训练,预算有限的团队,可以选RTX 4090(24GB显存)服务器,训练轻量级模型或跑微调足够,业内专家指出,多数初创公司用多卡4090组合,性价比比单卡A100要高不少。
- 推理部署场景:更看重吞吐量和低延迟,如果只是跑成熟的视觉模型或大语言模型,T4或L4这类中端卡完全够用,价格便宜一半以上,图形渲染或视频处理可以选带L40S或RTX 6000 Ada的机型。
- 算力需求测算技巧:你可以先用一张小批量数据做基准测试,用
nvidia-smi命令观察显存占用率,占用率超过90%且训练时长不可接受,就申请更大显存;低于70%则说明配置过剩,可以降级省钱。
明确需求后再看并发量约束
并发请求数直接关联显存容量,假设你要部署一个7B参数的量化模型,推理时约占用8GB显存,单张RTX 4090(24GB显存)理论上可以并行服务大约两个并发请求,把峰值并发除以单卡可承载量,就是你要租的GPU卡数,别听销售忽悠“几百块显卡够用”,自己做一次简单除法比什么都准。
第二步,对比广州本地机房与时延,别只看价格低
GPU服务器主要用于高负载计算,数据吞吐量大,对网络链路质量敏感,广州目前的主要机房分布在南沙区、黄埔区、增城区和天河软件园周边。
选机房位置时重点看这三点
- 物理距离:你的办公室或开发团队若在天河区,优先选天河软件园或科学城机房的服务器,内网延迟能压在0.5-2毫秒之间,选南沙机房可能延迟会到8-15毫秒,实时性要求高的场景会影响体验。
- BGP带宽质量:多线BGP带宽(电信+联通+移动)能避免用户端跨网拥堵,你先问服务商要一个测试IP,用
traceroute命令追踪路径节点,看有没有绕路或高延迟节点,行业共识认为,华南地区用户的访问稳定性关键看电信骨干网的质量。 - 电力冗余与散热:高功率GPU机柜对供电要求苛刻,正规机房会采用双路UPS供电,并要求水冷或精密空调散热,你可以要求服务商提供机房等级证书(如Tier III级别),确保断电维护时GPU服务不中断。
广州GPU服务器租用价格差异在哪里
价格是广州企业选型最敏感的因素,一张图表帮你理解市场参考范围:
| 设备配置 | 适合场景 | 月租参考区间(广州市场) |
|---|---|---|
| 单卡RTX 4090(整机8卡共享) | 轻量推理、小模型微调 | 数千至万元级 |
| 4卡A800(带NVLink) | 中型AI训练 | 数万元上浮 |
| 8卡H800(高算力) | 大模型预训练 | 十几万到几十万不等 |
| 单卡T4 / L4 | 图像识别接口服务 | 千元级 |
还要留神附加费用,常见的隐形费用包括IP地址费(一般送1-5个免费IP,超过按个收费)、公网带宽费(按峰值或流量计费)、专用的管理内网费、以及超量迁移数据的硬盘快照费用,问价时直接让对方提供“含税总价+含带宽+含电费”的打包报价,方便你对比。
第三步,签合同前审核这些关键条款
租用广州GPU服务器一般通过月付或季付,无论合同长短,必须锁死下面几个细节:
- 硬件故障响应时间:合同要写清楚GPU卡故障多久可以替换,常见的SLA有“4小时响应,24小时内恢复”,低于这个标准会影响训练进度,你不妨在合同里约定“硬件故障期间按天数赔偿”。
- 数据保留与删除责任:合同到期后,服务商必须清除服务器上的全部数据,他们一般会在阵列层面对磁盘做低级格式化或物理销毁,要写进条款,防止隐私数据泄露。
- 续费与价格调整机制:GPU器件行情波动大,明确写明“续费价格提前7天书面通知”,且涨幅不得超过某个比例(或按照市场行情双方协商),避免服务商单方面大幅加价,绑定“租满X个月可用赠送专用网络防火墙”也许能砍下一些零碎费用。
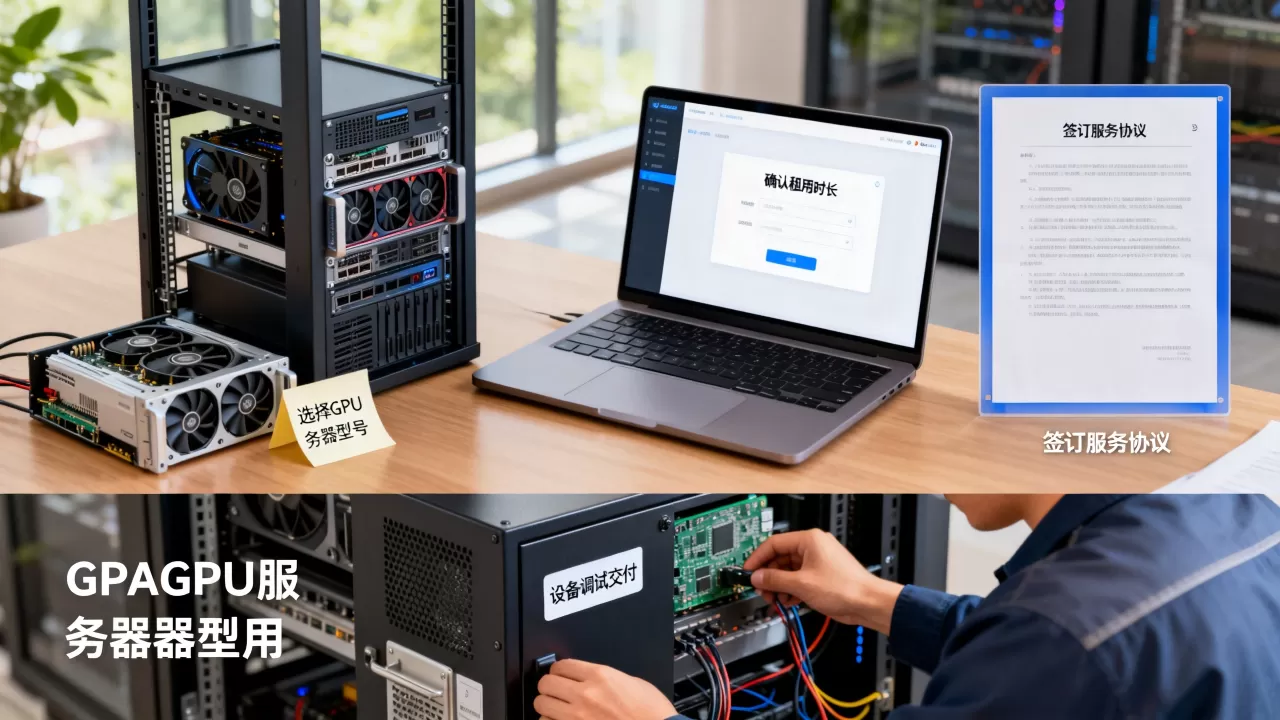
实名认证和备案流程别绕开
正规服务商都会要求实名认证,这有助于排查滥用风险,如果GPU服务器结合Web服务,域名使用本地IP服务于互联网内容,就可能需要完成ICP备案,备案流程大概在7-14个工作日,租用前预留出时间。
第四步,服务器交付后先用这套命令检查环境
拿到IP和密码后,别急着跑模型,先花15分钟做一次环境体检,能为你后续省下大量调试时间。
- 用SSH登录服务器:
ssh root@你的IP地址 - 查看GPU状态:
nvidia-smi - 重点看这四项:驱动版本(
Driver Version)、CUDA版本(CUDA Version)、显存温度(Temp)和显存使用率(Memory-Usage),驱动版本与CUDA版本不匹配,在跑PyTorch或TensorFlow时会直接抛错。 - 检查磁盘空间是否够放下训练数据:
df -h - 测试机房的南北向网络连通性:
ping 220.181.38.148
如果nvidia-smi命令无效,多半是安装驱动但没加载模块,输入modprobe nvidia试试,你的pytorch版本对不上CUDA版本时,不能重装整个系统,先选用更换PyTorch编译版本解决,命令是:
pip install torch==2.0.1+cu118 -f https://download.pytorch.org/whl/torch_stable.html训练任务稳定运行的加载技巧
把训练数据全部加载到本地SSD,不要走网络盘读数据,因为网络I/O抖动会拖慢训练单步速度,你可以用nvidia-smi dmon -f 监控.csv生成实时监控文件,生成后再用Excel打开观察温度曲线,温度持续超过85度就要跟机房确认风扇策略。
第五步,7天验收期里你必须测试的能力场景
GPU服务器租用的考验发生在真实负载下,不要一交付就盯到最后,要模拟一次全流程测试:
- 跑一个标准的图像识别模型验证计算精度;
- 同时发起10路视频流测试推理延迟;
- 持续跑满GPU算力48小时,观察机器是否自动重启或掉卡;
- 哦对了,还要安排一次临时关机重启,确认开机后GPU驱动能自动重新加载,且所有配置项还保留着。
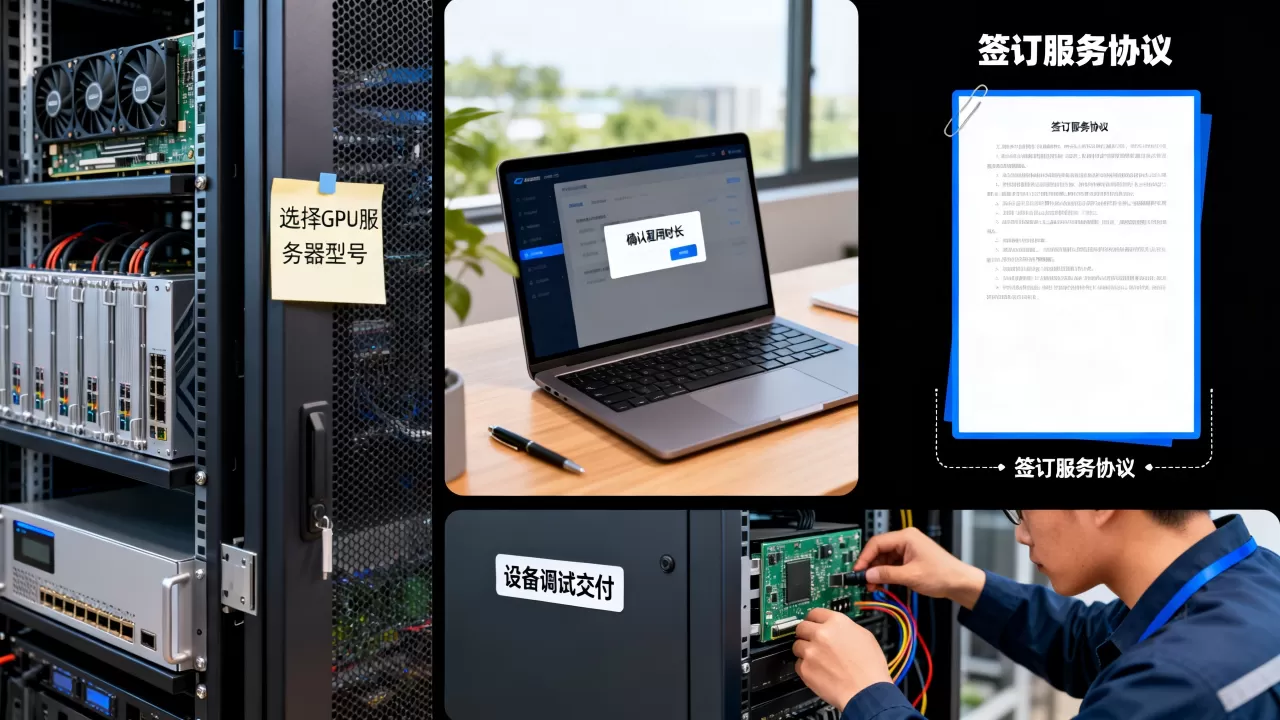
测试期结束后,再跟服务商做一次“配置签字确认”,保证硬件清单与合同一致,例如网卡为双万兆型号、内存为ECC专用颗粒。
Q&A:广州GPU服务器租用中的常见疑问
Q1:广州GPU服务器租用哪家好,是不是大厂一定可靠
大厂可靠性确实更高,但广州本地也有一些专业做GPU租赁的中型服务商,它们的价格更灵活且响应更快,选择核心标准有三条:是否具备自营机房、是否提供售后工单系统、是否支持测试IP,你可以先购买半个月或一个月的短期包,亲自感受维修响应速度和网络抖动幅度,再做长期决定。
Q2:租用GPU服务器能安装自己的软件和系统镜像吗
绝大多数服务商允许你重装镜像,你可以在交付后使用dd命令或者服务商提供的客户控制台,安装自己定制的Ubuntu版本和内核组件,部分高安全企业要求物理机环境上安装VMware或KVM虚拟化,这也可以手动搞定,但需要确认服务商开启了物理机的VT-d和SR-IOV功能,如果不懂底层设置,购买前可先询问该服务商是否支持预装异构计算框架,避免后续出现兼容性麻烦。
Q3:GPU服务器的数据备份怎么做最稳妥
GPU服务器的本地硬盘一般用于加速数据读取,不是数据长期保存的最佳位置,推荐用对象存储或网盘存储库备份训练权重,行业共识认为,定期在凌晨业务低峰期将检查点文件(Checkpoint)传到服务商的对象存储中,比用磁带备份方便得多,特别大的数据集请求服务商挂载一个共享NAS目录,这个目录一般有多副本冗余存储,相对安全,若无专门备份方案,自动同步到另一台低价冷备份机器也是一个实在办法。
征用一台GPU服务器如同请来一位专业运动员,配置到位还得环境配合,把机房位置、硬件配置、合同条款和验收流程理顺,你的模型才能在真实业务里跑得稳,广州本地的网络优势才能真正发挥出来,按这套指南走一遍流程,你对GPU服务器使用中的常见障碍,就有了大半的主动权。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/727741.html