用堆栈虚拟机实现高效指令执行,核心在于把栈顶访问变成寄存器操作、把频繁指令合并成超指令、用内联缓存消除动态查找,并对热点代码做分层JIT编译。 下面从瓶颈、优化手段、场景对比、成本与调优几个角度拆开讲。
堆栈虚拟机指令执行为什么容易慢?
栈顶访问是最大开销来源
堆栈虚拟机的操作数默认放在求值栈上,每次加法、比较、跳转,都要先压栈、弹栈,再读写内存,栈指针频繁移动,CPU流水线容易被打断,缓存局部性也不理想。

- 每条指令都要访问栈顶,内存读写次数多。
- 栈指针变化频繁,分支预测器难以稳定命中。
- 操作数不在寄存器中,分派后还要额外加载。
解释器循环的分支预测难题
经典解释器用switch-case分派指令,每条指令执行完都要回到循环开头,间接跳转多,分支预测失败率较高。
- 分派开销可能占据解释执行时间的较大比例。
- 可以用计算goto(computed goto)减少循环回跳。
- 尾调用优化也能降低部分开销。
内存分配与对象模型拖累
动态类型检查、对象头、垃圾回收都会拖慢执行,值类型和引用类型混在一起,缓存命中率下降,多数情况下,对象分配越频繁,解释器越难跑快。
堆栈虚拟机如何优化指令执行效率?从解释器循环到JIT
指令融合与超指令
把频繁出现的指令序列合并成一条超指令,减少分派次数。
- 将
LOAD_CONST和ADD合并为ADD_CONST。 - 将
LOAD_LOCAL、LOAD_LOCAL、ADD合并为ADD_LOCAL_LOCAL。 - 在字节码生成阶段识别模式,直接输出融合指令。
栈缓存与寄存器映射
把栈顶2到4个元素缓存在CPU寄存器中,例如
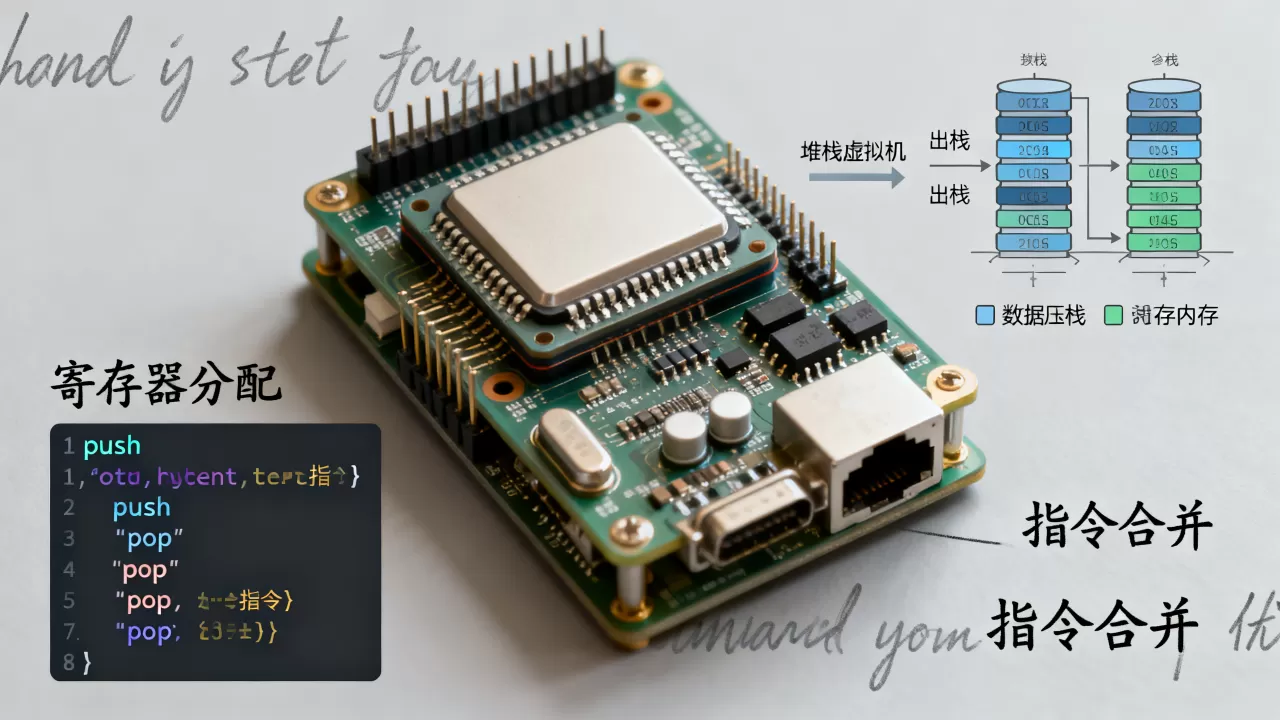
reg_top、reg_next,栈深度变化时再同步回写内存,业内专家指出,这种栈缓存能显著降低内存访问次数。
- 解释器循环内用局部变量保存栈顶值。
- 压栈弹栈时优先操作寄存器,延迟写回。
- 遇到函数调用或异常时,再刷新到真实栈。
内联缓存与快速路径
对属性访问、方法调用,缓存上次的类偏移或函数指针,下次遇到相同类型,直接走快速路径。
if (obj->class == cached_class) {
    result = (obj + cached_offset);
} else {
    // 慢路径:查找并更新缓存
}
多态内联缓存可处理2到4种类型,超过阈值再退化为全局查找。
即时编译与分层执行
解释器先跑,统计热点计数器,超过阈值触发基线JIT,再触发优化JIT。
- 典型分层:解释器 -> 模板JIT -> 优化JIT。
- 热点计数可以用
counter++,阈值根据场景调整。 - 命令:
perf record -g ./vm,perf report找热点函数。
实操步骤:用C语言实现带栈缓存的解释器循环
- 定义指令枚举和分派表。
- 用局部变量缓存栈顶:
Value a = stack[sp-2]; Value b = stack[sp-1]; - 用计算goto:
static void dispatch[] = { &&op_add, &&op_sub, &&op_load };
goto dispatch[code[pc++]];
op_add:
    sp -= 2;
    stack[sp] = a + b;
    goto dispatch[code[pc++]];
- 编译:
gcc -O2 -fno-gcse -o vm vm.c - 性能分析:
valgrind --tool=callgrind ./vm,再用callgrind_annotate查看热点。
堆栈虚拟机和寄存器虚拟机性能对比:谁更适合你的场景?
|
维度 | 堆栈虚拟机 | 寄存器虚拟机 |
|---|---|---|
| 指令长度 | 较短,但指令数多 | 较长,指令数少 |
| 栈操作 | 频繁压栈弹栈 | 直接操作寄存器 |
| 分派开销 | 较高 | 较低 |
| JIT友好度 | 需要栈到寄存器映射 | 天然适合JIT |
| 典型代表 | JVM早期、CPython、WebAssembly | Lua 5.x、Dalvik、V8 Ignition |
行业共识认为,纯栈式解释器在无优化时性能通常低于寄存器式解释器,但通过栈缓存和JIT可以缩小差距。
嵌入式场景下的堆栈虚拟机指令优化怎么做?
嵌入式资源受限,优先解释器优化,慎用JIT。
- 指令融合和栈缓存最有效。
- 减少动态内存分配,用固定大小栈。
- 开启编译器优化:
-Os -flto。 - 用
perf stat监控指令数和缓存命中率。 - 据公开的编程语言实现资料(如Lua、Python、WebAssembly社区文档),这些手段在低端MCU上也能带来可感知的提升。
服务端高并发场景的取舍
服务端可上分层JIT,吞吐量优先,堆栈虚拟机在WebAssembly中常见,适合沙箱和多语言,寄存器虚拟机在Lua等脚本引擎中延迟更低,如果业务需要热更新和隔离,堆栈虚拟机往往更省心。
堆栈虚拟机引擎开发成本大概多少?国内团队方案解析
堆栈虚拟机引擎开发成本大概多少
自研解释器以人力成本为主,1到2名工程师数月可出原型,加JIT需要编译背景,成本上升较大比例,用现成框架如WebAssembly运行时、Lua、CPython,改造成本低,国内一线城市资深虚拟机工程师薪资较高,具体价格因团队而异。
国内堆栈虚拟机性能调优实践与工具链
- 用
perf、gprof、callgrind定位热点。 - 用
cachegrind分析缓存未命中。 - 字节码设计:定长指令、立即数、局部变量索引。
- 栈缓存实现后,跑分对比:
hyperfine './vm_old' './vm_new'。 - 国内团队常参考WebAssembly、Lua、Python社区文档,逐步迭代。
调试与验证命令
perf stat -e cycles,instructions,branches,branch-misses ./vmvalgrind --tool=cachegrind ./vmgdb --args ./vm program.bchyperfine --warmup 3 './vm_old' './vm_new'
Q&A:堆栈虚拟机高效指令执行的常见疑问
堆栈虚拟机如何优化指令执行效率?如何衡量优化效果?
优化手段包括指令融合、栈缓存、内联缓存、计算goto、分层JIT,衡量用perf stat看每指令周期数、分支预测失败率,用hyperfine测墙钟时间,对比优化前后指令数和缓存命中率,就能判断收益。
堆栈虚拟机和寄存器虚拟机性能对比,哪个更快?
无优化时寄存器虚拟机通常更快,因为少了压栈弹栈,但堆栈虚拟机加上栈缓存和JIT后,差距会明显缩小,选择取决于场景:嵌入式优先堆栈,服务端可考虑寄存器或混合方案。
堆栈虚拟机适合嵌入式和物联网设备吗?
适合,堆栈虚拟机指令紧凑、实现简单、沙箱安全,适合资源受限设备,通过指令融合和栈缓存,可以在低端MCU上获得可接受的执行速度,多数情况下,解释执行已足够,不必上JIT。
用堆栈虚拟机跑出高效率,不是换一种指令格式就完事,而是要把栈顶缓存、指令融合、内联缓存和分层JIT串成一条流水线,抓住热点路径,用工具量出来,再针对性优化,才能让解释器循环真正跑快。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/728652.html