服务器优化的核心在于从硬件、软件、网络、安全四个维度协同调优,优先排查CPU、内存、磁盘IO和带宽瓶颈,再结合缓存策略与架构升级,才能以最低成本换取最高性能。
先看懂瓶颈藏在哪:性能监控是优化前的第一步
很多站长一上来就调整各种参数,结果事倍功半,正确的做法是先部署监控工具,用数据说话,推荐使用Prometheus + Grafana组合,或者云厂商自带的监控控制台。
需要重点盯住四个指标:
- CPU使用率:持续高于80%就得排查进程,区分是用户态消耗还是系统态消耗
- 内存水位:Swap分区频繁读写是危险信号,物理内存不足会拖垮整机响应速度
- 磁盘IO延迟:iowait长时间超过10%,说明存储层拖后腿了
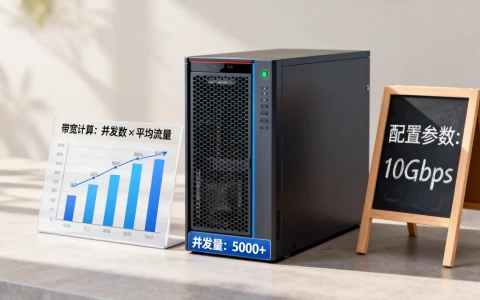
- 带宽占用率:接近上限时延迟会成倍增加,并非线性的关系
监控数据的留存周期建议至少90天,这样能对比出业务高峰期的资源水位,没有监控数据做基础的优化,都是拍脑袋。
服务器硬件层面的优化策略
处理器的选择与调度逻辑
CPU不是核心数越多越好,关键看单核主频和架构匹配度。高并发计算密集型业务,例如视频转码、科学计算,选高主频的AMD EPYC或Intel至强系列。高并发IO密集型业务,比如Web集群、缓存中间件,核心数多的CPU更适合,因为要同时处理海量连接。
操作系统层面的调优也不容忽视,启用了CPU调频策略的服务器,默认在省电模式“powersave”下,性能会大打折扣,改成交互式调度器“performance”模式,通常能直接带来几分之一的性能提升。
内存的容量与通道配置
内存建议做到“宁多勿缺”,并且一定要组成多通道,单条32GB和4条8GB组四通道,内存带宽差距巨大,数据库类的服务,缓存命中越依赖物理内存,因为在内存里取数的速度是磁盘的数十万倍。
虚拟内存的调优参数vm.swappiness建议设置在10以内,这个值控制着系统优先使用物理内存还是交换分区,设成默认的60,意味着内存还有富余时就开始往Swap里写数据,徒增磁盘读取的开销。
磁盘类型的选型与阵列策略
- 数据库热数据盘:NVMe SSD是底线,千万别用SATA机械盘
- 冷数据备份盘:机械硬盘做RAID 5或RAID 10,容量大且成本低
- 日志文件盘:普通SSD足够,不需要太高的随机读写能力
RAID卡的缓存策略要设置为回写模式(Write Back),先写进RAID卡缓存再落盘,能显著降低磁盘写入延迟,如果数据安全级别要求不高,禁止掉电保护(BBU)的直通模式会更省心。
软件层面:操作系统与应用服务的调优
内核参数与文件句柄限制
Linux系统默认的文件描述符上限是1024,放在高并发场景下根本不够用,修改/etc/security/limits.conf,把nofile软硬限制调到65535以上,重启后生效。
TCP/IP协议栈的参数也要动一动:
- net.core.somaxconn:监听队列长度,默认128,建议1024起步
- net.ipv4.tcp_tw_reuse:开启后允许TIME_WAIT状态的连接被复用,用于短连接服务
- net.ipv4.tcp_max_syn_backlog:半连接队列,防SYN洪泛攻击时有效
Web服务的并发模型选择
Nginx作为反向代理,worker_processes数设置为CPU核心数即可,worker_connections调到10240以上,同时开启gzip压缩,能减少一半以上的传输体积。
Tomcat或Apache这类Java容器,线程池参数不能照搬默认值,maxThreads设置在200到500之间,acceptCount和maxThreads保持同量级,线程数开太高反而会增加上下文切换的负担。
数据库缓存命中率的提升空间
MySQL的innodb_buffer_pool_size建议设置为物理内存的60%-70%,这个值偏低会导致热数据频繁落磁盘,查询响应时间直线飙升,调整后观察缓存命中率,低于95%大概率要扩容。
慢查询日志一定要开启,命令排查慢SQL,大多数性能灾难都是因为几条没走索引的查询把IO资源吃光了。
网络层面的加速与稳定:用户感知最直接
CDN与静态资源分流
静态资源(图片、CSS、JS)没上CDN的服务器,简直是在浪费带宽,CDN把内容缓存到离用户最近的边缘节点,源站的压力只剩动态请求,据公开资料显示,接入CDN后源站带宽消耗普遍能下降
一半以上。
动态请求路径的优化也不难理解:Gzip压缩至少减少三分之一传输体积,HTTP/2多路复用解决了并发连接数限制的问题,2026年标配的HTTP/3(QUIC)基于UDP,弱网环境下丢包重传的延迟更低。
地域节点与机房线路的选址
这个问题通常被称为“服务器怎么选机房”,多数的场景下,目标用户在国内的,机房优先选华东或华北核心节点,“国内服务器和海外服务器延迟对比”的差距很明显从美国西海岸回源国内的延迟动辄150ms以上,而国内主要城市之间的BGP线路延迟普遍在20ms-40ms。
跨境业务视情况选择香港地区节点或新加坡节点,持牌照需求量大的时候,采用多线BGP或CN2 GIA线路是行业共识,跑视频会议或实时音视频的业务,绝对不能省这个钱。
安全层面的优化:性能稳定的隐性基石
网络安全组与防火墙的精细规则
别用默认放行的安全组策略,只开放业务必需的端口,数据库端口(3306、6379等)绝不能让公网直接访问,接堡垒机做端口转发才是正确的打开方式,被DDoS攻击时,高防IP的清洗能力比裸奔的源站IP可靠得多,部署流程不过几分钟。
系统加固与账户权限的收拢
root口令不能用弱密码,SSH端口从默认的22换掉,并关闭密码登录改用密钥认证是最低成本的优化。
- 修改/etc/ssh/sshd_config中PermitRootLogin为no
- 设置fail2ban自动封禁暴力破解的IP来源
- 定期用yum update或apt upgrade修补内核安全漏洞
安全层面做好少一次被入侵的清理工作,服务器的平均负载就是赚到,业内专家指出,相当一部分云上安全事故源于端口暴露和弱口令,而非系统本身的漏洞。
架构层面的演进:从单机到集群的质变
读写分离与缓存层
单机MySQL扛到瓶颈后,最直接的方案就是一主两从的读写分离架构,写操作走主库,读操作分摊到从库,连接管理交给代理层(如ProxySQL),应用端的代码改动非常少。
热数据的下一步是Redis缓存层,把接口的QPS从几百提升到上万的关键操作,像用户会话、验证码、商品详情之类的key-value数据,走Redis后数据库的IO压力瞬间下降两个量级。
无状态应用与水平扩容
应用层的Session沾在单台服务器上,扩容就受限制,将Session抽离到Redis或独立存储,让应用变成无状态,这样遇到活动点名时,临时增加两台云服务器即可扛住峰值流量,活动结束后释放资源,“服务器租用价格对比”方面,云厂商按量付费模式比包年包月更划算,弹性扩容正是针对这个场景的。
容器化与编排调度
Docker镜像打包环境,Kubernetes自动调度容器副本数,通过HPA(水平Pod自动伸缩) 依据CPU和内存指标扩缩容,让运维省心省力,但容器化并非银弹,日志采集、持久化存储、网络策略的改变都需要额外学习成本,建议从边缘非核心业务开始替换。
优化收益复盘与日常运维习惯
服务器优化不是一次性项目,PDCA的循环不能断,每次变动前先对核心指标做基线快照,调整后再跑一轮对比测试,观察响应时间的变化趋势,压测工具推荐wrk或JMeter,压测规模至少是业务峰值的5倍以上。
定时巡检的项里,磁盘空间占用、日志清理策略、备份任务执行结果这老三样最容易被忽视,长期运行的服务器上,磁盘写满不清理导致服务崩溃的例子并不少见。
服务器优化常见问题解答
网站访问慢的排查步骤是什么?
按顺序检查:本地DNS解析时长、CDN命中情况、网络链路丢包率、服务器CPU负载、数据库慢查询数量,多数情况下,打开浏览器开发者工具看瀑布图,哪个阶段耗时高就去优化哪一个环节。
服务器配置高就一定跑得快吗?
配置高只是底子好,不代表性能自动达标,未经调优的默认内核参数、未开启的缓存策略、冗余的监听进程,都会白白浪费硬件资源,配置再高,软件层面的瓶颈不解除,体验依然拉垮。
服务器租用价格和性能怎么权衡?
公司内网使用的系统,低配独享物理机即可,面向公网的业务,云服务器按需付费配合负载均衡更适合;部署高并发业务集群时,物理机加私有云的成本可控性更利于长期规划。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/730071.html