本地GPU跑大模型到底怎么样?真实体验聊聊这一话题在技术圈热度居高不下,直接给出核心结论:对于开发者、隐私敏感型用户及AI发烧友而言,本地部署大模型是极具价值的“刚需”;但对于仅追求对话流畅度、不愿折腾硬件的普通用户,云端服务仍是首选,本地运行的核心优势在于数据隐私绝对可控与无限制的定制化微调,而劣势则集中在高昂的硬件门槛与复杂的运维成本,体验的好坏,本质上取决于你的显卡显存大小与对量化技术的掌握程度。
硬件门槛:显存是决定体验的“硬通货”
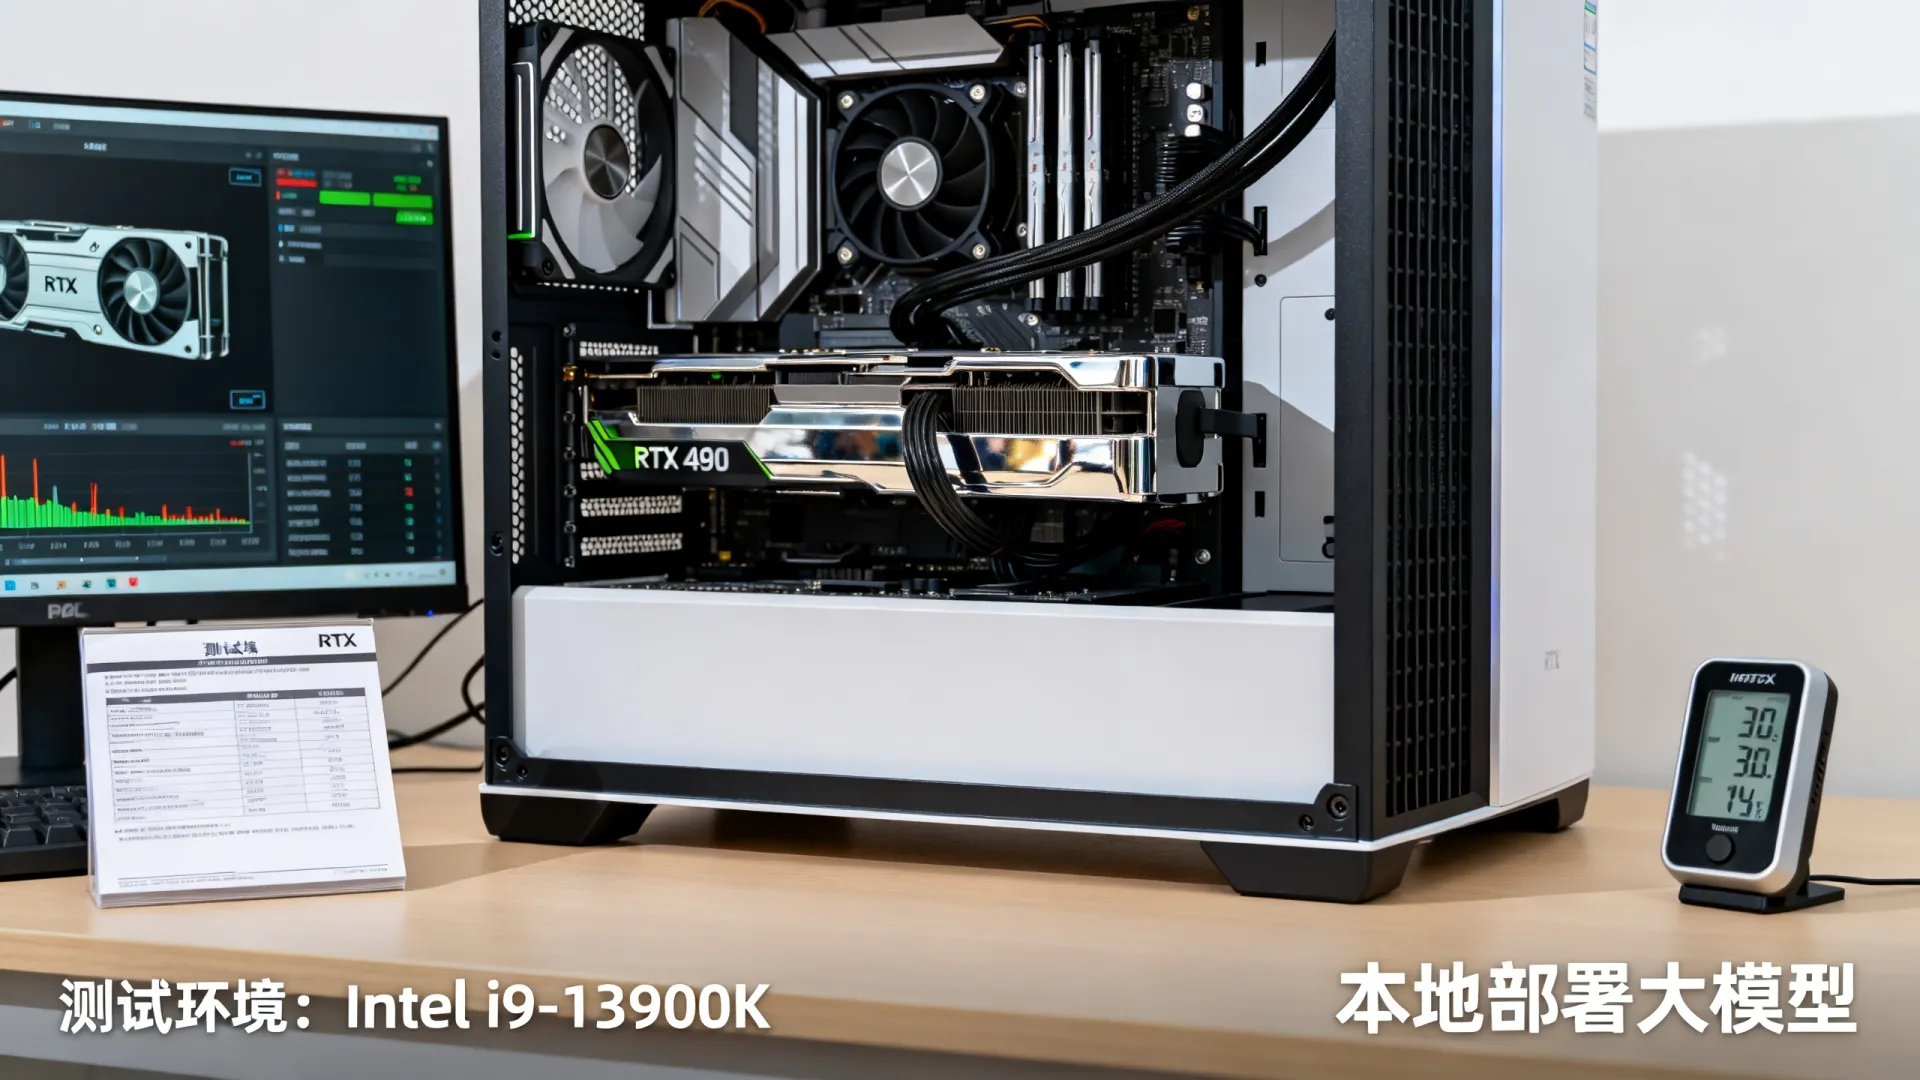
想要获得流畅的本地体验,硬件配置是第一道关卡,不同于游戏渲染,大模型推理对显存容量的敏感度远高于核心频率。
- 显存容量决定模型上限,模型参数量与显存占用呈正比,运行7B(70亿参数)级别的模型,至少需要6GB-8GB显存;想要运行13B-20B参数的模型,12GB-16GB显存是起步线;若想挑战70B甚至更高参数的旗舰模型,通常需要双卡互联或专业计算卡,显存需求飙升至48GB以上。
- 消费级显卡的性价比之选,NVIDIA RTX 3060 (12GB) 是入门首选,RTX 4090 (24GB) 则是民用级天花板。显存带宽同样关键,GDDR6X显存能显著提升Token生成速度,若显存不足,系统会调用系统内存,速度会呈断崖式下跌,体验极差。
- 苹果Mac系列的异军突起,搭载M系列芯片的Mac电脑,凭借统一内存架构,能将大模型直接加载至内存,虽然推理速度不及顶级独显,但运行30B甚至70B模型的门槛大幅降低,适合低频次、大参数量的尝鲜用户。
软件生态:工具链成熟度超预期
过去本地部署需要手动配置CUDA环境、编译Transformers库,如今工具链已高度成熟,大幅降低了上手难度。
- Ollama与LM Studio,这两款工具是目前最主流的解决方案,Ollama主打命令行简洁体验,一行代码即可拉取并运行模型;LM Studio则提供图形化界面,支持GGUF格式模型的直接下载与对话,适合非程序员用户。
- 量化技术的关键作用,为了在有限显存中塞入更大模型,4-bit量化已成为行业标准,通过降低模型精度(如从FP16量化至INT4),显存占用可减少约60%,而推理能力的损失微乎其微,真实测试表明,经过良好量化的13B模型,其综合表现往往优于未量化的7B模型。
- 推理后端的选择,对于专业开发者,vLLM和TensorRT-LLM提供了极高的推理吞吐量,适合在本地搭建高并发API服务,这要求用户具备较强的Docker容器化部署能力。
真实性能表现:速度与智能的权衡
在本地实测中,性能表现呈现出明显的“边际效应递减”特征。
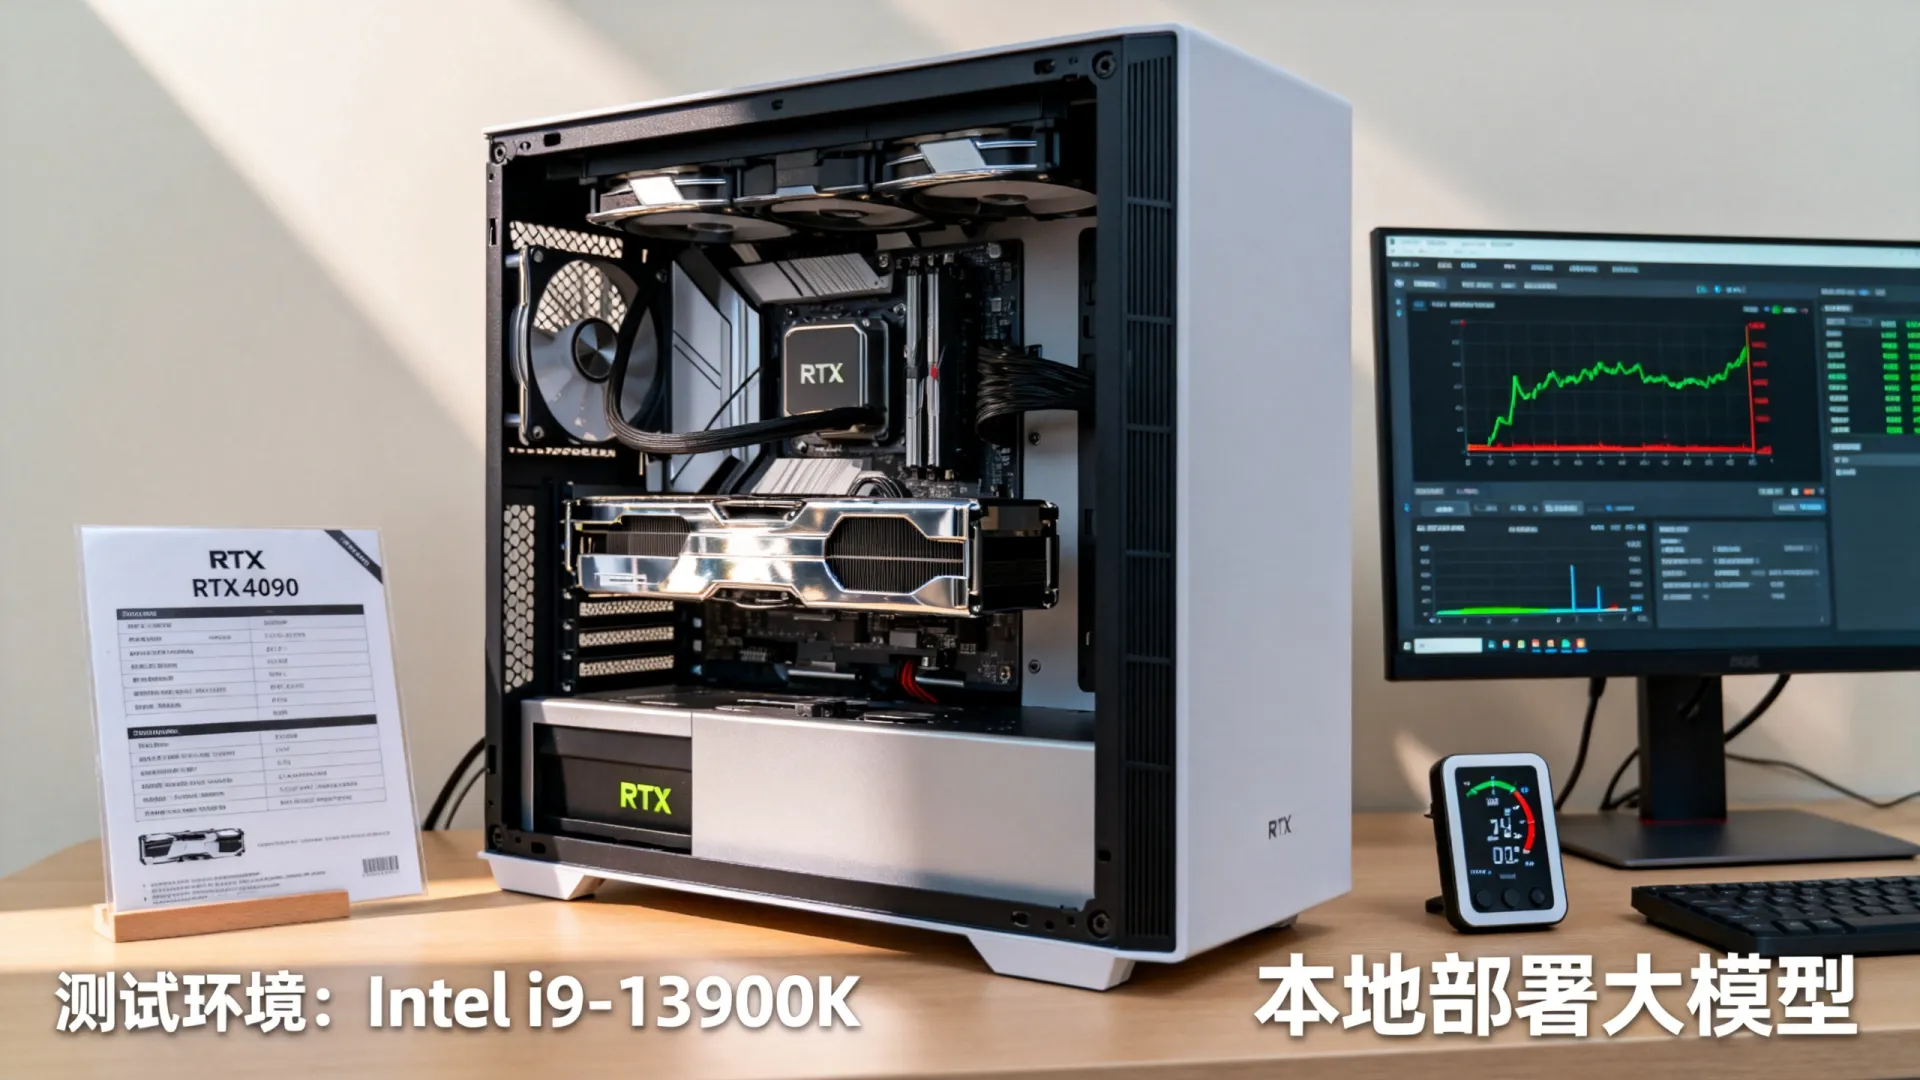
- 生成速度实测,以RTX 4090运行Llama-3-8B-Instruct为例,4-bit量化下,生成速度可达80-100 tokens/秒,阅读体验极度流畅,几乎无感延迟,而在RTX 3060上运行相同模型,速度约为20-30 tokens/秒,虽不及云端GPT-4 Turbo,但已能满足日常交互需求。
- 上下文长度瓶颈,本地运行长上下文(Context Window)是巨大挑战,当上下文长度超过4K时,显存占用会激增,若强行开启128K上下文,普通消费级显卡极易爆显存(OOM),本地模型更适合短文本处理、代码补全,而非长篇文档分析。
- 模型智商的差异,必须承认,本地开源模型(如Llama 3、Qwen1.5、Mistral)在逻辑推理、代码生成上已逼近GPT-3.5水平,但在复杂指令遵循和多轮对话的稳定性上,与GPT-4仍有差距。
核心价值:隐私与定制的双重红利
既然云端API如此便捷,为何还要费力本地部署?核心动力源于两大深层需求。
- 数据隐私的“物理隔离”,对于企业内部代码、个人敏感数据、医疗法律文档,上传至云端API存在潜在泄露风险,本地部署实现了数据不出域,物理层面保障了安全,这是金融、法律、医疗等行业选择本地算力的根本原因。
- 微调与个性化,云端大模型是“通用大脑”,而本地模型可以通过LoRA(低秩适应)技术,喂入个人笔记、专业语料进行微调,训练出专属的“私人助理”,你可以微调一个懂你写作风格的文案助手,或熟悉公司内部API的代码助手,这是通用云端模型无法提供的体验。
成本效益分析:买卡还是买API?
从经济角度看,本地部署并非总是划算。
- 高频使用场景,如果你每天需要处理数百万Token的文本,购买一张高端显卡并在本地运行,长期成本远低于调用OpenAI API,硬件是一次性投入,而API是持续消耗。
- 低频/轻量场景,如果仅是偶尔翻译文档或写写邮件,云端API的按量付费模式更灵活,一张RTX 4090的价格足以支付数年的常规API调用费用。
- 电力与损耗,显卡满载运行功耗惊人,RTX 4090满载功耗可达450W,长期运行的电费开支不容忽视,且消费级显卡并不适合7×24小时高负载运行,硬件故障风险随时间累积。
避坑指南与优化建议
基于实战经验,以下几点建议能有效提升体验:
- 优先选择GGUF格式,这是目前兼容性最好、社区支持最完善的量化格式,支持CPU+GPU混合推理,能有效缓解显存压力。
- 关注显存带宽而非算力,选购硬件时,不要只看TFLOPS算力指标,大模型推理是典型的“访存密集型”任务,显存带宽决定了Token输出速度。
- 利用系统内存兜底,在显存不足时,Ollama等工具会自动将部分层卸载到CPU内存运行,虽然速度变慢,但能让你在低配电脑上跑通大参数模型,用于测试非常实用。
本地gpu跑大模型到底怎么样?真实体验聊聊,它是一场关于控制权与便利性的博弈,如果你追求数据主权、渴望定制化模型,且具备一定的硬件基础,本地部署带来的成就感与实用性无可替代;反之,如果只是寻求最高效的AI对话,云端服务依然是性价比之王。
相关问答
问:本地运行大模型,显卡显存不够用怎么办?
答:显存不足主要有三种解决方案,第一,使用更高程度的量化模型,例如从Q4_K_M切换至Q3_K_S,虽然会轻微损失智能度,但能大幅降低显存占用;第二,开启“卸载”模式,利用Ollama等工具将部分模型层加载至系统内存,由CPU协助计算,代价是推理速度变慢;第三,选择参数量更小的模型,如从Llama-3-70B降级至8B版本,小参数模型在特定任务上的表现往往优于显存溢出导致卡顿的大模型。
问:本地部署大模型对CPU有要求吗?
答:有要求,但不如显卡关键,CPU主要负责数据预处理、指令调度及部分GPU无法覆盖的计算任务,对于纯推理场景,现代主流CPU(如Intel i5/i7或AMD Ryzen 5/7)通常不会成为瓶颈,但在CPU推理模式下,CPU的核心数、频率以及内存带宽(支持双通道或多通道)将直接决定推理速度,CPU需要支持特定的指令集(如AVX2、AVX-512),这能显著提升推理效率。
你是否尝试过在本地部署大模型?在硬件选择或环境配置上遇到过哪些“坑”?欢迎在评论区分享你的实战经验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/73416.html