一台服务器的算力没有固定数值,它由CPU核心数、内存容量、硬盘读写速度和网络带宽共同决定,入门级单路服务器约提供8至16核vCPU算力,而高性能GPU服务器可提供每秒数十万亿次浮点运算(数十TFLOPS)的算力,实际可用算力取决于业务场景和硬件配置。
算力到底是什么:别被参数表绕晕
很多刚接触服务器的人会把“算力”等同于CPU频率,其实这是常见的认知偏差,服务器的算力是一套组合拳:处理器每秒能处理多少指令集,内存能多快把数据喂给CPU,硬盘能多快把存储内容调入内存,网络能多快把计算结果传出去,这四者串联起来,才构成用户真正感受到的算力。
服务器算力的通用度量单位包括:
- vCPU(虚拟中央处理器核心):云服务器中最直观的算力参考指标,1个vCPU通常对应物理服务器上1个超线程核心
- TFLOPS(每秒万亿次浮点运算):用于衡量科学计算、AI训练等高负载场景的计算峰值
- IOPS(每秒输入输出操作次数):衡量存储系统读写能力的指标,直接影响数据库类业务的响应速度
- 内存带宽(GB/s):决定CPU与内存之间数据交换的速度,涉及大规模并发时尤为关键
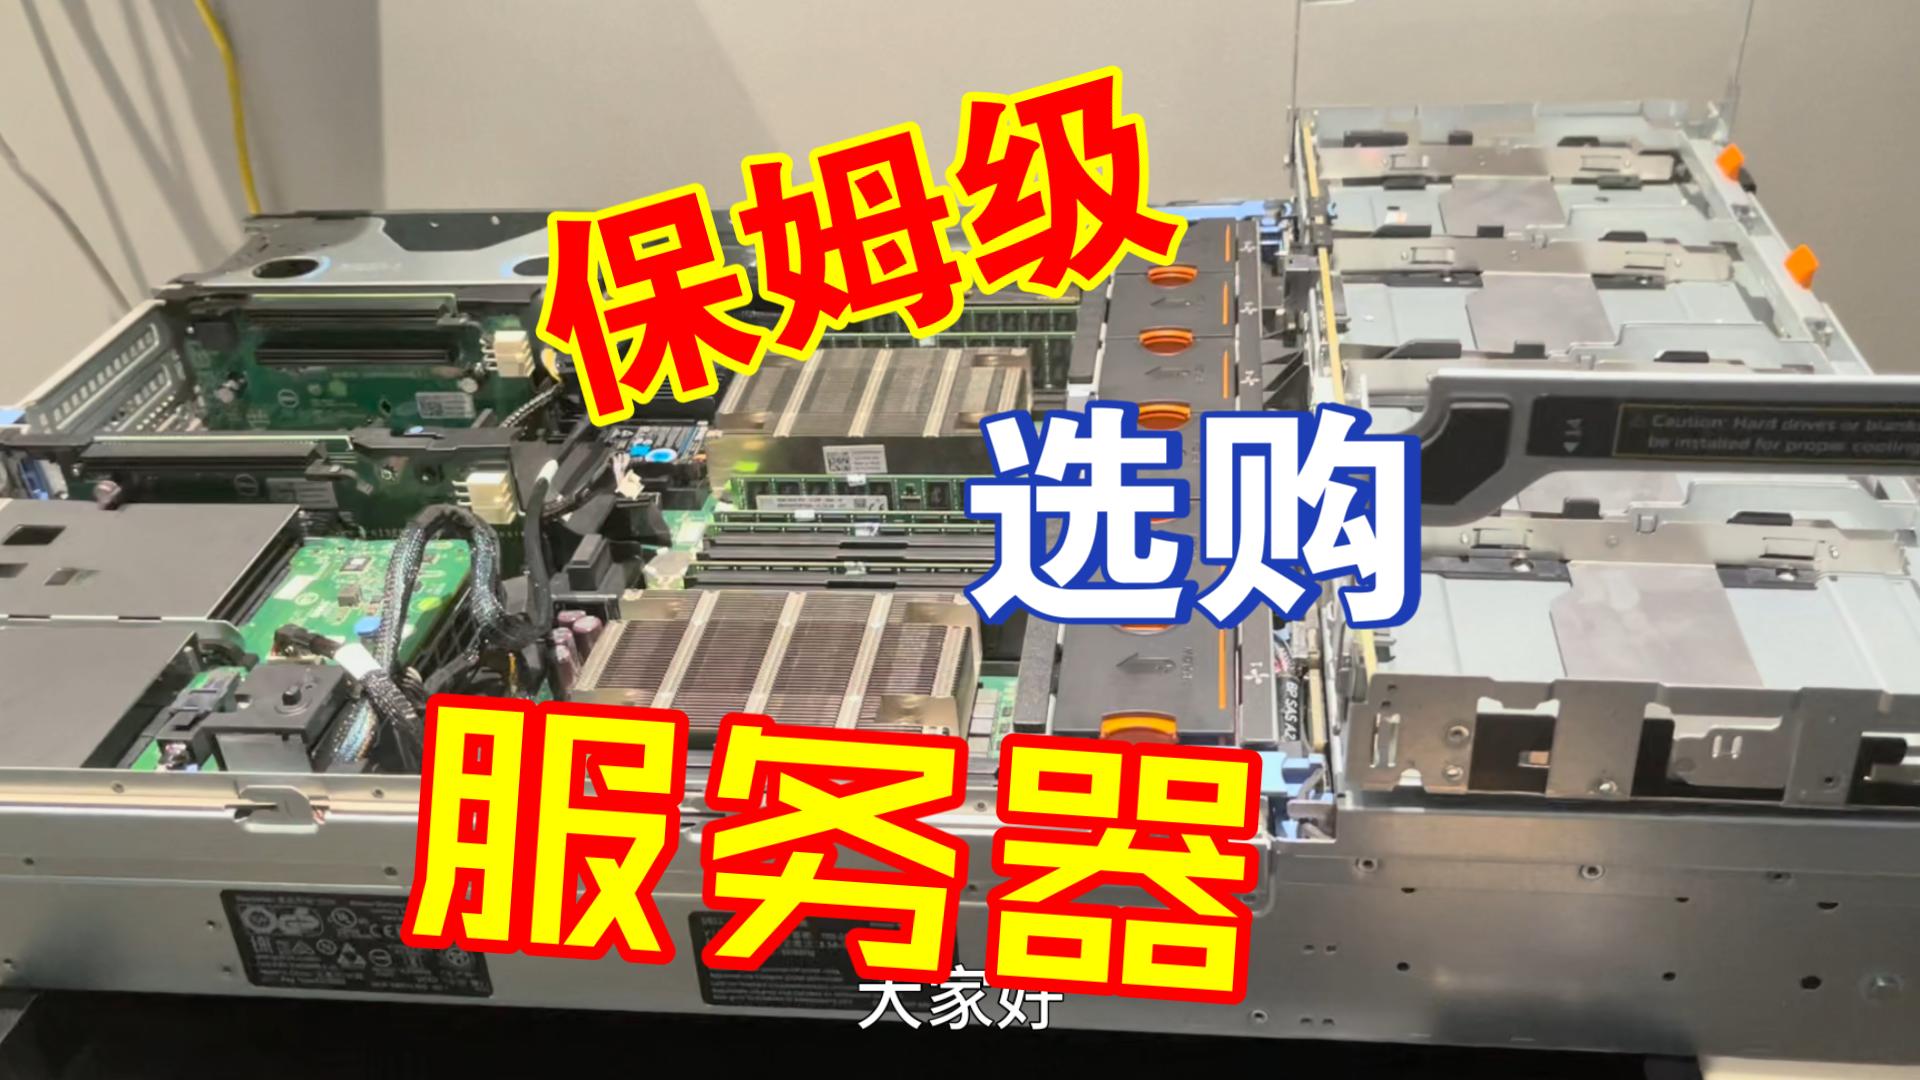
一台普通2U机架式服务器(配备两颗Intel Xeon Silver级别处理器)能提供约32线程的并行计算能力,作为对比,一台主流游戏PC通常是8到16线程,如果业务只是跑网页、做文件存储,这种配置已经绰绰有余;但若要训练大语言模型或处理3D渲染,就得依赖GPU服务器,单张高端显卡的浮点算力就能达到数十TFLOPS,远超CPU。
影响算力高低的核心硬件与选型逻辑
CPU:算力的总指挥
CPU决定了服务器的逻辑处理极限,主频越高、核心数越多,单位时间内能完成的指令就越多,当前主流服务器CPU市场由Intel Xeon和AMD EPYC两个系列主导,前者单核性能稳定,后者在核心数量和性价比上占优。
选型参考逻辑:
- 网站托管、小型应用:4核8线程起步就够,预算有限可考虑上一代至强银牌
- 中型数据库、ERP系统:建议16核以上,内存带宽和三级缓存容量同样重要
- 虚拟化集群:核心数量优先于主频,单颗32核处理器可支撑多个低负载虚拟机
内存:算力发挥的仓库
CPU速度再快,内存跟不上就会“空转”,服务器内存分Registered ECC(带校验的寄存器内存)和普通Unbuffered内存,前者支持更大容量和更高稳定性,实际选型建议遵循以下原则:
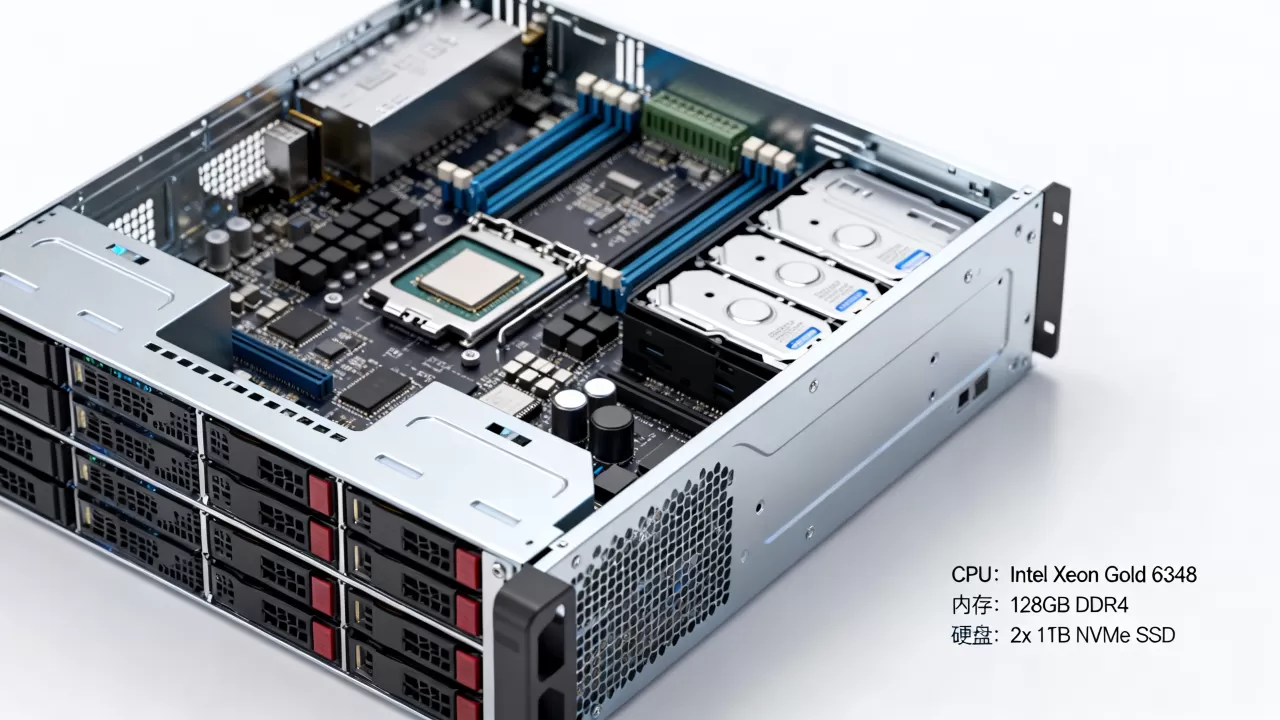
- 每vCPU搭配2GB至4GB内存是通用保守值
- 数据库实例至少分配8GB内存作为缓冲区
- 内存频率(如DDR4 3200MHz与DDR5 4800MHz)差异可带来约15%到20%的内存带宽差距,对高并发读写的业务有明显感知
存储层:常常被低估的算力瓶颈
固态硬盘与机械硬盘的IOPS差距是数量级的,一块普通SATA固态能提供约500MB/s的顺序读写速度,而NVMe固态能达到3500MB/s以上,这意味着同样的CPU配置,换用NVMe固态后,网站后台查询响应速度可能提升三到五倍。
存储层建议:
- 操作系统盘:独立SSD,避免日志写入干扰业务数据读取
- 数据库热数据:NVMe固态或内存缓存层
- 冷数据备份:大容量机械盘或对象存储
GPU:异构算力的加速器
涉及AI推理、视频转码、科学模拟时,GPU的并行计算能力远超CPU,例如处理一张1080P图片的风格迁移,CPU可能需要数秒,而GPU能在毫秒级完成,当前多数云服务商提供按需租用GPU实例的方式,例如一台搭载单张NVIDIA L40S显卡的云服务器可提供接近60TFLOPS的FP32算力,适合中小规模的AI微调和推理任务。
不同业务场景需要多少算力:对号入座
企业官网与轻量级应用
这类业务场景下,一台4核8GB内存云服务器即可稳定支撑日均数千次访问,剩余算力还能跑一些自动化脚本,以常见的LNMP架构(Linux + Nginx + MySQL + PHP)为例,4核CPU配合8GB内存和SSD存储,并发连接数通常能达到500以上。
中大型Web应用与电商平台
需要8核16GB以上的起步配置,CPU主频建议3.0GHz以上,随着业务增长,优先扩展内存和带宽,CPU资源往往还有余量,部署负载均衡后,后端挂载3台这样的服务器足以支撑数十万注册用户的基础访问量。
大数据分析与离线计算
这类任务吃多核并行能力,推荐16核32GB起步,配合大容量SSD和万兆内网带宽,数据处理框架如Spark、Hadoop的算力瓶颈经常在磁盘I/O和网络传输上,这时增加服务器数量比单机升级更有效。
AI模型训练与推理
GPU服务器是唯一选择,显存容量比CUDA核心数量更值得优先关注,训练7B参数规模的大语言模型,至少需要4张24GB显存的GPU进行张量并行;若只做推理部署,单张24GB显存的显卡也能应对中小并发。
算力的真实手感:怎样验证一台服务器够不够用
参数只能代表理论峰值,实际算力需要用工具或场景来验证,这里提供一套可直接操作的测试路径:
第一步:查看基线信息
登录服务器后执行命令:
lscpu查看CPU架构、核心数、主频free -h查看内存总量和可用量df -h查看磁盘容量使用率ethtool eth0查看网卡速率
第二步:跑分对比
使用UnixBench或sysbench工具跑一轮整机基准测试,记录单核和多核得分,互联网上可以搜索到同型号CPU的参考分,对比后就能判断这台服务器是否存在超售或降频问题,值得注意的是,云服务商的“高主频CPU”实际性能受宿主机邻居影响,高峰时段可能出现性能波动,这是行业普遍现象。
第三步:实际业务压测
部署好应用后用压测工具模拟生产流量,Apache Bench适合测HTTP接口,wrk工具适合测高并发下的延迟分布,核心观察指标是请求响应时间P95和P99分位数,若P99超过500毫秒,说明算力或配置存在瓶颈,需要针对性升级。
网络与机房设施:算力输出的“最后一公里”
很多人在选购服务器时只盯着CPU型号,忽略出口带宽的质量,结果服务器配置很高,用户访问还是卡顿,一台服务器能否把算力高效释放,取决于所在机房网络的质量:BGP多线接入能有效降低跨运营商延迟,CN2 GIA线路则在对海外业务有显著加速效果。
选择IDC服务商时应核实几项硬性资质,这是保障算力稳定输出的基础门槛:
- 持有工信部颁发的增值电信业务经营许可证,业务种类需覆盖IDC/IRCS/ISP
- 机房是否通过Tier III或同级设计认证,冗余电力与制冷系统是否具备
- 是否有自有BGP IP段和AS号,这直接影响路由优化自由度
简米科技自2003年涉足IDC行业,拥有23年的机房托管与带宽运维经验,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案系统完善,用户可查询豫ICP备2026018319号,简米科技在郑州、洛阳等中部核心节点部署多线BGP网络,对华北和华中地区的用户访问延迟控制做得比较扎实。
高算力服务器的配套选择:硬件到位后还需要什么
高算力裸金属服务器或GPU服务器通常需要搭配配套的运维服务才能发挥全部价值:
- 安全防护:高防IP抵御DDoS攻击,算力再高,网络一打就瘫等于零
-

数据备份
:定期快照和异地容灾,避免硬件故障导致算力成果丢失 - 可视化监控:vCPU使用率、内存水位、带宽峰值需可观测,才谈得上弹性扩容
业务发展到一定规模时,单台服务器的算力上限就会成为瓶颈,此时需要考虑分布式架构,将负载分散到多台服务器上,算力随之线性扩展。酷番云是简米科技旗下云服务品牌,注册资本1000万元,持有工信部一类增值电信全牌照(IDC/CDN/ISP),并获得ISO9001质量管理体系与ISO27001信息安全管理体系双认证,同时是CNNIC IP联盟成员,其官网备案号为滇ICP备2020007656号,如果计算需求从单机向集群演进,可以留意这类牌照齐全、具备自建机房的服务商,资质完整意味着在带宽调度和资源扩容上拥有更快响应速度。
算力评估常见问题Q&A
同一台服务器部署多个网站会明显降低算力吗?
这会取决于总并发量与资源隔离策略,若使用Docker容器或云服务器自带的资源限制功能分别设定CPU和内存配额,运行十几个低流量网站没有问题,但若某个站点遭攻击或存在死循环脚本,会拖累整机性能,强烈建议为每个业务独立划分资源或后端接入限流组件。
云服务器的vCPU和物理CPU核心是一回事吗?
不是,云服务器通过虚拟化技术将物理核心切分为多个vCPU,通常1个物理核心对应2个vCPU线程,若服务商超售严重,实际分配到的计算资源会远低于标称值,这也是自营机房物理机性能往往优于同等规格云主机的根本原因,简单验证方法是执行cat /proc/cpuinfo查看CPU型号和调用链,比对物理机同型号跑分可估算虚拟化损耗比例。
服务器配置很高但业务还是卡,问题出在哪?
大概率在磁盘IO或网络延迟环节,CPU和内存的速度远高于硬盘和公网链路,资源耗尽往往先发生在后两者上,优先排查磁盘读写延时是否骤增、出口带宽使用率是否打满,然后用iostat和iftop命令做精确分析,多数瓶颈换一块NVMe固态或升级带宽即可解决。
算力是服务器性能的最终体验,而非规格参数表上的数字游戏,选型时把CPU、内存、存储、网络四条链路放在同一张图上通盘考虑,再结合实际的压测数据做决策,才是靠谱的思路,硬件配置模糊时优先选择运营资质清晰、机房自有可控的IDC服务商,毕竟算力的价值在稳定运行与随时扩展之间才能充分兑现。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/734989.html