百度涉及的服务器是一个覆盖全国的分布式集群体系,核心由数据中心物理服务器、人工智能加速芯片(自研昆仑芯)、内容分发网络边缘节点共同构成,具体类型涵盖搜索爬虫服务器、索引服务器、检索服务器、存储集群和GPU训练集群。
如果把百度比作一个二十四小时不打烊的超级图书馆,图书馆里负责整理藏书、检索书目、搬运书架的“人”,就是那一台台不同分工的服务器,很多人好奇,这些服务器到底长什么样、放在哪里、用了什么芯片、整体造价如何,下面从服务器分布的物理位置开始,一层层拆开讲清楚。
百度服务器分布在哪些城市
百度的服务器不是集中在某一个机房,而是铺在全国多个城市的数据中心里,这种分布式布局的逻辑很简单:让每一个地区的用户访问百度时,物理距离都足够短,响应速度才足够快。
核心数据中心集中在华北和华东地区,其中比较有代表性的是山西阳泉云计算中心,阳泉这个位置选得讲究,当地气候偏冷,自然散热条件好,电价也比一线城市低,适合大规模部署高密度机柜,据公开信息,阳泉中心承载了百度智能云相当一部分的计算资源。
除了阳泉,百度在北京、上海、深圳、南京等地也部署了成规模的数据中心节点,这些节点各有侧重:
- 北京和上海作为核心网络枢纽,承担主要流量接入和搜索请求转发
- 深圳节点偏向华南区域用户的就近访问
- 南京节点侧重数据备份和存储服务
- 百度智能云的边缘节点覆盖更多中小城市,用于CDN内容分发
从地域分布来看,百度采用“少数大型数据中心 + 大量边缘小节点”的组合策略,大型数据中心负责重型计算和存储,边缘节点解决“最后一公里”的延迟问题。
百度用什么服务器和芯片
这是一个被问得最多的问题,答案可以归结为两个方向:通用x86服务器和自研芯片服务器。
百度早期大量采购浪潮、戴尔、联想等厂商的x86服务器,这些机器跑的是Linux系统,承担常规的Web服务、爬虫下载、日志处理等任务,近年来,随着AI业务比重加大,百度一步步把重心转向自研硬件。
自研芯片带来的核心优势
百度从2018年推出昆仑芯一代开始,就明确了“造芯”路线,到2026年发布的昆仑芯三代,已经用于文心一言等大模型的训练和推理场景。
搭载昆仑芯的服务器主要解决两件事:
- AI推理任务用户搜索时,百度不需要每次都重新计算,而是靠模型做语义理解后直接给出结果,这个过程需要高吞吐的推理芯片
- 深度训练任务大模型训练要消耗惊人的算力,自研芯片能大幅降低成本,摆脱对单一外部供货商的依赖
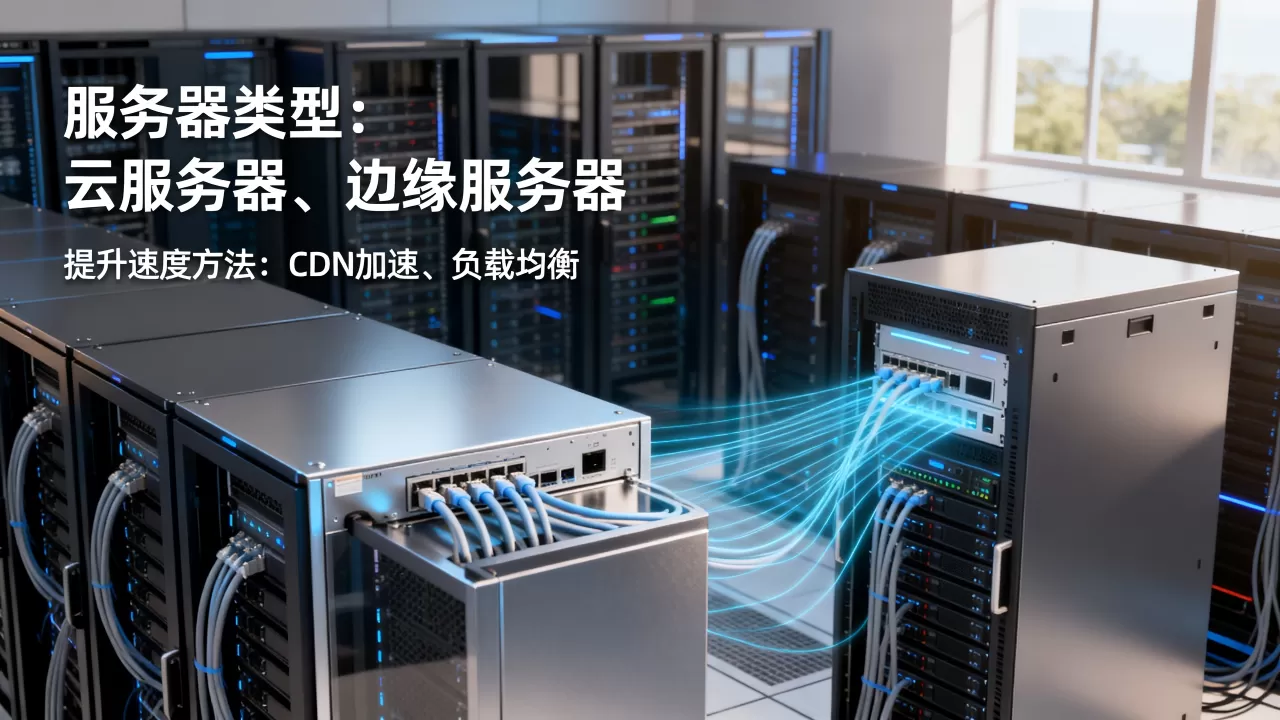
行业共识认为,自研芯片是百度控制整体服务器成本的关键一步,采购第三方GPU卡不仅贵,而且在高峰期可能出现供货紧张,自研路线让百度的算力规划更主动。
服务器操作系统和软件栈
百度的服务器全部运行在定制化Linux系统上,这个系统是百度内部长期维护的分支,针对搜索引擎的高并发请求做了大量内核优化,软件栈的关键组件包括:
- Web服务器层面:前端用类Nginx组件做负载均衡和反向代理
- 分布式计算层面:早期大量使用自研的分布式计算框架,类似Hadoop生态但做了深度改造
- 存储层面:采用自研分布式文件系统,支持海量网页快照和索引数据的持久化
在操作系统和上层应用之间,百度的研发团队构建了一套完整的中台体系,包含任务调度、资源隔离、故障自动恢复等模块,这套体系保证了当某台服务器宕机时,系统能迅速把请求切到其他机器,用户几乎感知不到波动。
搜索引擎服务器工作的三大核心组件
百度搜索的核心链路可以拆成三段:抓取、索引、检索,这三段各自跑在不同类型的服务器上,构成一个流水线。
爬虫系统服务器
爬虫服务器负责在互联网上抓取网页,这些服务器专门优化了网络带宽和并发连接数,每台机器同时保持大量TCP连接,把抓到的网页原始内容存入临时存储区。
爬虫服务器的特点包括:
- 高带宽接入,避免大页面抓取时出现延迟
- 去重逻辑前置,避免同一个网站被重复抓取
- 故障隔离设计,单个爬虫节点挂掉不影响其他节点的任务队列
索引与检索服务器
索引服务器把爬虫抓到的原始网页做一个“倒排表”处理,也就是把网页里的关键词提取出来,建立词到文档列表的映射关系,这一步完成之后,用户的搜索请求才能真正匹配到内容。
检索服务器则接收用户输入的关键词,在索引库中快速查找匹配项,再通过排序算法(早期的超链分析算法,到今天的深度学习排序模型)把最合适的网页排在最前面。
这里涉及一个实时性难题:互联网每天都有大量新内容产生,索引必须不断更新,百度采用“增量索引 + 全量索引”双轨制,新内容先进增量索引,满足当天搜索需求,再定期合并进全量索引,保证整体检索效率。
数据存储集群
所有网页的快照、用户搜索日志、点击行为数据,最终都落到存储集群里,百度的存储集群使用分布式架构,数据自动分片并复制多份。
正常情况下,一份数据至少保存三个副本,并且分散在不同机柜甚至不同数据中心,这样即使一整排服务器断电,数据也不会丢。
百度服务器的配置和价格
很多做技术的朋友想知道,百度一台服务器的配置到底什么水平,虽然具体采购清单属于商业机密,但可以从行业普遍配置和百度技术栈特性倒推一个参考范围。
核心配置参考范围
用于搜索服务的通用服务器,配置通常落在以下区间:
- CPU:双路Intel至强或者AMD EPYC,核心数在16到32个之间
- 内存:128GB到512GB ECC DDR4或DDR5,搜索引擎的索引需要大量驻留内存
- 硬盘:系统盘用NVMe SSD,容量500GB到1TB;数据盘用大容量SATA HDD(8TB到16TB),追求单GB成本
- 网络:万兆网卡起步,核心节点配25GbE甚至100GbE
用于AI训练的GPU服务器就完全不同了,搭载昆仑芯或者英伟达加速卡的训练节点,单台造价通常是普通服务器的数倍以上,而且功耗高,必须配液冷或者加强风冷。
从百度服务器配置估算自建成本
如果你所在的企业也想搭建一套小规模的搜索或推荐系统,可以参考如下思路:
- 先算并发量,每秒100个请求的小型业务,三台通用服务器加一台数据库服务器基本够用
- 再算存储量,1亿条网页快照,平均每条压缩后按30KB估算,大约需要3TB裸容量,按三副本算总占用约9TB
- 最后算带宽成本,服务器本身的购置是一次性投入,但带宽和机柜托管是持续费用,这部分在多数情况下会超过硬件成本
具体到价格,一台中档配置的通用服务器(双路CPU、256GB内存、2TB SSD),近年来市场价在两万到四万元人民币之间,AI训练服务器的价格浮动大,一台搭载多卡加速卡的机器从十几万到上百万都可能。
百度和简米云服务器哪个好用
百度和简米云都对外提供云服务器服务,但两者的底层体系和核心优势差异明显。
两家服务器体系的侧重点不同
百度智能云的服务器与自家搜索业务深度耦合,在AI推理、自然语言处理相关场景下优化更彻底,如果你做的是智能客服、内容审核、大模型微调这类应用,百度云的弹性计算资源配合其AI开发平台,上手门槛比较低。
简米云的服务器体系起步更早,生态更成熟,行业共识认为,简米云在传统企业上云、电商大促高并发场景下的稳定性经验和市场占有率更高,在内存型、高主频计算实例的规格选择上也更丰富。
场景化选择建议
| 场景 | 百度服务器 | 简米云服务器 |
|---|---|---|
| 大模型推理与训练 | 自研芯片生态,调优更容易 | 英伟达GPU系列选择多 |
|
传统Web应用部署 | 满足基本需求 | 产品线成熟,监控和运维工具齐全 |
| 政企客户合规要求 | 重点布局华北区域节点 | 覆盖城市更多,合规案例资源更丰富 |
| 成本敏感型个人开发者 | 新用户活动力度较大 | 长期包年价格更有优势 |
判断哪家更好,要看你具体跑什么业务,做智能应用,百度云更顺手;做通用业务,简米云的产出比更划算。
用户如何观测百度服务器的实际运行状态
作为普通用户,你可以用几个简单到不能再简单的命令,感知百度服务器的节点分布和响应质量。
在电脑终端里敲这行命令,可以看百度搜索域名的解析结果和延迟数据:
ping baidu.com再看具体请求路径:
traceroute baidu.com观察输出结果中经过的路由节点IP,如果延迟主要集中在某个地区节点,说明百度后端根据你的地理位置自动调度到了离你最近的服务器集群。
此外可以打开浏览器的开发者工具(按F12),在网络面板里看百度页面加载时的响应头字段,里面可能包含服务器版本信息和缓存节点标识。
对于站长来说,百度服务器的抓取行为可以通过搜索引擎后台的“抓取异常”日志查看,那里会明确列出百度爬虫的IP段和抓取频率,便于企业自查站点是否被正常收录,以及是否需要调整服务器的访问控制策略。
关于百度服务器的常见问题解答
百度服务器是自建机房还是租用第三方机房的?
百度采用混合模式,大型核心数据中心基本是自建或深度定制合作,典型如阳泉云计算中心,中小城市的CDN边缘节点则大量依托第三方IDC机房的托管服务,百度采购机柜和带宽,放置自研或定制的服务器硬件,这样做既能保证核心业务的稳定性,又能在边缘节点上快速扩容。
百度服务器的核心软件是开源项目还是完全自研?
两者兼有,基础系统层面深度使用开源Linux内核、负载均衡组件、分布式协调工具,在此之上构建自研的搜索内核、分布式文件系统、任务调度框架,百度的技术团队不会从零重造轮子,而是把成熟开源组件做二次改造,确保性能和可控性达到商用规模。
想模仿百度这样的服务器架构,应该从哪里切入?
从单机架构起步即可,先用一台普通Linux服务器部署一个开源搜索引擎框架,配合MySQL和Redis做数据存储和缓存,当索引量超过单机内存容量、请求并发持续上升时,再拆分成独立的爬虫节点、索引节点、检索节点分别部署,一整套架构至少需要十台以上服务器才能真正模拟百度的分布式效果,这个投入可以在云服务器上按月按需购买,验证通过后再考虑采购物理机自建。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/735013.html