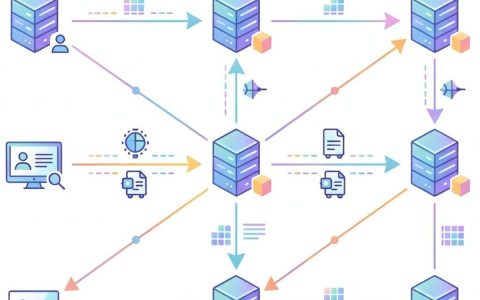
虚拟机热迁移保障业务不中断的核心思路,是让内存和磁盘数据在迭代同步中无限逼近生产状态,再通过一次毫秒级的停机切换完成地址映射,业务感知被压缩到几乎无感。这一过程看似简单,实际落地时却藏在大量参数调优和架构设计的细节里。
虚拟机热迁移全过程拆解:业务中断的根源在哪
虚拟机热迁移不是“把文件拷贝过去”,而是一套持续迭代的状态同步机制,业内专家指出,绝大多数的迁移中断事故,都发生在预拷贝阶段和停机切换阶段的交接处。


预拷贝阶段:数据追赶的拉锯战
源宿主机开启迁移后,虚拟机的内存页面会分批传给目标宿主机,虚拟机还在继续运行,产生新的数据变更,这些变更就是“脏页”,如果脏页产生的速率持续高于网络传输速率,迁移就无法收敛。
- 第一轮传输:全量内存拷贝
- 后续迭代:只传上一轮标记的脏页
- 收敛条件:脏页剩余量低于阈值,或迭代轮次超过上限
停机切换阶段:唯一的“暂停窗口”
当数据足够接近完整时,源端虚拟机会短暂暂停,把最后的脏页和CPU状态传给目标端,目标端启动虚拟机,这个暂停窗口越小,业务中断时间越短。
行业共识是,可控的停机窗口通常需要压在数百毫秒以内,要压住这个窗口,关键不是靠运气,而是靠参数和架构的配合。
热迁移和冷迁移的区别,不止“停不停机”那么简单
很多运维人员误以为热迁移只是“省了一次关机”,热迁移和冷迁移在技术路径、资源消耗、适用场景上几乎走的是两条路。
| 对比维度 | 冷迁移 | 热迁移 |
|---|---|---|
| 业务可用性 | 完全中断 | 毫秒级感知 |
| 内存状态传递 | 不涉及 | 需持续迭代同步 |
| 对网络依赖 | 低 | 高,需稳定专线或大带宽 |
| 对业务无状态要求 | 低 | 需关注长连接与缓存 |
| 实施复杂度 | 低 | 高,需精密配合 |
| 对存储的要求 | 可任意切换 | 共享存储或块级复制 |
冷迁移是“搬完家再开门”,热迁移则是“门不关,换个地基”,后者的难点在于迁移期间虚拟机仍在对外服务,系统的每一个状态变更都需要被记录和同步。
热迁移对网络和存储的隐性要求
- 网络抖动会直接拉长迭代时间
- 存储延迟过高会导致磁盘同步失败
- 目标宿主机CPU型号差异过大,可能触发指令集不兼容
虚拟机热迁移业务中断怎么解决:四个层面的配合
解决业务中断,不能只盯着迁移命令本身,需要从内存、存储、网络、业务四个层面同步发力。
内存层面:控制脏页速率比调大带宽更管用
在KVM/QEMU环境中,virsh migrate命令是核心工具,推荐使用以下参数组合来降低中断时间:bash</br>virsh migrate --live --p2p --tunneled --auto-converge </br> --max-bandwidth 200 </br> --timeout 300 </br> source_domain qemu+ssh://target-host/system</br>
--auto-converge参数会在迁移收敛困难时,主动限制源端虚拟机的vCPU运行速率,让脏页生产速度降下来,代价是迁移期间业务可能出现轻微卡顿,但换来的是迁移不失败,实测中,这个参数能把“迁移超时”的概率降低很大一截。
--max-bandwidth用于限制迁移流量,避免吞噬业务带宽,单位是Mbps,数值不宜过大,一般建议设置在业务闲时带宽的60%~70%。
存储层面:共享存储优先,非共享存储有取舍
- 共享存储迁移:数据盘不必走网络传输,迁移速度快,中断窗口集中在内存和CPU状态。
- 非共享存储迁移:磁盘数据需同步传输,迁移时长大幅拉长,遇到大容量磁盘场景,迁移时间会非常长。
生产环境建议使用NFS或Ceph这类共享存储,如果想做P2P迁移且没有共享存储,需要额外增加--migrate-disks参数,并为磁盘同步预留充足的网络带宽。
网络层面:QoS限速和丢包排查不能省
虚拟机迁移期间,业务流量和迁移流量共用物理网络,未加限制时,突发的迁移流量可能挤占业务通道,造成线上请求大面积超时。
- 给迁移流量配置独立的QoS队列
- 监控目标宿主机网卡的丢包率与重传率
- 优先使用万兆网卡或RDMA网络进行迁移
出现虚拟机迁移丢包时,可先用ethtool -S查看网卡统计,再通过iperf验证物理链路质量,避免误判为宿主机性能问题。
业务层面:长连接应用需要“提前热身”
像是WebSocket服务、数据库主从同步等长连接业务,迁移时即使网络包不丢,也可能因TCP连接状态迁移不完整而感知到延迟波动。
一般处理方式是:– 迁移前从负载均衡中摘除该节点流量– 等待存量连接自然排空– 迁移完成后再重新挂载
这一操作会让业务中断的时间上限更高,但换来的是业务感知更平滑,适合无法接受毫秒级抖动核心业务。
云平台虚拟机热迁移实操演练流程:先把风险暴露在应急环境
直接在生产环境做热迁移,风险很高,较稳妥的做法是先在测试环境完整走一遍迁移流程,记录基线数据。
迁移前检查清单
- 确认源端与目标端的CPU型号属于同一代际
- 确认宿主机内核版本一致
- 确认目标端磁盘剩余空间大于源端磁盘用量
- 检查源端虚拟机的磁盘类型是否支持在线迁移
- 确认网络防火墙未屏蔽kvm迁移所需的端口
热迁移需要多长时间算正常?先测出基线
在测试环境,建议记录以下数据:– 全量内存大小– 迭代轮次– 每轮脏页速率– 停机切换时长– 迁移完成总耗时
如果迁移耗时过长,优先排查以下方向:
– 内存分配是否过大– 脏页速率是否持续走高– 磁盘镜像格式是否拖慢同步– 迁移带宽是否被限速过低
回滚预案:迁移失败后如何快速恢复
- 未完成提交的迁移,源端虚拟机状态不会丢失,可继续运行
- 已切换但业务异常的,立即关闭目标端虚拟机,恢复源端,挂载原存储
- 已完全切换且正常运行,但变更后性能下降,需检查目标端CPU降频与内存NUMA配置
虚拟机热迁移会断网吗
多数情况下不会,热迁移过程中,虚拟机的IP地址和MAC地址保持不变,网络连接通常在TCP层面可感知到毫秒级延迟波动,只有迁移停机时间过长,超过TCP重传超时阈值,才会出现连接断开的现象,稳妥的做法是在迁移前使用ping -f连续监测网络延迟,并在迁移过程中观察是否有连续的请求超时。
热迁移期间业务负载过高怎么办
观察脏页速率是否持续高于迁移带宽,若是,则迁移无法收敛,解决方向有两个:一是通过--auto-converge主动降速vCPU,二是先清理业务中的高频写入负载,待迁移完成后再恢复,数据库批量任务、日志采集进程这类高写入负载,建议迁移期间先在业务侧暂停或降速。
热迁移与冷迁移的选择策略
迁移耗时不可控、目标端硬件型号跨度大的场景,冷迁移是更稳的选择,需要在线扩容、硬件维护、宿主机下线的场景,配套做好业务流量摘除后,热迁移的收益远大于风险,判断标准很简单:业务能否承受一次完整的关机时间,能承受,冷迁移更省事;不能承受,才考虑热迁移。
虚拟机热迁移业务中断问题的本质,是同步效率与业务敏感度之间的平衡,把内存脏页速率管住、把存储链路的时延压住、把网络通道的带宽控好,业务无感迁移是可以稳定复现的,任何时候,都不要跳过演练,测试环境跑通了,生产环境才拿得到那几百毫秒的“无感”窗口。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/742398.html