实时业务中断的真正元凶与实战排查指南
国际链路抖动是导致跨国视频会议卡顿、交易系统超时和云办公断连的首要网络因素,它并非带宽不足,而是数据包在跨国传输沿途节点上出现的毫秒级延迟波动,这种波动足以让对时间极度敏感的实时业务瞬间“窒息”。 相比单纯的网络中断,链路抖动更隐蔽、更频繁,也更难定位,对依赖海外服务器、跨境分支机构的业务而言,理解链路抖动、定位根源并实施有效缓解,是保障业务连续性的必修课。
了解链路抖动如何形成,需要先看国际数据长途跋涉的路径。由国际链路本身物理属性引发的抖动,占比相当可观,但常被误诊为应用或服务器问题。

国际链路抖动是怎么发生的
国际链路绝非一条直达的“光缆直线”,而是由海缆、陆缆、运营商骨干网、IXP交换中心等多种物理段拼接而成,每一次数据包跨越国境,都要经历复杂的路由跳转。
延迟的“乐高积木”效应
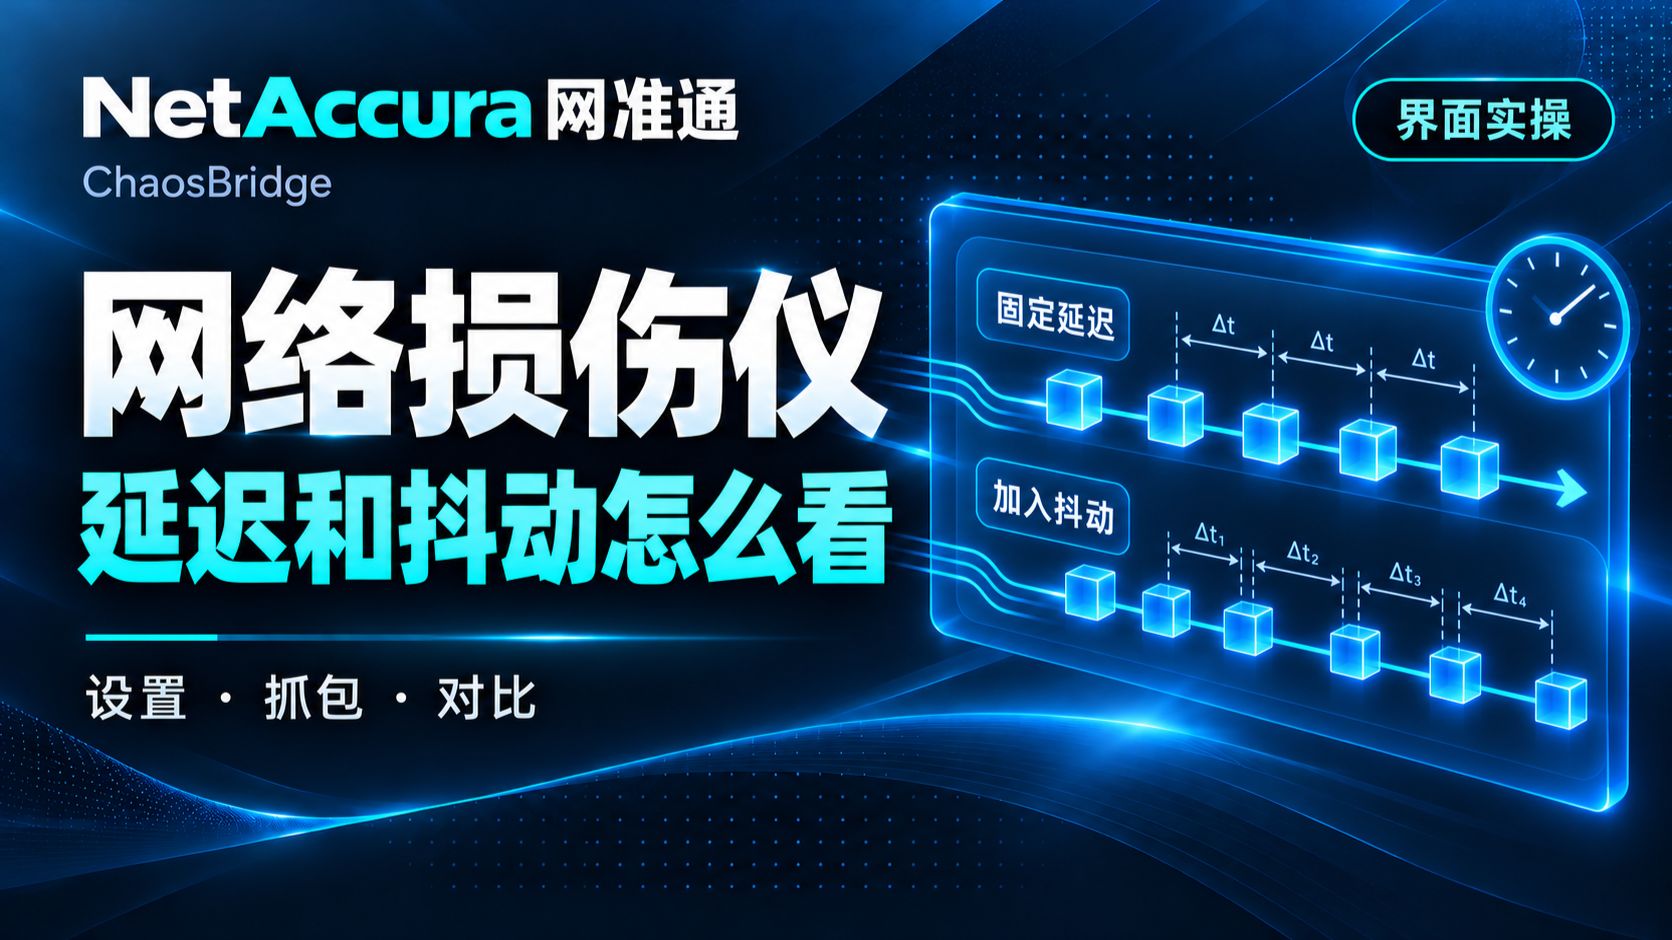
每个数据包从北京到洛杉矶的技术人员电脑上,需要经过至少20个左右的路由节点。每个节点转发数据包都需要时间,这个时间并非恒定的。 当某个节点遭遇瞬时流量拥塞、路由收敛或设备CPU处理峰值时,延迟会突然增加几十甚至几百毫秒,下一毫秒又恢复正常,对于基于TCP的实时协议而言,这种延迟的方差(即抖动jitter),远比绝对延迟更具破坏力。
物理光纤的脆弱时刻
据业内专家指出,海底光缆的故障修复非常耗时,但更常见的是微小扰动,渔船锚链的短暂刮擦、海底地震引发的细微位移,都会导致光信号衰减或偏振态变化,触发光层保护倒换(APS)。APS切换虽然设计为50毫秒内完成,但在实际跨国链路上,这个切换动作往往伴随着持续的抖动、偶发丢包和误码高峰,持续时间可能长达几秒到十几分钟。
“错峰”导致的路径抢占
国际流量在高峰期(例如欧美工作日上午与亚洲下午重叠时段)会爆发式增长,不同运营商之间互联互通带宽一旦打满,就会触发实时流量与下载类大流量抢占路径。原本低延迟的最优路径失效,数据包被迫绕行较远的备用路径,延迟从180ms跳到300ms,并伴随抖动。
被忽略的本地最后一公里
大量跨境链路故障并非出现在国际段,而是企业本地接入侧,无论是MPLS专线的最后一公里光缆,还是办公室Wi-Fi的射频干扰,本地网络的轻微丢包或高延迟,在叠加国际链路的长距离延迟后,抖动特征会被显著放大。
哪些实时业务最怕链路抖动
不同业务对网络损伤的敏感度差异巨大,下载文件和浏览网页对抖动几乎免疫,但实时交互业务对抖动的容忍度极低。
音视频会议:最先感知“鬼畜”的业务
在音视频编码中,关键帧(IDR帧)的丢失或迟到会导致解码器等待,画面直接卡在上一帧。 即便有前向纠错(FEC)机制,面对抖动的乱序和突发性延迟也力不从心,用户感知为“马赛克”、声音断续、音画不同步,在跨国会议场景中,抖动造成的体验损伤远大于绝对延迟带来的“空灵感”。
交易与数据同步:毫秒级差就是分水岭
在线交易系统,尤其是跨市场的套利或风控系统,对延迟绝对值和抖动都极其敏感。交易网关通常在几十毫秒的窗口期内等待确认数据包,一旦数据包因抖动迟到,就会被判定为超时并触发重连或丢弃。 对于专线用户而言,多线路负载均衡时,抖动还可能引发乱序重排,导致CPU飙升和交易回报延迟,这在金融云和跨时区清算场景中尤为致命。
云桌面与系统控制:重活一次比卡顿更痛苦
使用Citrix或VMware Horizon访问海外VDI桌面时,画面是作为像素流推送的。抖动带来的延迟峰值会让鼠标“漂移”,键盘输入回显极慢。 更严重的是,如果带宽刚好够用,抖动引发的TCP全局同步会导致窗口崩溃,云桌面直接黑屏重连,比卡顿更影响远程办公效率。
用数据包探针锁定抖动源头
定位抖动不能凭感觉,需要利用命令行工具进行分段分析,核心思路是:在本地、边界防火墙、远端服务器三处同步抓包,对比时间戳找出延迟突变的物理段。
MTR报告分析法
MTR(My Traceroute)是诊断抖动的首选工具。 它在Windows和Linux上均有实现(命令为mtr或tracert搭配-T参数模拟TCP探测)。
- 操作路径: 在本地双向运行的节点上执行
mtr -rwz -i 1 -c 100 <对端IP>。 - 解读技巧: 重点看各跳(Hop)的 Loss% 和 Stdev(标准偏差) 两列。如果中间某一跳Stdev显示高于20ms,且该跳之后的节点Stdev都随之升高,说明抖动源就在这一跳所在的核心路由器。 如果Stdev值在某个节点后恢复正常,则该节点只是瞬时拥塞,并非主要瓶颈。
ICMP与TCP探针的互补
有时运营商对路由器上的ICMP查询报文设置了较低的优先级,导致MTR显示的中间节点延迟失真。应改用TCP首包探测(tcping 或 nc -vz)。 若ICMP路径显示抖动剧烈,但TCP握手延迟平稳,则说明真实数据面质量尚可,问题出在设备自身的管理面限速上。
全球节点拨测的交叉验证
修复排查时易出现“盲人摸象”的局面。建议利用免费或自建的分布式监测点进行交叉验证。 如果只有通往某运营商的路由抖动严重,而其他运营商的入口延迟平稳,问题可能在上游AS;如果所有海外入口都抖动,问题很可能在本地的出口网关上行链路或光模块上。
针对“神经质”链路的优化自救
既然跨国链路抖动难以根治,通过技术手段“吸收”抖动就成了保障实时业务体验最务实的路径。
传输层优化:引入冗余与预测算法
- 前向纠错与交织: 在UDP音视频流中,增加冗余包(如RFC 2733)的抗丢包能力,通过交织打散突发丢包,让解码器在接收端重建丢失数据,代价是占用额外的带宽,但对恢复质量提升明显。
- 自适应全双工与强缓存: 调整客户端的接收缓冲区(Playout Buffer)。不要使用固定缓存,而是根据实时抖动反馈动态调整。 采用更智能的深度缓冲策略(例如将缓存从200ms提升至500ms),能换掉绝大多数因抖动造成的“眨眼”,只是端到端延迟会相应增加。
应用层协议改造:从连接型到恢复型
对于非RTC(实时通信)类应用,应尽量利用QUIC或HTTP/3替代TCP。
- 核心优势: QUIC实现独立于内核的连接迁移与更快的丢包恢复,它能在大约一个往返时间(RTT)内恢复连接,而TCP在抖动导致重传超时(RTO)时,经常会经历长达数秒的“假死”状态。
- 实操建议: 对于需要访问海外API的海外门店POS或ERP系统,建议在网关层启用HTTP/3代理,可明显降低因链路抖动引发的“白屏”与“连接重置”。
架构层面:避开“拥堵快车道”
- 设置双链路智能路由: 不要再迷信单一MPLS专线。将专线作为高质量主路,将基于公网IPsec或SD-WAN的Internet链路作为备用路。 在检测到路由Stdev持续超标的5分钟窗口内,自动将实时业务PVC切换到备用链路,这是当前最稳的容灾方案。
- 应用性能监控(APM)联动: 在关键业务服务器部署探针,当监测到TCP重传率上升或事务耗时拉大时,直接触发VPC内部切换或者题服务器重启? 这其实治标不治本,根本目的是提醒业务侧在大抖动来临时维护窗口,避免数据写入错乱。
Q&A:国际链路抖动常见疑问速答
询问:国际专线(IPLC/IEPL)偶尔出现抖动,但比普通公网稳很多,如果不敢轻易切换,应该先做哪一步排查?
首先判断是持续抖动还是间歇抖动。针对间歇性抖动,查看运营商端到端延迟曲线和丢包日志。 建议先登录你的专线网管平台,查看最近24小时该链路的可用性和丢弃突发(Burst Dropping) 告警,若无告警,则必须放弃“千人千面”的长链测试,直接联系运营商,要求提供数个核心节点路由器的QoS(Quality of Service)队列深度记录来确认问题。
询问:SD-WAN解决方案能彻底消除国际链路抖动吗?
不能消除,但能有效抑制感知。SD-WAN通过多路径聚合和FEC前向纠错,可以将两个中等质量链路的抖动相互抵消。 当路径A抖动升高时,算法会同时将数据块发送至路径B进行冗余重建,从而在逻辑层面构造出一条斜率平滑的低抖动逻辑链路,这属于“对冲”而非“消除”,对带宽和链路成本的要求也更高。
询问:做跨国网络直播时,选择哪一类CDN或云区域的性价比最高以确保低抖动?
对互动性要求高的直播,选择任播网络(Anycast)的CDN并利用QUIC协议接入是性价比较高的组合。只要不是极高互动性(如在线PK连麦)场景,请务必关闭TCP BBR拥塞控制算法。 虽然BBR利用缓存换取吞吐,但在高抖动链路里,BBR反而更容易引发缓存膨胀和延迟加剧,对于主要服务海外中文用户的网站,选香港多线BGP入口,配合海外原生链路,比选用欧美纯海外节点更能平衡价格与延迟、抖动的关系。
国际链路抖动是广域网永恒的主题。无论传输技术如何演进,丢包、时延与抖动这“三座大山”都是实时业务的天敌。 与其被动等待运营商彻底修复海底光缆或路由策略,不如在自身网络边界部署主动探测、多路径冗余和自适应带宽缓冲。面对不稳定的物理世界,可控的软件冗余才是保障体验的最后一道防线。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/746214.html