用加粗写核心答案:服务器监控的核心指标分为硬件资源、系统状态、网络链路和应用体验四个维度,其中CPU、内存、磁盘、网络是永远逃不开的基础四项。 监控不是把所有数据堆到面板上,而是抓住能提前暴露故障的关键指标,下面按优先级逐个讲清楚。
服务器监控有哪些指标从底层到应用层完整拆解
很多刚入门的朋友习惯先装个监控面板,盯着花花绿绿的图表看,但真要说出每个指标的含义时往往卡壳,这里按服务器监控指标详解的常见顺序,从硬件层讲到应用层。
CPU指标:使用率只是冰山一角
CPU使用率当然要看,但它本质上是滞后指标使用率飙高时,系统其实已经忙了一阵,更有提前量的判断依据是负载平均值,也就是load average,行业共识认为,当15分钟负载持续高于CPU物理核数时,系统已经处于任务排队状态,这时候即使使用率只有60%,新请求也会变慢。
CPU这块还建议关注上下文切换次数,如果切换频率动不动就冲到每秒几万次,说明进程太多或锁竞争严重,用vmstat 1能直接看到cs列的变化,iowait占比也要单独观察,CPU在等磁盘时实际上是空闲的,这时候加CPU核数毫无意义,真正的问题是磁盘太慢。
内存指标:swap一出现就要警惕
内存监控最容易被误解的是free命令的输出。available才是真正可用的内存,而不是used,Page Cache占用的内存可以被回收,所以哪怕free显示很低,也不一定代表内存紧张。
真正危险的信号是swap的使用,Linux内核在内存不足时会触发换页,而swap的读写性能远低于物理内存,一旦swap使用率开始上升,接口响应时间会肉眼可见地变差,可以通过cat /proc/meminfo里的SwapTotal和SwapFree计算使用量,或用free -m观察si和so两列,这两列持续非零时,说明系统正在频繁换入换出,加内存才是正解。
磁盘指标:空间之外更要关注I/O等待和inode
磁盘空间满会引发写入失败,这个大家都懂,但有个同样隐蔽的坑是inode耗尽文件系统元数据满了,连空文件都创建不了,建议把inode使用率也纳入监控。
I/O层面,重点盯iostat -x结果里的await和util,await是平均I/O响应时间,数值越高说明磁盘越忙,SSD通常在几毫秒以内,机械盘在几十毫秒,util达到100%意味着磁盘已经饱和,此时应用层的所有读写都在排队,对日志密集型的业务,磁盘I/O往往比CPU更早成为瓶颈。
Linux服务器监控指标里的隐藏项:进程、线程与文件句柄
很多监控系统把这几个指标放在角落位置,但它们恰恰是线上故障的高发区。
进程状态和线程数
进程状态里的D状态(不可中断睡眠)值得盯,如果D状态进程数长期大于1,说明有进程阻塞在I/O上,整个服务的响应都会被拖住,线程数方面,常见的问题是线程池被打满,表现为线程数量接近上限时错误率开始上升,用pidstat -t -p 进程号 1能实时查看线程级消耗。
文件句柄和连接数
高并发服务对文件句柄的消耗非常大,每一路TCP连接都是一个文件描述符。ulimit -n的默认值往往不够用,当句柄数接近上限时,新连接会直接失败,监控/proc/sys/fs/file-nr对比系统上限,能提前规避这个问题。
网络层面的服务器监控指标连接状态比带宽更紧要
带宽跑满会丢包,但更常见的问题是连接状态异常,网络监控这块建议区分入口方向和自己主动发起的出口方向,分别设置不同的观察维度。
带宽、TCP连接和重传率
端口吞吐量要看,但只占小部分,更有价值的指标是TCP连接状态分布,尤其关注TIME_WAIT和SYN_RECV的数量,TIME_WAIT大量堆积会耗尽本地端口资源,SYN_RECV异常偏多则可能说明被攻击或后端处理不过来,用ss -s直接查看汇总即可。
TCP重传率也是重点,重传率高意味着网络链路不稳定,传输层在反复补偿,实际吞吐会明显下降,重传率超过2%时,就要结合丢包率一起排查路由或运营商线路,对公网服务来说,可用性监控建议用真实用户的视角去探测,比自己看服务器网络指标更贴切。
应用层服务器监控指标用户体验的最终落脚点
前面讲的都是基础层,但最终判断服务好不好,还得看应用自己的指标,应用层的监控就像是给服务器装上了眼睛,直接感知用户的真实体验。
响应时间、错误率与吞吐量的黄金三角
这三个指标必须配合分析,任何单独看都会误导人,响应时间低了但错误率升高,说明系统开始拒绝请求;吞吐量骤降而响应时间正常,多半是入口流量或上游依赖出了问题。
具体到HTTP服务,状态码分布要比总请求数更值得关注,5xx比例一旦超过1%,就要立刻查应用日志和上游调用,数据库、缓存这些中间件的慢查询监控也应该归属到应用层,单条SQL慢到几百毫秒时,业务接口的P99延迟基本就废了。
服务器监控指标阈值多少才算真出问题
阈值调得太敏感会疲劳轰炸,调得太松又毫无用处,业内没有绝对标准,但有一套基于多年实践的基础参考值,拿来做初始配置很合适。
| 指标项 | 正常参考范围 | 需要警惕 | 补充说明 |
|---|---|---|---|
| CPU使用率 | 0%-70% | 持续高于85% | 短时峰值可接受,警惕长时间高位 |
| 负载平均值 | 低于核心数 | 连续多次高于核心数 | 看15分钟负载评估趋势 |
| 内存可用量 | 高于内存20% | 低于10%且swap活跃 | 重点关注换页速率si/so |
| 磁盘使用率 | 低于80% | 超过90% | 同步检查inode使用率 |
| 磁盘I/O等待 | 低于10% | 持续高于30% | 结合应用的实际写入量判断 |
| 网络丢包率 | 基本为0 | 超过1% | 公网链路出现轻微丢包也需重视 |
实际配置时,建议先采集两到四周的基线数据再固化阈值,每台服务器的业务模型不同,拿通用模板直接套用,误报率一定高。
服务器监控系统推荐:开源工具和商业平台怎么选
聊到具体工具时,大家常问服务器监控软件哪个好,答案取决于团队的人员配置和运维预算,没有绝对最优解。
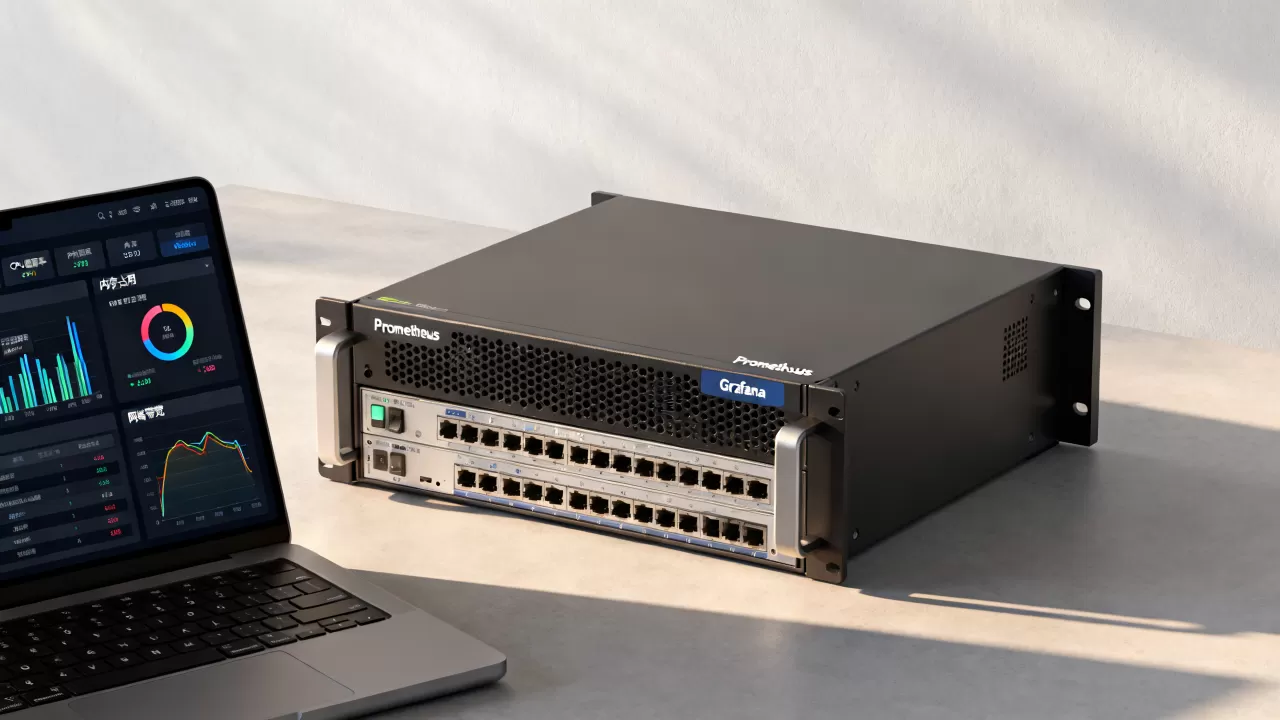
中小团队适合的开源方案
Prometheus加Grafana是目前的事实标准,适合已有一定代码能力的团队,部署成本极低,但告警规则、仪表盘都需要自己打磨,前期人力投入比较大,如果只想快速看到实时数据,Netdata更适合,它在浏览器里就能展示所有基础指标,适合单机或小规模集群环境的轻松监控。
云上业务怎么选商业监控
商业平台的价值主要体现在开箱即用和告警准确性上,云厂商自带的监控产品(比如简米云监控、酷番云拨测)能跟云资源无缝对接,主机维度不用额外配置,对等保合规有要求的业务,商业平台的审计能力和工单追踪也更完善,预算紧张时,先用开源方案跑起来,再按需逐步引入商业服务也是常见节奏。
关于服务器监控指标的常见疑问
Linux服务器监控指标里,哪些是必须优先看的?
第一次搭监控,先看四项:CPU使用率、内存可用量、磁盘使用率、带宽占用,配合uptime看负载,用free -m看内存,靠iostat盯磁盘,用iftop查流量,这四项能覆盖绝大多数硬件故障场景,跑稳定后再补上TCP连接状态和应用日志,服务器监控指标就已经很全面了。
监控项太多看不过来,怎么取舍?
指标数量控制在50个以内,都比追求全量采集更有价值,先跑一周基础监控,复盘产生告警的那些指标,把误报严重的阈值调宽或直接丢弃,监控的目的是发现问题,不是集邮。
服务器监控哪家便宜?
纯开源方案几乎零软件成本,只负担服务器本身的开销,云厂商的监控服务按主机数量和监控项计费,月成本大概在几十到几百元区间,具体要看监控频率和链路拨测次数,建议先拿测试环境跑一个月,对比实际账单后再决定要不要扩容,如果预算实在有限,Prometheus加Grafana自己维护,长期看性价比远高于任何商业方案。
监控这件事没有终点,把核心指标摸透,设定合理的阈值,再选一套趁手的工具,服务器的健康状态就会一直掌握在你手里。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/747332.html