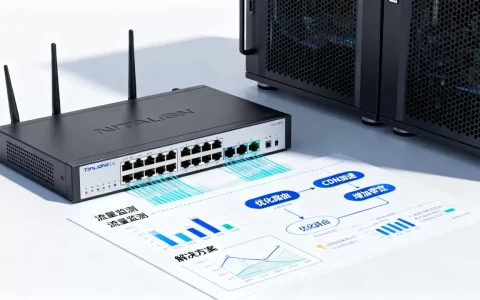
全球加速节点调度的核心思路就是就近转发加实时避障,把每个访客交给当下离他最近、线路最稳的那个节点。
这套逻辑听起来挺简单,但真放在全球百来个节点上,背后要处理的地域、线路和突发情况可就多了,咱们把它当成一个精明的派单员,从头走一遍流程。


全球加速节点调度策略是什么?先从一次跨国访问说起
假设你在上海,打开一个美国电商网站,请求先到本地的DNS递归服务器,问它:这个域名对应哪台机器?DNS服务器如果没缓存,会向上追到权威服务器,权威服务器配了全局负载均衡设备(GSLB),它根据你的IP判断出你在华东电信,再从节点列表里挑一个华东地区有BGP出口的节点给你。
这一步就是调度的第一步,地理就近匹配,但注意,离得近不一定最快,所以紧接着调度系统会去问监控系统:华东节点当前连接数高不高?到美国源站的链路丢包率怎么样?如果华东节点正被攻击或过载,它就把你分配去华北节点,哪怕物理距离远了一些,实际速度反而更好。
这轮操作里有两个关键词:就近转发和动态避障,前者负责找最短路径,后者负责踩掉坑,行业共识认为,调度的目标从来不是绝对距离最短,而是用户感知速度最快。
CDN节点调度原理:四种常用分配方式
业内专家指出,做CDN或者自建全球加速系统的人,一般都会先在这四类调度里挑一个核心选手。
DNS调度:最传统但仍有短板
把不同地域的访客DNS请求解析到不同IP,这种做法兼容性最好,几乎所有网站都能用,但它有两个明显毛病,一是运营商LocalDNS经常缓存旧记录,用户换节点了,调度系统却还往旧节点派单,二是DNS防不了中间人劫持,解析结果被篡改的情况在部分地区相当常见。
Anycast调度:天生就近,适合大流量
Anycast让同一个IP在全球多台路由器上同时广播,访客一旦发请求,路由器会自动把包送给离他最近的那一跳,这个机制很少被中间环节干扰,所以很多大型CDN和云厂商的入口层都用它,但它对网络割接和路由黑洞比较敏感,一旦上游路由出错,流量可能被带到断点。
HTTPDNS调度:App场景的精准替代
这种方案走自定义的API接口问调度系统拿IP,绕开运营商DNS,能拿到更细的地域和运营商信息,适合那些能改客户端的App业务,比如游戏、直播,缺点是必须集成SDK,要让访客配合升级版本,老版本用户覆盖不了。
实时探测调度:动态避障的关键
调度系统每几秒去探测一次各节点到源站的RTT和丢包率,把结果算出一个健康分,哪个节点分数差,就把它的权重降下来;哪个链路恢复得快,权重就提回去,这个机制在中远距离跨国网络里尤其重要,因为海底光缆时好时坏,光靠静态地理位置根本扛不住。
海外加速节点怎么选?场景化对比和调度策略
| 节点类型 | 调度侧重 | 典型场景 |
|---|---|---|
| IDC自建节点 | 定制化强、带宽独立 | 流量集中且成本敏感的用户 |
| 公有云边缘节点 | 弹性扩容、全球分布广 | 视频、直播这类突发流量大的业务 |
| 专线回源节点 | 链路质量稳定、延迟低 | 电商、游戏等对抖动敏感的业务 |
这三种节点不是互相排斥的,多数情况下,一套成熟的调度系统会把它们混着用,通过权重控制流量配比。
游戏加速节点调度:低延迟优先
玩家对抖动零容忍,调度策略会把Anycast和HTTPDNS结合,每秒钟做一次健康检查,踢掉成功率低于阈值的节点,同时用多端口探测,不仅看丢包,还看TCP握手时间和在途包数,给玩家分配节点的时候直接挑延迟最低的,绝不看负载,因为负载高可以扩容,延迟高就是死缓。
视频流媒体调度:带宽和缓存优先
视频业务最怕卡顿和首帧慢,调度系统优先找缓存命中率高的节点,也就是用户要的内容已经热在本地的那些,如果一个节点带宽快打满,哪怕延迟低,也会把新连接甩给邻居节点,同时针对跨国运营商做能力调整,比如欧美不少运营商之间互联质量差,就需要在换运营商入口时走另一条隧道去中转。
跨境电商场景:动静分离和稳字当头
电商的页面要快,交易不能断,动态请求直接走回源最快的节点,静态资源(图片、CSS)则交给CDN缓存节点,假如美国西海岸的节点出口带宽被打满了,而源站正好在美国当地,西海岸节点物理上最近,但实际排队时间过长,调度系统会把部分请求临时分给美国中部节点,让中部节点走另一条回源线路,绕开西海岸的拥堵点,用户感知速度不降反升,这就是实时探测的价值。
把调度策略落地成实操的五个步骤
- 画出访客地域地图:先从访问日志里确认流量从哪些国家来,哪些地区用户打开页面慢,没有这张地图,调度策略就是瞎调。
- 确定主调度算法:以App为主用HTTPDNS,以网站为主用DNS加Anycast组合,别一上来就把所有调度机制全开,会互相打架。
- 配置健康检查:在源站和每个节点之间开启每5秒一次的网络探测,连续三次失败自动切走流量,健康检查的阈值设太宽松,坏节点还会被派单;设太紧,闪断就被频繁切换,触发连锁问题。
- 留一条逃生通道:把其中一个节点设成不参与调度的冷备节点,当所有主节点告警时用它兜底,这条通道平时不用,但能防止全局故障。
- 持续复盘调度日志:每周看一次节点切换记录,识别频繁被切走的节点是线路问题还是容量问题,如果某个节点一周被切走十几次,说明它不是网络不稳就是带宽严重不足。
关于全球加速节点调度策略的常见问题,顺便解答
跨国访问卡顿怎么解决?
先改调度策略比加节点更管用,开启HTTPDNS绕过本地运营商DNS污染,然后给冷门地区配一个安全备用节点,并将丢包率阈值从5%调到2%多数卡顿现象出现在只有1%到3%丢包但线路绕远的情况,之后再看要不要走专线把回源链路的RTT降下来,这个问题的解决顺序,业内建议是先改路由,后加资源。
节点数量越多,调度效果一定越好吗?
不完全是,节点多但回源链路差,结果就是访问节点快、回源慢,整体还是卡,真正决定质量的是节点到源站之间的链路,以及节点上的缓存命中率,调度系统如果检测到某个节点命中率长期低于30%,它的价值就很有限,多数情况下,把10个优质节点用好,胜过挂20个廉价节点,从统计角度看,调度策略的优化空间主要在线路冗余和动态避障,而不是单纯堆数量。
全球加速节点调度从来不是一锤子买卖,它是持续根据网络状态做微调的活,抓住就近转发这条主线,再把动态避障的探测频率调准,大部分跨国访问问题都能缓解一大半。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/747532.html