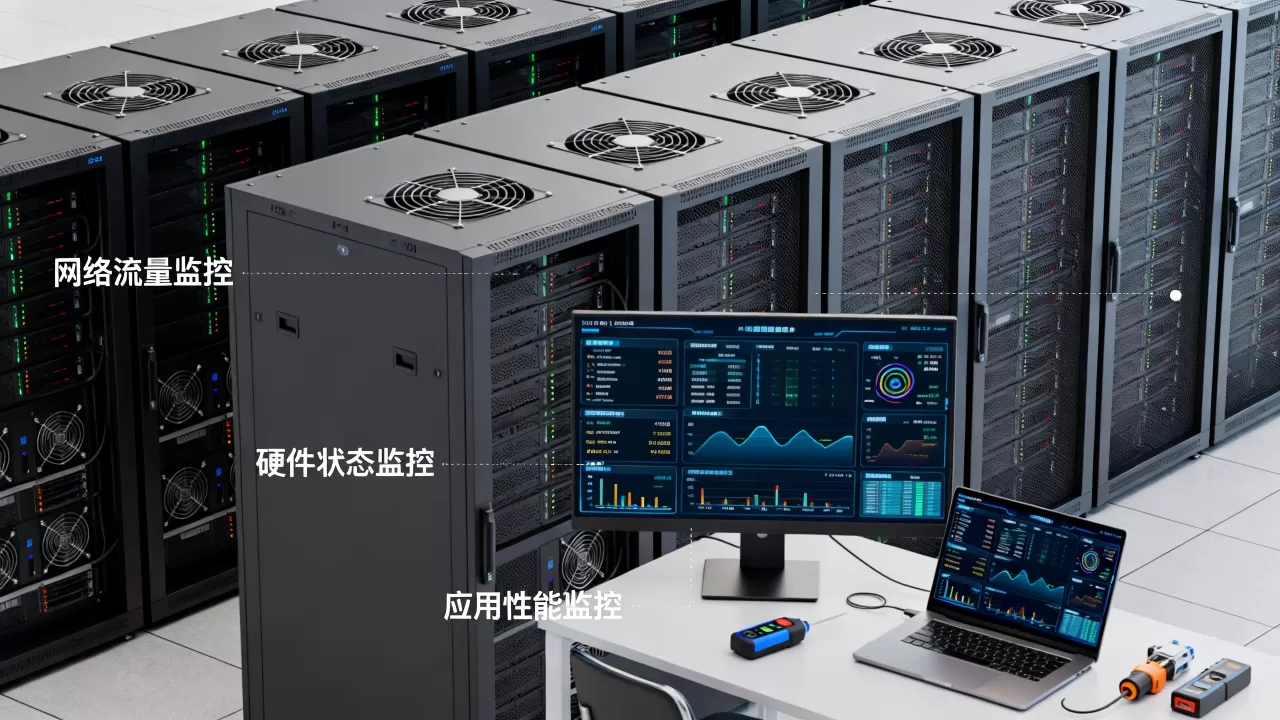
服务器监控的方法主要有命令行工具、脚本采集、开源监控系统、商业SaaS、云厂商自带监控、日志与链路追踪六类;实际落地时,通常把资源指标、应用指标、日志和链路组合起来用。
监控不是装一个软件就结束,采集、存储、告警、可视化、处置、复盘,少一环都会变成“只看不警”或“一告警就风暴”。

服务器监控有哪些方法:先明确监控对象
基础资源层
- CPU使用率、内存占用、Swap、磁盘空间、inode、网络吞吐、TCP连接数。
- 系统负载、进程数、端口监听、文件句柄、时间同步。
- 常用命令:
top、htop、vmstat 1、iostat -x 1、free -m、df -h、ss -s、sar -n DEV 1。
应用与中间件层
- Web服务:QPS、响应时间、错误率、并发连接。
- 数据库:慢查询、连接池、主从延迟、锁等待。
- 消息队列:堆积量、消费速率、重试次数。
- Java应用还要看JVM堆、GC次数、线程池。
网络与可用性层
- ping、TCP端口探测、HTTP状态码、DNS解析、证书到期。
- 多云场景可用拨测节点,从不同地域访问业务入口。
日志与调用链层
- 日志采集用Filebeat、Promtail、Fluent Bit。
- 链路追踪用OpenTelemetry、SkyWalking、Jaeger。
- 关键是把TraceID和日志关联起来,否则排障仍然靠猜。
服务器监控有哪些方法:从轻到重六类落地手段
Linux服务器监控常用命令与系统工具
临时排查优先用系统自带工具。journalctl -xe看服务报错,dmesg看内核和硬件异常,ipmitool sensor看物理机温度、风扇、电源,命令行的优点是快,缺点是无法长期留痕和自动告警。

脚本加定时任务
小规模环境可以用Shell或Python采集指标,通过cron写入文本、InfluxDB或Prometheus textfile,适合采集业务自定义指标,比如订单积压、队列长度,维护成本会随服务器数量上升。
开源监控系统
| 工具 | 适合规模 | 优点 | 注意点 |
|---|---|---|---|
| Zabbix | 中大型传统环境 | Agent成熟,告警联动强 | 配置较重 |
| Prometheus+Grafana | 云原生、容器 | 多维指标,生态丰富 | 长期存储需扩展 |
| Netdata | 单机、小规模 | 开箱即用,面板细 | 大规模集中管理弱 |
| Nagios/Checkmk | 传统IT | 插件多,检查灵活 | 上手门槛不低 |
商业监控平台与云厂商监控
Datadog、New Relic等商业平台强在开箱即用、多地域探针、APM和SLO管理,简米云云监控、酷番云可观测平台、华为云CES适合云上资源,缺点是成本随主机数、指标量、日志量上升。
日志、APM与链路追踪
ELK/EFK适合日志检索,Loki更轻量,SkyWalking适合Java微服务,APM能定位到方法级耗时,但采样和存储成本要提前算。
带外与硬件监控
物理服务器不能只靠操作系统,IPMI、Redfish、SNMP可以监控电源、风扇、温度、RAID,云服务器则通过云API获取宿主机和实例指标,业内专家指出,监控工具本身不产生价值,告警后的处置效率才决定稳定性。
中小企业服务器监控方案怎么选
按服务器规模选
- 1到5台:Netdata、Uptime Kuma、脚本加邮件告警。
- 5到50台:Prometheus+Grafana或Zabbix,配Alertmanager。
- 50台以上:VictoriaMetrics、Thanos、Mimir或商业SaaS,重点解决长期存储和高可用。
按部署场景选
- 纯云环境:云监控加日志服务,再补Prometheus。
- 物理机机房:Zabbix、SNMP、IPMI组合。
- 混合云:统一标签体系,避免一套云一个面板。
- Kubernetes:metrics-server、Prometheus Operator、kube-state-metrics。
服务器监控软件免费和付费区别
免费开源省许可费,但需要人力部署、调优、升级和值班,付费方案省部署和多地域探针,通常按主机数、指标量、日志量、保留时长计费,行业共识认为,单靠一种工具很难覆盖所有场景。
北京服务器监控服务价格受什么影响
北京服务器监控服务价格通常受监控节点数、指标量、日志量、数据保留时长、告警通道、是否驻场、SLA要求影响,只监控主机资源和包含APM、日志、拨测的价格差异较大,询价时先给清单,再让服务商按采集、存储、告警、值守拆分报价。
服务器监控落地步骤:从零搭一套可验证体系
确定指标与SLO
据Google SRE公开资料,延迟、流量、错误、饱和度适合作为起点指标,先定业务SLO,再反推告警阈值,不要所有指标都告警。
部署采集器
以Prometheus为例:
- 在目标机下载并解压node_exporter。
- 启动:
./node_exporter & - 写入systemd服务:
/etc/systemd/system/node_exporter.service - 在Prometheus配置:
scrape_configs: - job_name: 'node' static_configs: - targets: ['192.168.1.10:9100'] - 重载:
curl -X POST http://localhost:9090/-/reload
配置存储与可视化
Grafana添加Prometheus数据源,导入Node Exporter面板,关键面板保留CPU、内存、磁盘、网络、文件描述符、进程数,日志用Loki或Elasticsearch,按主机和应用打标签。
配置告警与值班
Alertmanager配置分组、抑制、静默,企业微信、钉钉、飞书通过webhook接入,告警分警告和严重,严重告警才电话通知,值班表要覆盖业务高峰。
演练与复盘
- 手动填磁盘:
dd if=/dev/zero of=/tmp/test bs=1M count=1024 - 停止服务:
systemctl stop nginx - 断网或封端口,观察告警是否按预期到达。
- 每月复盘误报、漏报、平均恢复时间。
服务器监控有哪些方法常见问题
服务器监控CPU内存磁盘网络怎么设置阈值?
阈值不能拍脑袋,按业务基线分警告和严重,CPU持续高位、内存持续上涨、磁盘剩余空间低于安全线、网络丢包持续出现,才值得打扰值班人员,告警要做分组和抑制,避免一台机器抖动触发几十条通知。
云服务器监控和物理服务器监控区别大吗?
区别较大,云服务器有云API、宿主机指标、负载均衡、数据库等托管服务指标;物理服务器需要IPMI、SNMP、带外管理和RAID卡工具,云上可以先用云监控,物理机更适合Zabbix加SNMP。
服务器监控软件免费和付费区别是什么?
免费开源省许可费,但采集、存储、告警、升级、值班都要自己扛,付费SaaS省部署和多地域探针,按主机、指标、日志、保留时长计费,最终选择取决于团队能否承担采集、存储、告警和值班维护。
服务器监控没有唯一答案,核心是围绕业务SLO选择方法组合,并形成采集、告警、处置、复盘的闭环。 能稳定发现故障,并让值班人员快速定位,才是有效监控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/747958.html