矩阵集群服务器并不是某一台具体型号,而是一类通过高速网络、统一调度和共享存储,把多台服务器连成矩阵式算力池的集群方案,常见形态包括GPU计算集群、HPC集群、超融合集群、容器集群、数据库集群和边缘集群,品牌上可关注浪潮、华为、联想、曙光、新华三、戴尔、HPE、超微等公开产品线。
矩阵集群服务器有哪些主流形态
矩阵集群服务器的核心思路是“多节点协同”,不是单机堆配置,按任务类型分,落地时通常落在下面几类。

计算型矩阵集群:GPU与HPC
这类集群面向AI训练、科学计算、仿真和渲染,节点内常见多卡GPU,节点间用InfiniBand或RoCE组网。
- GPU训练集群:适合大模型微调、推理、图像识别。
- CPU HPC集群:适合气象、流体、分子动力学。
- 调度软件:Slurm、PBS、LSF较常见。
- 验证命令:
sinfo、scontrol show node、nvidia-smi。
存储型矩阵集群:Ceph、Lustre与分布式文件系统
计算再强,数据读不快也会卡住,存储型矩阵集群把多台存储节点组成统一命名空间。
- 对象存储:Ceph RGW、MinIO。
- 文件存储:Lustre、BeeGFS、CephFS。
- 块存储:Ceph RBD、iSCSI。
- 检查命令:
ceph -s、ceph osd tree、df -h。
超融合与虚拟化矩阵集群
超融合把计算、存储、网络虚拟化整合到同一批节点,常见于企业私有云、分支机房和信创环境。
- 优势是部署快、横向扩展方便。
- 适合虚拟机、桌面云、轻量数据库。
- 需关注副本策略、缓存盘和网络收敛比。
容器与微服务矩阵集群
这类集群以Kubernetes为核心,节点像矩阵一样排布,工作负载按Pod调度。
- 常见组件:kube-apiserver、etcd、kubelet、CNI、CSI。
- GPU场景会加装GPU Operator。
- 检查命令:
kubectl get nodes -o wide、kubectl top nodes。
数据库与大数据矩阵集群
MySQL、PostgreSQL、ClickHouse、Hadoop、Spark等都可组成集群,重点在一致性、分片和副本。
- OLTP集群:主从、MGR、Paxos类协议。
- OLAP集群:MPP架构、列式存储。
- 大数据集群:HDFS、YARN、Hive、Spark。
边缘矩阵集群
边缘场景把多个小节点放在园区、工厂、门店,算力不大,但要求低延迟、离线可用、远程运维。
- 常见形态:边缘一体机、微型数据中心。
- 关键指标:功耗、宽温、远程带外管理。
矩阵集群服务器和普通服务器有什么区别
普通服务器更关注单机稳定和接口扩展,矩阵集群服务器更关注节点间协同,业内专家指出,矩阵集群的瓶颈往往不在单机算力,而在网络和存储。
| 对比项 | 普通服务器 | 矩阵集群服务器 |
|---|---|---|
| 扩展方式 | 纵向升级CPU、内存、硬盘 | 横向增加节点 |
| 网络要求 | 千兆或万兆常够用 | 万兆起步,HPC常用IB/RoCE |
| 存储方式 | 本地盘或外接阵列 | 分布式存储、共享文件系统 |
| 调度方式 | 人工分配 | Slurm、K8s、YARN等 |
| 故障影响 | 单机故障影响大 | 可副本、可迁移、可重调度 |
| 运维复杂度 | 相对低 | 需要监控、日志、自动化 |
| 成本结构 | 一次性采购为主 | 硬件、网络、电力、软件、人力 |
如果只是跑一个网站、文件共享或轻量数据库,普通服务器更省心,如果要跑分布式训练、批量仿真、容器平台,矩阵集群服务器更合适。
矩阵集群服务器有哪些主流品牌与产品线
矩阵集群不是单一品牌,而是“服务器节点+网络+存储+调度软件”的组合,下面这些是公开可见的主流产品线。
| 厂商 | 公开产品线/方案 | 常见场景 |
|---|---|---|
| 浪潮 | NF、TS、AI服务器方案 | HPC、AI训练、智算中心 |
| 华为 | FusionServer、昇腾AI集群 | 政企、AI、信创 |
| 联想 | ThinkSystem、ThinkAgile | 企业虚拟化、超融合 |
| 中科曙光 | I系列、UX系列、HPC方案 | 科研、气象、仿真 |
| 新华三 | UniServer、UIS超融合 | 私有云、政企 |
| 戴尔 | PowerEdge、PowerScale | 通用企业、GPU集群 |
| HPE | ProLiant、Cray HPC方案 | 高性能计算 |
| 超微 | SuperServer、GPU服务器 | 高密度GPU集群 |
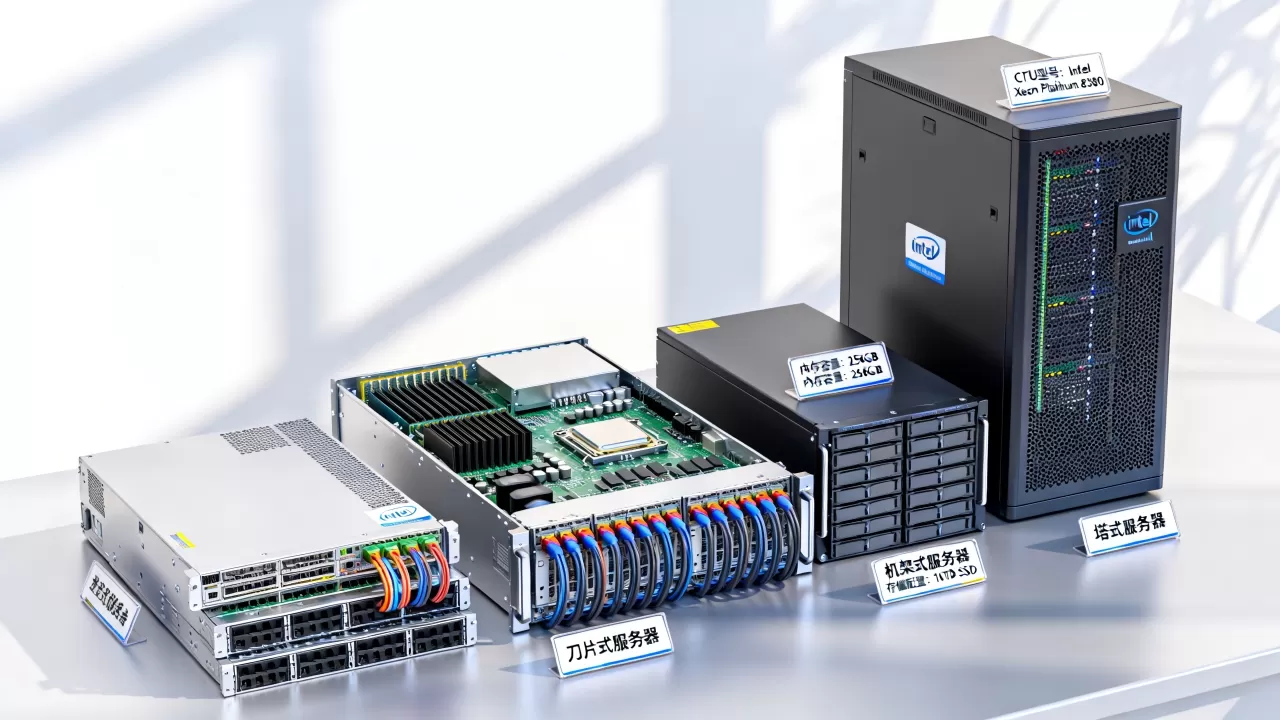
选型时别只看品牌,要确认节点是否支持需要的GPU、网卡、NVMe,机柜供电是否够,售后是否覆盖本地。
小型企业搭建矩阵集群服务器需要多少钱
这个问题没有统一报价,成本由GPU、交换机、存储、机柜、电力和运维决定,入门级测试集群可能在数万元到十几万元,中高端GPU集群可能到数十万元甚至更高。
成本通常包括:
- 计算节点:CPU、内存、GPU、本地NVMe。
- 网络设备:万兆交换机、IB交换机、光模块、线缆。
- 存储设备:分布式存储节点、SSD、HDD、缓存盘。
- 机柜配套:PDU、UPS、空调、动环监控。
- 软件与授权:调度平台、虚拟化、容器平台、监控。
- 运维人力:部署、巡检、故障处理、扩容。
预算有限时,先搭3节点Kubernetes或Slurm小集群,跑通调度、存储、监控后,再按任务扩展,行业共识认为,先跑通调度和监控,再扩节点,比一次性堆硬件更稳。
北京矩阵集群服务器租用与本地部署怎么选
北京及周边IDC机柜、带宽和电力成本通常高于部分二三线城市,选租用还是本地部署,要看项目周期和数据要求。
北京矩阵集群服务器租用适合谁
- 项目周期短,三到六个月就要交付。
- 算力需求波动大,训练高峰明显。
- 团队没有机房运维经验。
- 需要北京本地低延迟节点,服务北方用户。
- 希望按周期付费,减少一次性采购。
本地部署适合谁
- 数据敏感,要求内网闭环。
- 长期稳定负载,三年以上使用。
- 已有电机、机柜、网络和运维团队。
- 需要深度定制硬件和调度系统。
- 希望资产化,方便折旧和信创合规。
实操上,可以先在北京租用少量GPU节点验证业务,确认调度、存储、网络稳定后,再决定是否把核心数据迁回本地。
矩阵集群服务器搭建与验证实操步骤
下面以通用Linux集群为例,给出可验证路径。
- 规划节点角色:管理节点、登录节点、计算节点、存储节点。
- 安装系统:Rocky Linux、Ubuntu Server或国产Linux。
- 配置基础服务:NTP、DNS、SSH免密、主机名解析。
- 部署调度器:Slurm或Kubernetes,Slurm检查用

sinfo
- 安装GPU驱动:
nvidia-smi确认卡状态。 - 配置高速网络:IB卡用
ibstat,RoCE检查PFC和ECN。 - 部署共享存储:Ceph用
ceph -s,Lustre检查挂载点。 - 配置容器平台:
kubectl get nodes确认节点就绪。 - 部署监控:Prometheus、Grafana、DCGM、Node Exporter。
- 压力测试:HPL、NCCL Tests、fio、ib_send_bw。
- 建立巡检:温度、功耗、磁盘、网络、任务队列。
- 编写文档:账号、队列、存储路径、故障上报流程。
命令能跑通,不等于生产可用,还要做权限、配额、日志、备份和告警。
矩阵集群服务器选型常见坑
- 只看CPU核数,忽略内存带宽和NUMA。
- 用千兆网络跑分布式训练,通信成瓶颈。
- 没有共享存储,数据拷贝拖慢任务。
- 忽略机柜供电和散热,扩容时才发现电不够。
- 没有统一监控,故障靠用户报修。
- 调度器配置混乱,资源利用率低。
- 忽略国产化兼容,后期迁移成本高。
- 只买硬件,不预留运维预算。
矩阵集群服务器不是买回来就完事,它更像一套持续运营的算力系统。
矩阵集群服务器常见问题Q&A
矩阵集群服务器有哪些典型应用场景?
典型场景包括AI训练与推理、科学计算、影视渲染、基因测序、金融风控、工业仿真、私有云和边缘计算,判断标准是任务能否拆成多节点并行,能拆,就适合矩阵集群,不能拆,单机高配可能更划算。
矩阵集群服务器和普通服务器有什么区别?
普通服务器强调单机稳定和纵向扩展,矩阵集群服务器强调多节点横向扩展、统一调度、共享存储和高速网络,前者适合常规业务,后者适合并行计算和高并发平台,两者不是替代关系,而是按任务匹配。
矩阵集群服务器租用和购买怎么选?
短期项目、波动算力、测试验证优先租用,长期稳定负载、数据敏感、已有运维团队可考虑购买,租用按周期计费,购买要承担折旧、电费、机柜和人力成本。
矩阵集群服务器的关键不在“有哪些型号”,而在“节点、网络、存储、调度、运维”能否组成稳定矩阵,按任务选形态,按预算定租买,先小规模验证再扩展,通常比盲目堆硬件更有效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/748197.html