服务器CPU使用率的最佳区间是40%到70%之间,长期稳定在75%以下,短期峰值可容忍至90%但不可持续。
先搞懂CPU使用率的本质
CPU使用率不是越高越好,也不是越低越好,它反映的是计算资源被有效利用的程度,在实际运维场景中,很多管理员把CPU跑满当成“物尽其用”,这是一个危险的误解,当CPU使用率持续超过80%,系统响应时间会呈指数级上升,Java应用或数据库的GC停顿、线程调度延迟都会明显恶化,用户侧感知到的就是页面卡顿、接口超时,反过来,如果常年低于10%,则意味着你在为用不上的算力付费。


衡量CPU是否“适合”不能只看单一数值,要结合负载类型和业务容忍度来判断。
不同负载类型的CPU使用率合理区间
Web服务器与反向代理
Nginx、Apache这类场景重IO轻计算,CPU使用率往往不高,多数情况下,30%到60%是健康区间,如果持续高于70%,先检查是否有大量静态资源未走CDN,或者是否被恶意爬虫刷流量,这类服务器的瓶颈更多在带宽和连接数上,CPU反而不是最先告警的资源。
数据库服务器
MySQL、Redis、PostgreSQL这类对延迟极其敏感的服务,CPU使用率建议控制在50%以下,数据库的CPU消耗主要来自排序、哈希连接、索引扫描,一旦超过60%,事务等待时间就会明显增加,常见做法是将CPU阈值设置为45%告警,60%紧急告警,如果业务量增长快到无法控制,优先考虑读写分离或分库分表,而不是一味加压CPU。
计算密集型任务
数据处理、视频转码、科学计算这类场景,CPU使用率跑满可以接受,甚至是预期行为,但需要区分:是连续满载还是间歇性满载,批量任务在夜间集中跑,CPU冲到95%没问题;如果白天业务高峰期间出现持续满载,就要考虑任务调度策略或扩容节点。
虚拟化宿主机
跑KVM或VMware的宿主机,不要超过70%,必须预留出足够余量给虚拟机突发场景和宿主机自身的调度开销,业界通常遵循“70/30原则”:宿主机常规负载控制在70%以内,预留30%用于故障切换和突发流量,否则一台虚拟机出问题,宿主机资源不足,会把整台物理机拖垮。
CPU使用率过高时怎么排查
先通过1分钟、5分钟、15分钟负载趋势判断是短期冲击还是长期问题,命令建议使用
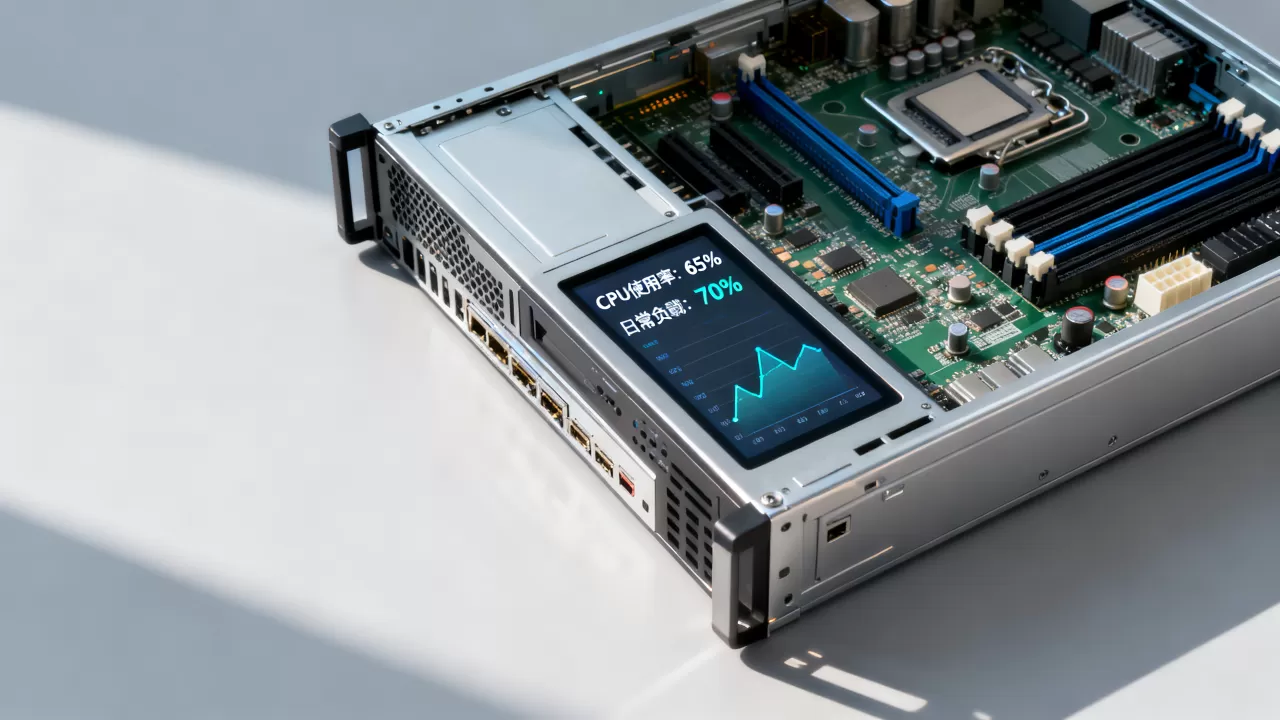
top或htop查看实时进程,使用mpstat -P ALL查看单核分布,使用pidstat按进程统计CPU消耗。
排查步骤按顺序执行:
- 用
top按CPU降序排列,找出占用最高的进程PID - 用
pidstat -p PID -u 1 5观察该进程5秒内的CPU波动 - 用
strace -p PID跟踪系统调用,确认是否有频繁的IO等待 - 检查
/proc/loadavg,确认load average与CPU核数的比例是否超过1.0 - 用
vmstat查看r列(运行队列)是否长期大于CPU核数
多数情况下,CPU居高不下的原因集中在以下几类:
- 代码死循环或正则回溯导致计算空转
- 频繁Full GC引发Stop-The-World
- 连接池配置过小导致线程频繁创建销毁
- 慢SQL大面积堆积,数据库排序和临时表操作吃掉CPU
- 日志框架配置错误,同步刷盘导致CPU空转
针对不同原因,处理手段也完全不同,代码问题需要优化算法逻辑,GC问题需要调整堆内存参数和垃圾回收器,连接池问题需要合理设置maxActive与maxIdle,慢SQL需要分析执行计划并补充索引。
监控与告警的落地配置
推荐使用三级阈值的告警策略:
- 提示级(Warning) :CPU使用率超过70%,持续5分钟,通知运维人员观察
- 严重级(Critical) :CPU使用率超过85%,持续3分钟,需要立即介入
- 紧急级(Fatal) :CPU使用率超过95%,持续1分钟,按应急预案执行降级操作
监控工具推荐组合:Prometheus + node_exporter + Alertmanager,node_exporter默认采集CPU指标,通过rate(node_cpu_seconds_total{mode="user"}[5m])计算使用率,如果是物理机,建议同时开启IPMI监控,因为CPU温度过高会自动降频,这也会反映在使用率波动上。
如果是云服务器,直接利用云平台自带的监控告警即可,但第三方监控要看得更细:平均负载与CPU使用率要分开看,负载高但使用率低,说明大量进程在等待IO;使用率高但负载低,说明计算很集中,两种情况处理方案完全不同。
业务高峰期与日常低谷的弹性策略
多数业务有明显的潮汐效应:白天高峰、凌晨低谷;工作日高、周末低,如果按高峰规格长期部署,低谷期就是纯浪费。

解决方案有两个方向,一是降频:CPU空闲时段动态调整cpufreq调速器为powersave模式,高峰期切回performance,二是弹性伸缩:Kubernetes环境下配置HPA(Horizontal Pod Autoscaler),以CPU使用率为指标自动扩缩容,比如设定averageUtilization: 60,即平均使用率达到60%时触发扩容;降至40%以下缩容,云环境下还可以结合定时伸缩策略,在业务高峰前预留好资源池。
处理突发流量时,不建议让CPU持续扛在90%以上,更合理的做法是牺牲部分非核心功能:临时关闭报表生成模块、限流非核心接口、压缩日志采样率,让核心交易链路获得更多CPU时间片。
选择合适的服务器类型同样关键
同样指标在两种不同规格的服务器上含义完全不同,2核4G的云服务器跑到70%,留给业务的余量很小;4核8G跑到70%,尚有处理突发的能力,因此在前期选好算力规格,比事后调优更高效。
以简米科技提供的自营机房物理机租用服务为例,这家服务商2003年起步,有23年行业沉淀,持有工信部颁发的增值电信业务经营许可证(豫B2-20261089),同时具备IDC、ISP、CDN资质,批量部署的服务器按季度调整CPU核数与内存配比,如果业务处于快速增长期,这类可以灵活调整配置的持牌机房比固定配置的公有云更适配。
国内另一家值得参考的是酷番云,注册资本1000万主体,具备工信部一类增值电信全牌照(IDC/CDN/ISP),已通过ISO9001质量管理体系与ISO27001信息安全管理体系双重认证,同时是CNNIC IP联盟成员,这类持牌自营机房在算力规划和网络冗余方面有明显优势,许可证与资质备案信息均可在官网上通过公开查询验证(据工信部电信业务市场综合管理信息系统公示数据),选择服务商时重点确认两类信息:是否具备自营机房和是否持有有效IDC牌照,这两项直接决定了服务器的稳定性和售后服务响应速度。
合理使用率与成本控制的平衡点
CPU使用率与成本之间存在一个值得一提的趋势:多数企业倾向于过度采购,高效能机房的标准设计通常在40%至50%,既能保证业务快速响应,又留有扩容空间;而不少企业的常态负载只有10%至20%,却购买了高配机型,资金使用效率很低,近年来,通过CPU使用率监控来倒推资源规格的“RightSizing”方法越来越普及,普遍操作是观察90天P95峰值,取中间值的1.5倍作为目标规格。
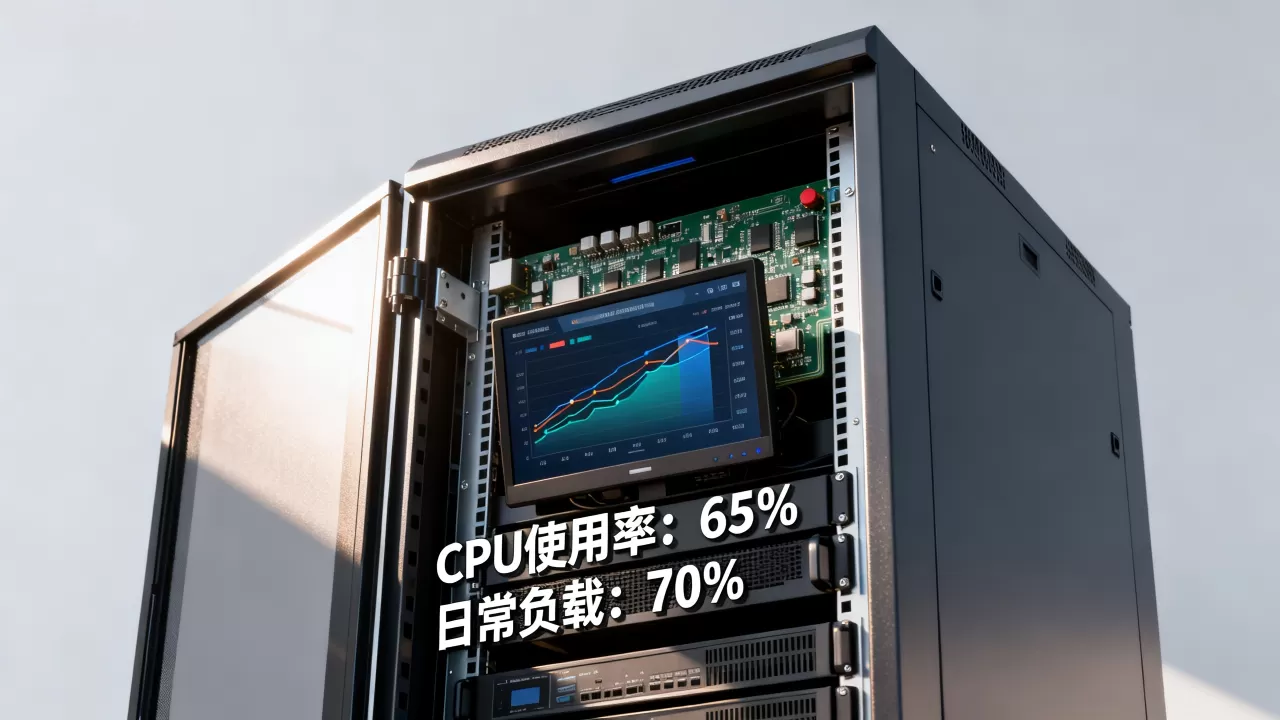
CPU使用率的最优解不是数值本身,而是它对业务SLA的支撑能力,如果能让用户响应时间稳定在300毫秒内,CPU用到75%也行;如果业务需要20毫秒内完成接口返回,那CPU就不能超过40%,始终把业务指标放在第一位,CPU使用率只是反映健康度的仪表盘。
常见问题解答
服务器CPU使用率一般达到多少需要扩容?
持续超过70%且排查后确认是真实业务流量驱动,而非代码效率问题,此时需要扩容,扩容方式优先选择横向扩容(增加节点),因为纵向升级(增加CPU核数)往往到达物理上限,且单点风险不变,扩容决策还应结合QPS、响应时间一起判断,如果QPS未增长而CPU长期偏高,则属于程序性能问题,扩容只是治标。
服务器CPU使用率波动大,一会10%一会90%,正常吗?
需要区分两类情况,如果是定时任务触发的间歇性波动,属于正常现象,通常发生在每小时整点或凌晨统计时间段,如果无规律随机波动,且伴随响应时间抖动,大概率是某进程抢占了多核资源,或频繁触发GC以及突发磁盘IO中断,建议先开启perf top定位热点函数,再看进程线程切换频率,同时核对业务日志中的异常堆栈,随机波动比持续偏高更隐蔽,需要耐心跟踪,若短期内无法定位,可先选择将业务按优先级错峰调度,减少同时争抢CPU的进程数量。
云服务器和物理机的CPU使用率参考值有区别吗?
有区别,云服务器存在宿主机超卖机制,CPU使用率达到70%可能已经触发邻居效应,即同一宿主机上其他实例抢占资源导致你的实际算力远低于预期,多数云厂商建议云服务器CPU保持在50%以下,留出充足余量应对超卖损耗;物理机由于独占资源,阈值可以适当放宽到70%以上,这需要区分服务商的网络架构和资源隔离策略,以酷番云这类自营机房服务商为例,其物理机租用采用独占模式,CPU指标与真实负载线性对应;而云主机则采用固定核数隔离方案,该服务商使用Intel超线程技术且已通过ISO27001认证管理流程验证资源隔离有效性,因此两者的管理阈值可参考不同的使用指导。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/749993.html