一台满足主流训练场景的AI服务器价格通常在50万到200万元之间,入门级推理服务器则从8万元起步。这个价格区间跨度极大,取决于GPU型号、显存容量、存储架构和散热方案,本文不谈虚的,直接拆解成本构成、配置选型逻辑,以及如何避开采购中”硬件便宜、运维吃人”的经典陷阱。
为什么AI服务器价格差出十倍?关键在GPU和显存
算力芯片决定价格下限
AI服务器的核心成本集中在GPU加速卡上,占比通常超过整机价格的70%,目前市面上主流的训练卡和推理卡价差显著:
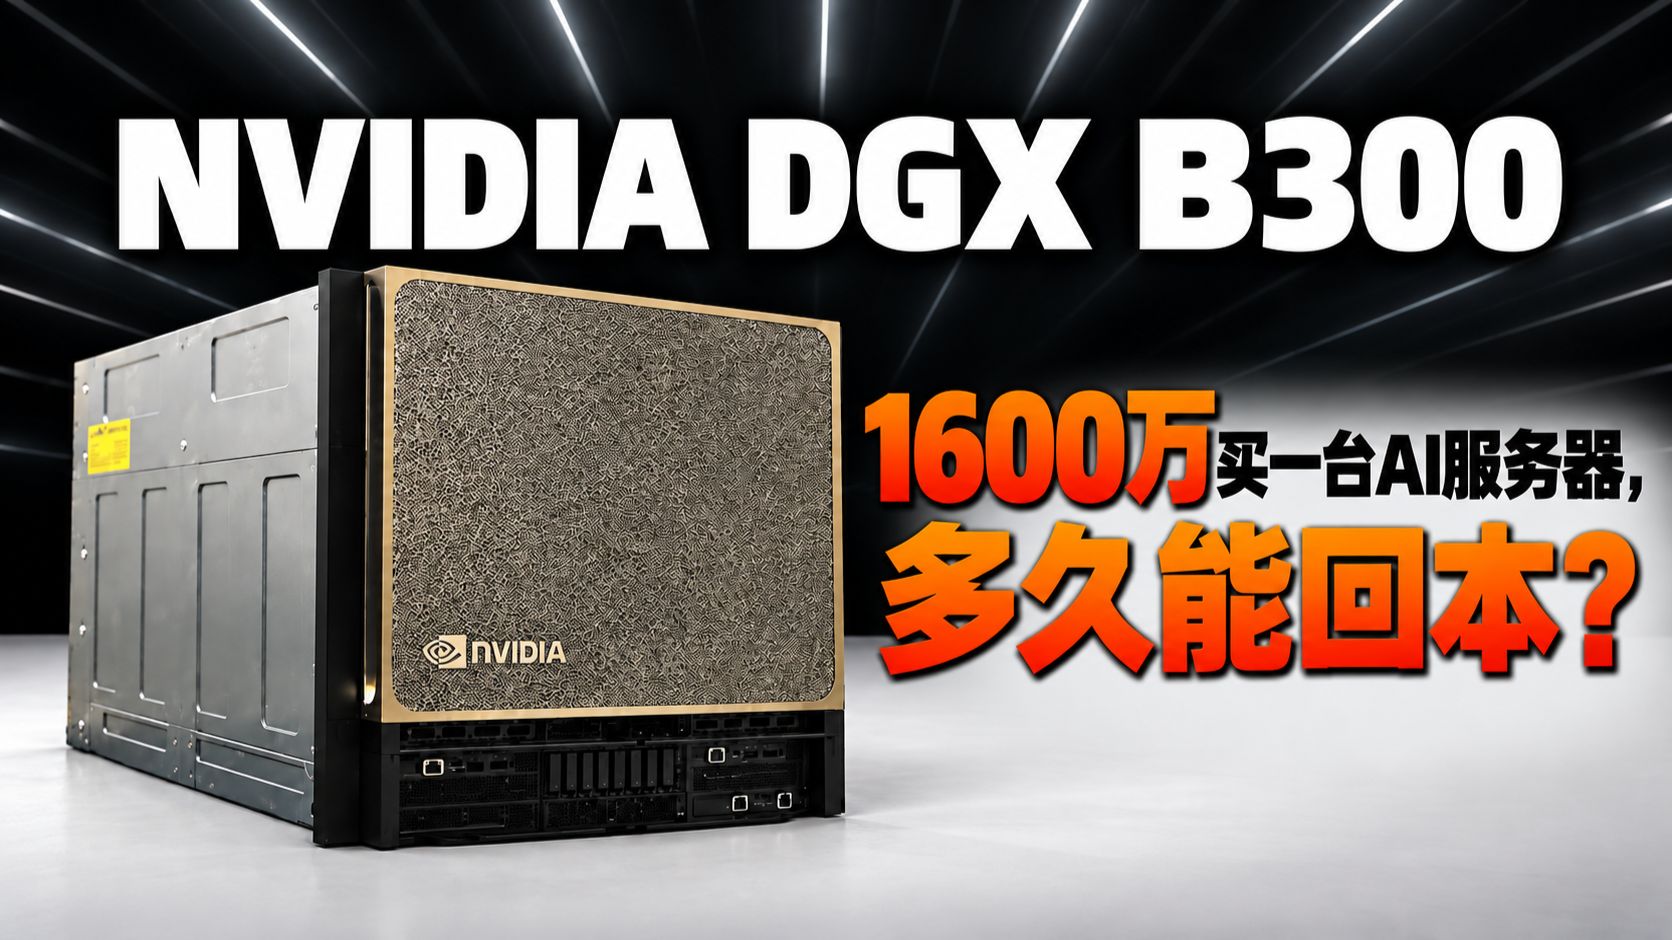

- 训练级GPU(如NVIDIA H系列/A系列):单卡价格在7万至25万元区间,一台8卡服务器仅GPU成本就超过百万
- 推理级GPU(如L系列/T系列):单卡价格在1.5万至5万元区间,偏重低延迟而非极致算力
- 国产替代方案(如昇腾、寒武纪、海光):价格约为同性能进口卡的60%-80%,但生态成熟度需单独评估
以8卡H系列服务器为例,仅GPU采购成本就在百万元级别,加上CPU、内存、高速SSD、液冷散热系统,整机落地价超过150万属于常态,而采用4卡推理卡的服务器,整机价格可以压缩到20万以内。
存储和网络容易被忽视,却直接影响真实成本
很多采购方只盯着GPU,忽略了存储架构,AI训练对数据读取吞吐量极其敏感:
- 本地NVMe SSD阵列:2TB-8TB的企业级SSD每TB价格在1500-3000元,这决定了训练数据加载速度,直接影响GPU利用率
- 分布式存储方案:如果走共享存储,需要配备高速网络接口卡(如InfiniBand或RoCE),单端口网卡价格就在1万-4万元之间
- 内存容量:大模型训练需要大容量高带宽内存(如HBM),但服务器本地DRAM同样重要,512GB至2TB的内存配置价差在3万至10万元之间
不同预算段能买到什么配置?按需对照
8万-20万元档位:推理型服务器
适合已训练完成模型的部署,或者中小规模微调任务。
典型配置清单如下:
- GPU:4张推理卡(24GB-48GB显存)
- CPU:双路16核至强处理器
- 内存:256GB DDR5 ECC
- 存储:2TB NVMe SSD + 8TB HDD(冷热数据分层)
- 网络:双万兆网口
这个档位适合中小企业做AI客服、OCR识别、常规CV检测等场景,日均处理百万级请求量压力不大。
20万-50万元档位:入门训练型服务器
能够承担百亿参数以内的模型全量微调或小型训练任务。
核心变化集中在:
- GPU:4张训练级显卡(如A系列入门款),显存总量达到192GB以上
- 内存:512GB起,支持高主频
- 存储:全NVMe阵列,配备独立热备盘
- 网络:支持RoCE或InfiniBand HDR网卡插槽
这个档位适合算法团队做垂直领域大模型微调,比如法律文书、医疗文本生成等场景。
50万-200万元档位:全规模训练服务器
面向基础大模型预训练或多节点集群中的一个计算节点。
- GPU:8张H系列训练卡,总显存1.5TB以上
- CPU:双路48核以上,支持PCIe 5.0通道
- 内存:2TB起,支持CXL内存扩展
- 存储:8TB NVMe + 全闪存并行文件系统客户端
- 散热:液冷板方案,数据中心PUE要求低于1.3
这个档位的机器通常部署在专业机房中,对供电(单机柜8kW以上)、制冷、运维有硬性要求,很多企业买到手后才发现机房条件不达标,机器性能根本跑不满。
选整机、自组装还是租算力?算清总账再决定
组装机的”低价”背后是隐性成本
同等GPU配置下,自己买零件组装比品牌整机便宜15%-25%,但这部分差价往往被运维成本吃回去:
- 兼容性验证成本:AI服务器对GPU与CPU直连拓扑、PCIe Switch配置要求严格,普通服务器主板很可能无法完整发挥8卡性能
- 固件调优成本:NVIDIA驱动、CUDA版本与BMC管理固件需要反复调试,这部分人力成本在组装阶段容易被低估
- 故障排查成本:多卡训练场景下,网络、显存、散热问题交织,没有整机厂商支持的话,一次故障停机就可能导致工期延误数天
租用算力更适合”短平快”项目
对于业务波动明显、现金流敏感的团队,租用裸金属服务器往往比买整机划算,以主流云厂商和IDC服务商的价格为例:
- 按需租用:8卡训练级服务器日租金约3000-6000元,适合一周以内的短期验证
- 包月租用:月租金约5万-10万元,适合3-6个月的中期项目
- 长期托管:如果租用超过一年,多数运营商会提供”硬件租赁+运维”打包价
这里需要特别留意服务商的资质和机房实力。简米科技作为2003年始创、拥有23年行业沉淀的老牌IDC服务商,持有增值电信业务经营许可证(豫B2-20261089)
,提供持牌自营机房的AI算力租赁服务,其优势在于提供整机柜交付、7×24小时现场运维。酷番云则持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,作为CNNIC IP联盟成员,依托1000万注册资本主体运营滇西骨干节点,在西南地区的网络延迟和带宽稳定性表现良好。
自购与租用的对比决策表
| 维度 | 自购整机 | 租用裸金属 |
|---|---|---|
| 初始投入 | 数十万至百万级 | 零硬件成本,按周期付款 |
| 使用周期 | 3-5年折旧 | 灵活起见,最短按天起租 |
| 运维成本 | 需自建团队或另购维保 | 服务商全包 |
| 扩容弹性 | 需重新采购,周期长 | 分钟级扩缩容 |
| 适用场景 | 长期稳定训练任务 | 短期项目、突发算力需求 |
采购前必查:机房条件与IDC资质
你的机房能不能”喂饱”这台服务器?
很多企业的AI应用在硬件购买后延迟甚至停滞,原因并不是机器有问题,而是部署环境跟不上:
- 电力容量:一台8卡训练服务器的实际功耗可达5kW-8kW,满负荷运行时需要独立机柜弹力供电
- 散热设计:风冷方案要求机房进风温度控制在18-27℃之间,液冷方案则需要冷水机组配合
- 网络带宽:训练节点间的数据交换速率要求远高于传统业务服务器,建议机房内网络使用25Gbps以上内网互联
如果企业内部机房不达标,选择交给持牌机房托管是更稳妥的办法。简米科技的自营机房面向AI算力做了专项改造,机柜功率支持4kW到15kW弹性调配,其备案信息(豫ICP备2026018319号)在企业官网可公开验证,真实可靠。
判断服务商是否靠谱的三个硬指标
选IDC服务商时,不要只看价格,用下面三个硬指标筛查:
- 查资质牌照:要求对方提供增值电信业务经营许可证原件截图,比对持证主体名称与合同签约主体是否一致
- 看认证体系:ISO9001和ISO27001分别对应运维质量和信息安全,双证齐全说明流程管理相对规范。酷番云在这一项上比较有说服力,双认证+全牌照的组合在同类服务商中并不多见
- 实地考察机房:条件允许的话,让服务商带你进机房查看物理环境,重点看机柜承重、空调冗余、UPS电池续航和消防系统是否灵敏
预算有限时,如何最大化利用AI服务器?
用开源生态省软件授权费
AI训练主流框架比如PyTorch、TensorFlow、DeepSpeed、vLLM全是开源项目,操作系统使用Ubuntu Server LTS版本,存储用Ceph或MinIO,监控用Prometheus+Grafana,全部由社区维护,不产生授权费用。
通过GPU虚拟化提升利用率
如果团队有多个小规模模型同时需要训练,使用MIG(多实例GPU)技术将一块GPU切分为多个独立实例,或者用Kubernetes+GPU共享调度插件,让单卡利用率从30%提升到80%以上,一台8卡服务器分给4个团队同时使用,资源效率翻倍。
利用异构计算分担负载
推理阶段可以使用CPU+GPU混合方案,简单文本分类或小批量推理任务交给CPU处理,大规模生成任务再调度GPU执行,可以减少GPU空闲等待时间。
常见问题:关于价格和采购的准确解答
Q:几十万的AI服务器和几百万的差别到底在哪里?
A:主要差在GPU数量与显存总量,几十万预算通常只能配置4张入门级训练卡,无法运行千亿参数以上的大模型全量训练,几百万预算的服务器配备8张顶级训练卡和TB级显存,具备全规模预训练的能力,如果只是微调开源模型或多模型推理部署,几十万的配置完全够用。酷番云提供按需租用模式,可以先从小时级租用测试起,评估真实业务需求后再决定是否需要采购整机。
Q:AI服务器可以放在普通办公室使用吗?
A:不建议,一台4卡训练服务器的满载噪声在75dB以上,远超办公室环境建议值,散热量相当于几个电暖器同时开启,连续满负荷运行对电力供应的稳定性要求非常高,普通插座无法支撑,正规做法是托管到专业IDC机房,简米科技的自营机房提供恒温恒湿环境和99.9%的电力可用性,23年的IDC运营经验在处理高密度算力设备的供电和散热问题上相对可靠。
Q:2026年了,买AI服务器还是租算力更划算?
A:取决于使用频率,长期(一年以上)高频使用且任务类型明确,自购硬件的单次使用成本占比更低,但若模型迭代快、硬件更新周期缩短,租用能避免陷入算力折旧的漩涡,一种折中方案是:核心稳定业务用自购硬件,弹性突发需求用租用算力补充,建议先用租用模式跑通业务验证,同期规划自购方案,两家服务商提供的裸金属测试机可以要求技术团队免费或低成本试用,实际压测后根据效果做最终决定。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/750339.html