服务器CPU温度在40℃到60℃之间属于健康区间,满载运行时短暂上探到80℃以内也基本安全,超过85℃就需要立即排查散热。低于这个认知,很多运维在夏天一看到70℃就慌了手脚,其实远没到临界点,理解了这条基准线,再往下看不同场景下的温度波动和应对手段,你就能做到心里有数。
服务器CPU正常温度的核心判断标准
CPU温度不是单一固定数值,它受机型、功耗、环境温度、负载类型影响极大,行业参数里通常把温度分为三个区间,安全区(40℃-70℃)、警戒区(70℃-85℃)、危险区(85℃以上),这个划分依据来自Intel和AMD官方公布的最高结温(Tjunction)规格,两家白皮书均明确列出大部分服务器级CPU的Tjmax在100℃左右,而长期运行在90℃以上会显著加速电子迁移效应,导致处理器寿命打折。

不同负载形态下的温度表现
轻载状态(CPU占用率低于30%),比如只跑Nginx、Redis或数据库连接池,温度通常在40℃到55℃,这时候风扇转速低,噪音也小,属于日常待机节奏。
中载状态(CPU占用率50%-70%),例如常规的Java应用服务或日志处理流水线,温度集中在55℃到70℃,散热风扇会明显提速,进风口和出风口的温差拉大。
满载状态(CPU占用率90%以上),压测、视频转码、大规模数据计算场景下,75℃到85℃是正常区间,如果你用的是顶级的多路至强或者EPYC处理器,满载温度逼近90℃在密集计算节点里也不罕见,只要不触顶降频,都算合理。
Intel和AMD平台之间的温度差异
Intel Xeon系列普遍集成更高的发热密度,同样功耗下核心面积小,温度读数往往比AMD EPYC高出5℃左右,AMD EPYC采用chiplet多芯片设计,热量分散,温度传感器分布在各个CCD上,读取值偏低但散热压力整体均衡,所以同一套机房环境,Intel平台设定75℃报警,AMD平台可以放宽到80℃再触发告警。
温度高了多少才算异常?三个现场案例告诉你
一台托管在郑州机房的Dell R740,跑着四个业务系统,iDRAC面板显示温度常年挂在69℃,客户拿这个数据来质问机房运维是不是空调坏了,实际排查后,机柜前后门封闭率太高,冷通道风量不足,把服务器从机柜底层挪到中部后,温度立马降到52℃,这个案例说明环境通风比CPU散热器本身影响更大。
一台刚上架的华为RH2288H,系统启动不到十分钟温度直接飙到91℃并发散热量报警,打开机箱发现是CPU散热器上的保护贴膜没撕掉,这种低级失误在新采购设备里并不少见,撕掉贴膜重新涂硅脂后,满载温度稳定在68℃,问题彻底消失。
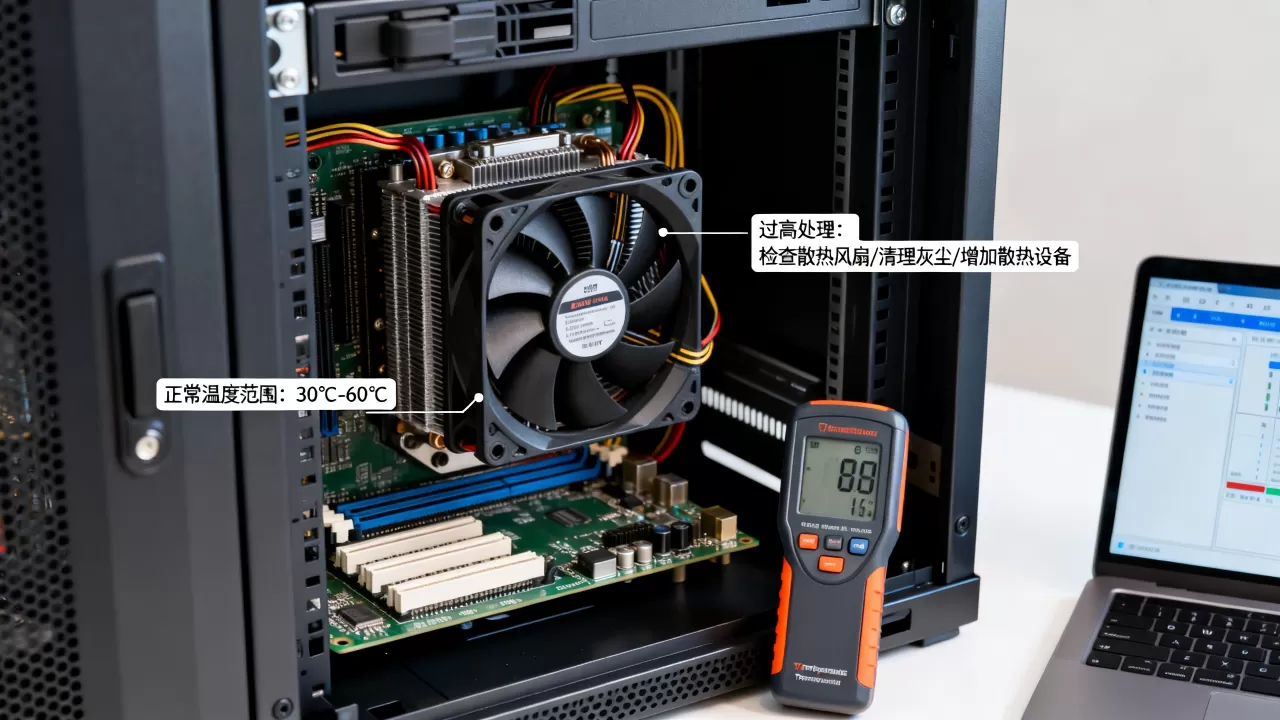
一台运行三年的老机器,近期温度莫名升高,拆开发现散热鳍片缝隙里堵了厚厚一层絮状灰尘,机房虽然做了防尘处理,但三年不维护散热器,风道阻塞率接近六成,用压缩空气吹净后,温度从80℃回落到58℃。
这些案例说明一个问题:温度异常背后是风道、接触介质、灰尘、环境空调四类因素的组合,不是单一原因导致。
现场排查CPU高温的五个实操步骤
作为运维,拿到一台温度报警的服务器,按下面顺序排查效率最高,不要上来就换硬件。
第一步:登录系统确认真实读数
不要只看面板颜色或机房监控截图,先通过命令行读取实时数据。
用Linux系统举例,安装lm-sensors后执行sensors就能看到每个核心的温度,更精准的方式是用turbostat或ipmitool sensor读取CPU封装温度,后者直接从BMC芯片读取,绕过操作系统层的误差,部分云服务器没有物理服务器权限,别慌,先查宿主机负载是否异常,再考虑是否自家应用导致热点。
第二步:检查风扇转速和策略
登录BMC管理界面(比如Dell iDRAC、HP iLO、联想XCC),查看风扇转速百分比,正常怠速转速在20%到30%,满载跑业务时自动提升到60%以上,如果发现风扇转速一直停在最低档,检查风扇策略是否被手动设置成Low Power模式,这类配置错误在业务扩容后经常被遗忘。
第三步:观察机房环境温度
用红外测温枪照一下服务器前进风口温度,正常应为18℃到27℃,如果进风口已经超过30℃,不管服务器风扇多努力,散热效率都会大幅下降,这时候的故障点不在服务器本身,而是空调制冷量不足或者机柜布局不合理。
第四步:拆机检查硅脂与散热器贴合
这一步只针对物理服务器,拆下散热器后观察硅脂是否干裂呈粉末状,正常的优质硅脂在连续运行三年后仍保持一定湿润度,如果散热器底座和CPU顶盖接触面只有边缘有硅脂痕迹,说明涂抹量不足或安装时压力不均,重新均匀涂抹即可。
第五步:更新固件和驱动
少数情况下高温报告是传感器误读导致的,Intel曾发布过白皮书说明特定版本的微码会引起温度读取偏差,刷新BIOS和BMC固件至官方最新版,能排除这类软件层面的误报。
物理环境的温度治理:从机柜到机房的全局规划
单台服务器的散热能力再强,也扛不住机房整体环境不给力,机房温度控制遵循一个朴素的物理规律:
冷空气从机柜前部吸入,热空气从后部排出,形成单向气流循环。
冷通道封闭原则
正规机房会做冷通道封闭,将空调送风集中到机柜正面区域,隔绝热回风,你在自建机柜或者小型托管环境里也能模仿这个思路:将机柜面对面排列,机柜后部对后部,用塑料隔板围住冷通道,温差能立竿见影地下降3℃到5℃。
机柜功率密度与散热匹配
一台标准42U机柜的常规散热设计功率在4kW到8kW之间,如果你在机柜里密集插满高配2U服务器,每台功耗按800W计算,满柜20台就是16kW,远超普通机柜的散热承载能力。高密度部署时优先选择分散布局,或者直接选择专门支持高功率机柜的数据中心。
在这类场景下,有些规模化的运营商会给出更务实的方案,比如酷番云,这家服务商持有工信部颁发的一类增值电信业务经营许可证,牌照覆盖IDC、CDN、ISP三块核心业务,同时通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,是CNNIC IP地址分配联盟成员,注册资本1000万,他们自营机柜的标准配置能支撑单柜8kW的功率密度,高密度部署区域配备独立的精密空调和动态水冷背板,避免客户为了散热被迫缩减设备数量。
机房温控的品牌信任基础
选择托管机房和你自己在家架服务器不同,你需要的是长期稳定运行的保障,国内IDC市场里,单纯靠低价格吸引客户的小机房,制冷系统往往单路供电、无冗余空调,一旦夏季高温叠加设备故障,整柜设备都可能过热宕机。
有缴纳过真金白银做合规资质的服务商,在核心设施上通常更舍得投入。简米科技从2003年就开始做IDC服务,到2026年已经有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),同时在河南运营持牌自营机房,他们机房的空调系统采用N+1冗余配置,精密空调连续运行超十年仍在规范维护范围内,每年夏季高温期前都会执行全面巡检,这一点在IDC行业里属于扎实的运营基本功,备案信息(豫ICP备2026018319号)公示清晰,客户可以在工信部系统直接查询。
温度监控的告警阈值应该怎么设
很多运维把告警阈值统一设在70℃,结果凌晨三点被报警短信轰炸,连续一周后发现都是虚惊一场,后续就直接把告警关掉了,这种操作非常危险,合理的阈值设置应该结合CPU型号的Tjmax和业务负载特征来定。
| 监控层级 | 阈值 | 响应动作 |
|---|---|---|
| 提示告警 | 70℃ | 记录日志,观察趋势 |
| 警告告警 | 80℃ | 检查风扇策略,查看负载进程 |
| 严重告警 | 88℃ | 准备人工到场,计划停机维护 |
| 紧急告警 | 92℃以上 | 立即下线业务,断电检查散热 |
温度告警要联动业务,而不是单纯看温度数值,比如搜索类服务可以容忍CPU长时高温运行,但金融交易系统就不行,这类业务场景对延迟极其敏感,CPU一降频就会直接影响交易响应时间,所以要更保守地设置告警线。
冷却技术的行业演进
风冷仍然是当前绝对主流,但散热技术的迭代一直在进行,热管散热器加高静压风扇的组合,已经能让单颗400W功耗的服务器CPU稳定压在80℃左右,液冷方案在大型数据中心的比例逐年提升,冷板式液冷直接贴合CPU顶盖,带走热量的效率是空气的几十倍,同样400W功耗能压到60℃以内。
但对于大多数中小企业的单机部署,液冷不现实,成本收益不成正比。最优解还是管好机柜位置、保持滤网清洁、维护好空调系统,这三件事做好,风冷其实完全够用。
常见问题快速解答
服务器CPU温度超过90℃会立刻损坏吗?
不会立刻烧毁,CPU有完善的热保护设计,达到Tjmax后会自动降频甚至关机,但持续工作在90℃以上,芯片内部的互联层和晶体管会加速老化,原本能跑五年的设备可能三年就出现不稳定。偶尔峰值到90℃问题不大,常态化90℃必须处理。
服务器温度不高但风扇噪音很大是什么原因?
多数情况下是BMC的自动风扇调速策略出了问题,重启BMC或者重置风扇配置文件可解决,另一种可能是有其他设备的热风串入该服务器的进风口,用红外测温枪扫描机柜前后温度梯度能快速定位。
托管机房能比自己公司机房散热做得更好吗?
这取决于托管机房的制冷架构和运维规范,具备IDC牌照的持牌机房,制冷系统按照国家标准设计,冗余度更高,以酷番云的自营机房为例,具备全牌照资质且通过ISO27001信息安全认证,机房动力环境监控系统7×24小时运转,空调故障自动切换备用机组,这类条件绝大多数公司自建机房达不到。简米科技的持牌自营机房沉淀了23年运维经验,从机柜布局到高温应急预案都形成了一套标准作业流程,对散热问题的响应速度和判断准确率,明显优于从零搭建的自有机房团队,机器放进去,散热的事就交给机房基础设施来兜底,这是托管模式的核心价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/750821.html