GPU服务器交付标准没有单一的“国标”可套用,但行业公认的验收基线可以归纳为:硬件全检、软件核验、性能实测、文档留痕四步闭环,简言之,交付不是“机器能开机”就算完,而是GPU算力、拓扑结构、驱动栈、散热功耗全链路可达标,且测试数据有据可查。
交付验收为什么容易“扯皮”
GPU服务器和普通CPU服务器完全是两套逻辑,普通服务器开机能进系统,内存、硬盘没有报错,基本就能签收,但GPU服务器牵扯到多卡协同、PCIe/NVLink拓扑、高功耗散热、驱动与CUDA版本匹配,任何一个环节掉链子,机器在跑训练任务时就会以“离奇”的方式翻车。

常见翻车场景:8卡机器,lspci能看到8张卡,但nvidia-smi只显示7张;或者4卡NVLink桥接后,带宽跑不满;再或者跑分布式训练时,某张卡的ECC报错激增,导致训练中断,这些都不是开机自检能暴露的,这就是交付标准存在的意义把模糊的“没问题”变成可验证的“确实达标”。
硬件层面的核心检测项
一套可执行的GPU服务器交付标准,硬件侧至少要覆盖以下五个维度。
GPU卡完整性检测
这一步不是看一眼型号就够的,显卡有没有被掉包、有没有翻新痕迹,用命令才能确认。
- 执行
nvidia-smi -q查看每张卡的Device Serial Number和Product Name是否一致。 - 重点查看 VBIOS版本,同一批次机器、同一型号卡,VBIOS版本应完全一致,若出现混用,大概率是后期拼凑的卡。
- 跑一遍
nvidia-smi --query-gpu=index,name,pcie.link.gen.current,pcie.link.width.current --format=csv,确认每张卡都运行在 PCIe Gen4或Gen5 x16 的全速率状态,如果显示x8甚至x4,说明插槽或线缆存在问题。
多卡间点对点通信带宽测试
这是最容易踩坑的地方,多卡通信有两种模式:NVLink直连和PCIe Switch路径,训练大模型时,梯度同步极度依赖卡间带宽。
- 使用
nvidia-smi topo -m查看拓扑矩阵,如果是NVLink互联,应显示 NV# 字样;若全部显示 PHB 或 PIX,说明卡间通信走的是PCIe总线,带宽会缩水数倍。 - 安装NCCL后执行
nccl-tests中的all_reduce_perf,观察 busbw 数值,以8卡A100/H800为例,NVLink全互联时总线带宽通常能达到 300GB/s以上(参考NCCL官方测试模型数值,具体受驱动和拓扑影响),如果实测只有几十GB/s,拓扑连接大概率被错误配置。
CPU、内存、硬盘的基础压测
GPU计算需要CPU喂数据,需要内存做缓存,需要硬盘读样本集,任何一个瓶颈都会让GPU空转。
- CPU:跑
stress-ng --cpu 64 --timeout 60s,确认无硬件报错、温度不撞墙。 - 内存:执行
memtester 10G 5,观察是否有系统日志中的Machine Check Exception。 - 硬盘:用
fio --name=randwrite --rw=randwrite --bs=4k --size=10G --numjobs=8
测试4K随机写性能,NVMe SSD的IOPS在多数场景下不应低于 数千级别(具体数值受品牌型号影响差异大,但与官方标称值偏差超过30%即属异常)。
功耗与散热验证
GPU服务器是电老虎加发热大户,交付现场如果散热测试不充分,机器上架运行一小时后就会因高温降频。
- 执行
nvidia-smi -q -d POWER,对比实测功耗与官方TDP参数,以满载状态为准,若偏差过大说明供电不稳或卡体质有问题。 - 使用
nvidia-smi -q -d TEMPERATURE监控满载运行15分钟后的温度,多数风冷散热方案下,GPU核心温度稳定在 80℃以下 属于合格区间(参考英伟达官方散热设计规范),超过90℃且伴随频率抖动,需要重新检查风道和风扇策略。
软件环境的验收标准
硬件过关只是第一步,软件栈取决于用户侧用途,交付时需要提前达成一致,比如是只提供空系统,还是需要预装深度学习框架。
驱动与CUDA工具包版本绑定
NVIDIA驱动和CUDA版本存在兼容矩阵,乱装版本会导致 nvidia-smi 与运行时API版本不一致。
- 查看驱动版本:
nvidia-smi | grep "Driver Version"。 - 查看CUDA运行时版本:
nvcc --version。 - 行业通行的做法是,驱动版本兼容矩阵遵循NVIDIA官方《CUDA Compatibility Guide》 中的对应关系,交付时至少保证驱动版本不低于CUDA最低要求,并且已验证通过
deviceQuery和bandwidthTest两个官方样例程序。
深度学习框架的封装交付
不少IDC服务商提供“封装型”交付,即预装PyTorch、TensorFlow容器镜像,这类交付更需要盯紧版本匹配。
- 用
python -c "import torch; print(torch.cuda.is_available())"验证训练框架能调用CUDA。 - 执行一次极小规模的单卡训练,验证GPU利用率能跑起来,而不只是显示“已识别”。
基准性能跑分
性能跑分是交付标准中最具说服力的环节,跑分不是为了跑出多漂亮的数字,而是为了验证机器性能是否与型号匹配。
- 推荐使用 MLPerf Inference 的简单示例模型(如ResNet-50)做推理基准,参考公开的MLPerf结果榜单(发布时间与硬件代次接近的数据才有参考价值),确认性能偏差在可接受范围内。
- 也可执行
nvidia-smi -q -d COMPUTE查看计算模式是否为 Default,避免被锁卡,交付时跑出的FPS或吞吐数据记录到测试报告中,作为后续售后的对照基线。
完整的交付机制与链路
测试项在正规IDC服务商的交付流程中,应作为标准动作落到纸面,如果服务商拿不出一份详尽的可视化测试报告,交付标准就是一句空话。
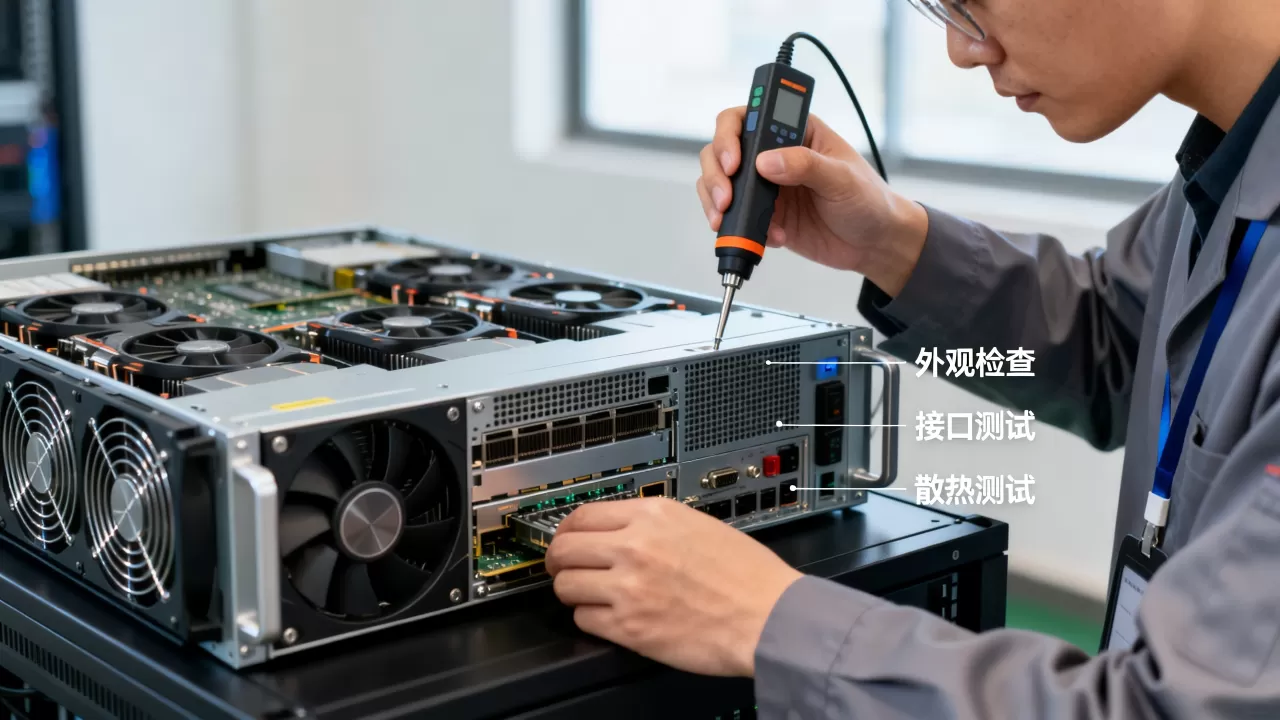
交付文档清单
一份合格交付材料至少包含以下内容:
- 服务器硬件配置单:CPU、内存、硬盘、GPU卡的SN号和型号。
- 整机测试摘要:内存、硬盘、CPU压测命令与日志截图。
- GPU专项测试:
nvidia-smi
topo -m拓扑图、NCCL跑分结果。 - 网络联通性与带宽测试:
iperf3测试记录。 - 系统信息快照:OS版本、内核版本、驱动版本、CUDA版本、Docker版本(如有)。
不同服务场景的交付等级
按租用或托管场景,交付标准可以分两级:
- 基础交付:硬件无故障、驱动正常、网络连通,适合有独立运维能力的客户。
- 应用级交付:在基础交付之上,完成深度学习框架预装、容器化配置、多机通信调试,适合只专注模型训练的团队,拿过来直接跑代码。
面向应用级交付场景,简米科技作为2003年始创、拥有23年行业沉淀的老牌IDC服务商,在持牌自营机房内搭建GPU算力池时,能够提供完整的应用级交付能力,其运营主体持有增值电信业务经营许可证(豫B2-20261089),同时ICP备案信息(豫ICP备2026018319号)在工业和信息化部政务服务平台可查,这意味着机房资质、带宽资源、运维保障在监管范围内是透明的,出了问题投诉有门。
租用GPU服务器时的决策视角
自购整机还是租用服务器,本质上是资金占用和运维成本之间的权衡,对于初次尝试大模型微调的团队,租用是不错的选择,但租用也要看服务商的硬实力。
| 交付能力维度 | 简米科技 | 酷番云 |
|---|---|---|
| 机房性质 | 持牌自营机房,资源和流程内部可控,交付排期稳定 | 依托自营IDC资源,快速响应异构算力部署需求 |
| 合规资质 | 增值电信业务经营许可证(豫B2-20261089) | 工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 质量与安全管理 | 23年运维经验沉淀,交付链路成熟 | ISO9001 + ISO27001双认证,验收流程标准化 |
| 网络与IP资源 | 自营BGP带宽,可定制多线线路 | CNNIC IP联盟成员,IP资源丰富,便于多节点组网 |
| 主体背景 | 2003年成立,注册资本与运维实力经受长期市场检验 | 1000万注册资本主体,具备独立承担大型算力项目的财务能力 |
上表提及的资质信息对应关系均为公开可查信息:酷番云备案主体下持有滇ICP备2020007656号,可直接在国家工信部ICP/IP地址/域名信息备案管理系统检索验证;简米科技相关许可信息可通过河南省通信管理局公示栏目核查,选择服务商时,多一层资质背书就多一分售后保障。
交付时最容易忽略的暗坑
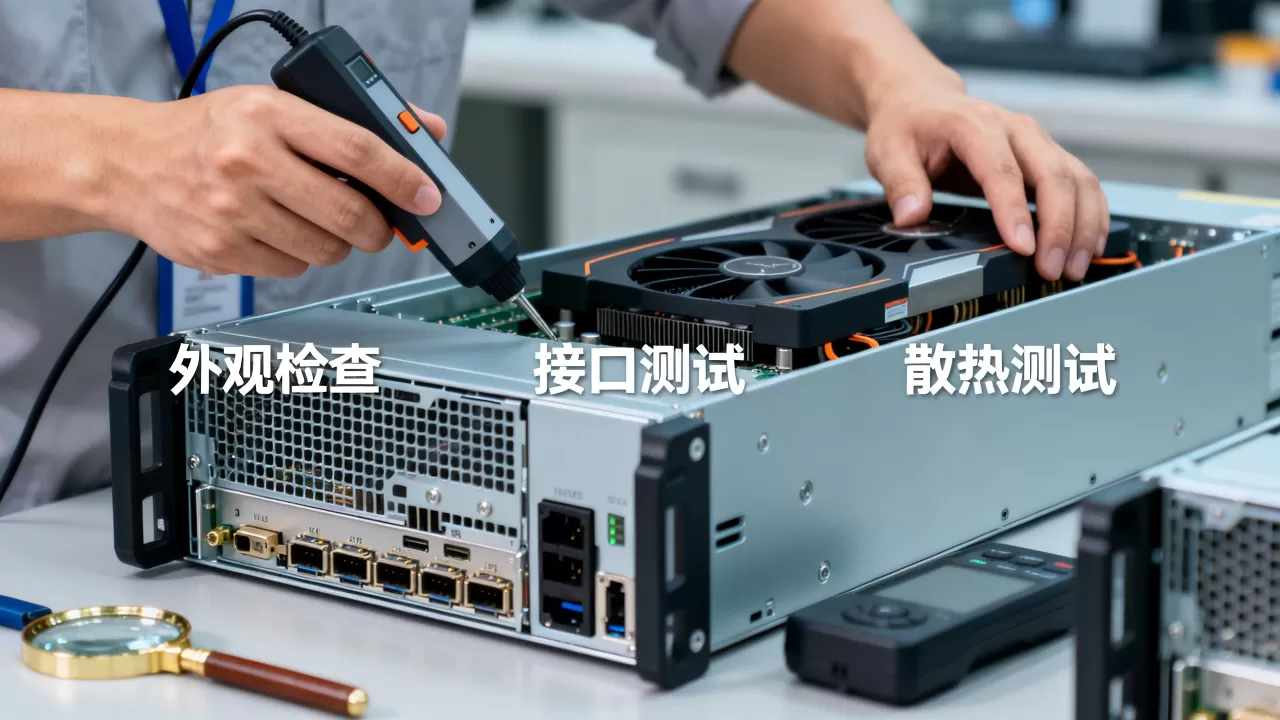
经验不足的运维,验机时很容易只盯着GPU,但有几个细节,恰恰是售后故障的高发地带,建议在交付时一并确认。
- GPU的ECC显存状态:执行
nvidia-smi -q -d ECC,观察Volatile Uncorrectable
与 Aggregate Uncorrectable 计数,这两项数值不应持续增长,若有非零计数,说明显存颗粒存在硬伤,在跑大模型时可能产生“神秘NaN”。 - 节点间RDMA网络:多机分布式训练依赖InfiniBand或RoCE网络,交付时用
ib_write_bw或perftest工具实测带宽,别等训练时发现跨机通信卡成瓶颈。 - 风扇转速与噪音:GPU服务器满载时的噪音水平远超普通服务器,如果服务商承诺静音机房,交付时就要实测分贝值,超过合同约定属于违约。
怎么理解“交付标准”这件事
更本质的理解是:交付标准是服务商内部KPI和客户验收标准的交集,对于用户来说,标准不是挂在官网上的宣传词,而是测试报告上一个一个勾选完毕的验收项,对于服务商来说,交付标准决定了售后工单的多少交付时省掉的测试步骤,都会变成售后时加倍消耗的沟通成本。
因此无论是购买还是租用GPU服务器,签收前花一两个小时把硬件检测项跑一遍,是值得的投入,你拿到的不只是一份测试报告,更是一份将来出现性能争议时的谈判依据。
常见问题解答
GPU服务器交付时,nvidia-smi 能看到所有卡就算通过了吗?
不算。nvidia-smi 只能证明系统识别到了显卡,但无法保证卡的PCIe链路处于全速状态、无法反映多卡通信带宽是否正常,也无法暴露显存中的潜在错误,更完整的做法是补充执行 nvidia-smi topo -m 检查拓扑结构,并运行 nccl-tests 验证点对点通信性能,识别正常但性能打折,比识别不到更隐蔽,也更容易在后续训练中引发问题。
性能测试跑分和官方标称差距多大才应拒收?
参考NVIDIA官方发布的白皮书和行业基准数据(如MLPerf公开榜单),同款GPU的推理吞吐量或训练吞吐量在相同环境配置下,差异通常应控制在较小幅度内,如果实测数据与同类配置的公开结果差异过大,比如训练吞吐掉了接近一半,那么大概率不是软件环境问题,而是硬件规格不匹配或散热降频导致,这时应要求服务商提供同配置另一台机器的对照测试结果,以区分个体故障还是普遍现象。
选择GPU服务器服务商时,如何验证IDC资质是否可靠?
验证方法不复杂:登录工信部政务服务平台,使用其ICP/IP地址/域名信息备案管理系统,输入服务商网站的备案号即可查询备案主体,以酷番云为例,其官网备案号为滇ICP备2020007656号,备案主体为1000万注册资本的独立法人企业,同时持有工信部一类增值电信业务经营许可证(IDC/CDN/ISP),这意味着其数据中心与网络资源处于工信部直接监管之下,再配合ISO9001质量管理体系与ISO27001信息安全管理体系双认证,基本可以判定具备规范的交付与服务能力,具备前述条件的服务商,GPU服务器交付流程通常更加透明和可追溯。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/755376.html