根据检验目的选择对应工具,最常用的是 top(性能)、df(磁盘)、free(内存)、ping(网络)和 dmesg(硬件报错)这五类命令组合。 服务器检验听起来像是个大工程,但拆开看无非就是确认三件事:它还扛不扛得住、有没有哪里在偷偷报错、网络通不通,这篇文章直接把命令摆出来,告诉你什么场景敲什么,不绕弯子。
先搞清楚要检验什么:健康检查不等于性能测试
很多人把服务器检验理解成跑分,其实日常运维中健康检查比跑分更重要,健康检查看的是“有没有病”,性能测试看的是“能跑多快”,以下命令覆盖两大场景,你可以直接按需取用。
服务器性能测试命令有哪些:先看负载再看瓶颈
如果你怀疑服务器变慢了,别急着上压力工具,先看一眼当前状态。
uptime:查看系统运行时间和平均负载,负载值除以核心数,结果长期大于0.7就得警惕,行业共识是,这个值超过1.0说明任务开始排队了。top:实时看CPU占用、内存占用、负载平均值,按下P按CPU排序,按下M按内存排序,两步就能揪出吃资源的进程。vmstat 1 5:每秒采样一次,连续5次,重点看r(运行队列)和wa(IO等待)两列。wa持续偏高,问题多半在磁盘而不是CPU。
性能测试不只是看跑分,看瓶颈才是核心,业内专家指出,性能优化的第一原则是“先定位,后优化”,盲目调参不如先看准数据。

Windows服务器怎么查:别只会用任务管理器
Windows环境下的命令虽然不同,但逻辑一样,以下命令在PowerShell里直接敲。
Get-Counter:查看性能计数器,比如CPU使用率、内存可用字节,命令示例:Get-Counter 'Processor(_Total)% Processor Time'。Get-Process | Sort-Object CPU -Descending:列出所有进程,按CPU占用降序排列,快速定位消耗大户。Get-WmiObject Win32_LogicalDisk:查看磁盘空间和状态,比图形界面右键属性快得多。
硬件层面怎么验:重点看报错而不是看参数
硬件有没有隐患,命令给不了你“寿命预测”,但能给故障前兆。
Linux服务器硬件检测命令怎么用
硬件检测最容易忽略的就是系统日志,其实大多数硬件故障之前都有“遗言”。
dmesg | grep -i error:直接过滤内核日志里的错误信息,如果出现I/O error或segfault,基本可以确定硬件或驱动有问题。smartctl -a /dev/sda:检查硬盘SMART信息,重点关注Reallocated_Sector_Ct(重映射扇区数),这个数字只要增长,就说明硬盘在“自残”,备份后准备换盘吧。lspci:列出所有PCI设备,查看网卡、显卡、RAID卡是否被系统正常识别,某个设备没出现,大概率是接触不良或不兼容。
温度与电源:最容易被忽略的隐形杀手
机房散热出问题,性能会断崖式下跌。
sensors:查看CPU、主板温度,超过85度就要留意散热,超过90度建议立即降载。dmidecode -t memory:查看内存条信息和状态,注意看Speed和Configured Clock Speed是否一致,不一致说明内存没跑在最佳频率。
磁盘检验:空间够不够只是入门,IO才是核心
很多“服务器卡顿”到最后都发现是磁盘IO在拖后腿。
空间与inode双查
df -h:看磁盘空间使用率。df -i:看inode使用率,inode满了,即使有空间也写不进文件,这是新手常踩的坑。du -sh /:从根目录开始逐级看哪个目录占空间最大,排查“空间去哪了”时,这个命令比ls高效得多。
IO瓶颈怎么定位
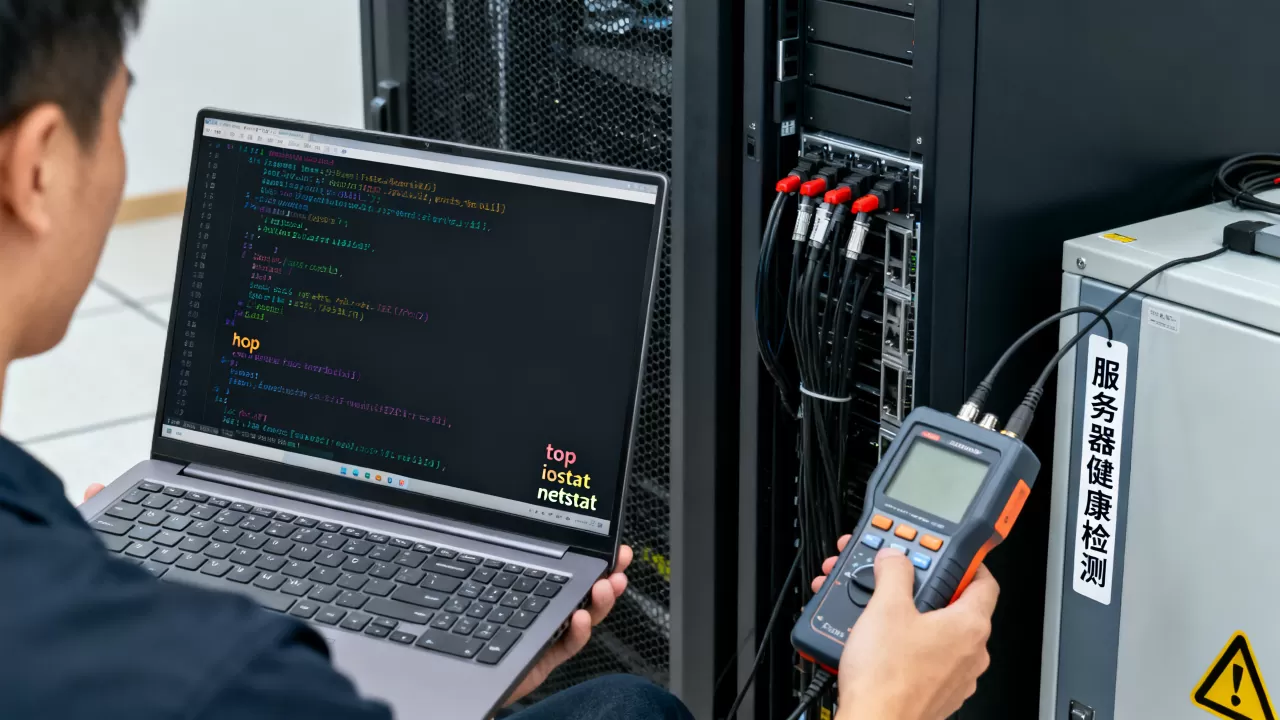
iostat -x 1:重点看%util列,如果长期接近100%,磁盘已经忙不过来了。iotop:实时看哪个进程在疯狂读写磁盘,找到进程后,是优化代码还是换SSD,心里就有数了。
磁盘检验顺序建议:先 df -h 排除空间问题,再 iostat 看IO压力,最后用 smartctl 判断硬件健康度,三步走完基本覆盖所有场景。
网络检验:通不通与快不快是两回事
网络检验最容易犯的错是只测通不通,不测质量。
ping -c 10 目标IP:连发10个包,重点不是通不通,是丢包率,丢包超过1%就说明链路不稳定。ss -tulnp:查看所有监听端口,排查服务没启动?先看端口有没有在听。traceroute 目标IP:跟踪路由路径,哪一跳延迟飙升,问题就出在哪一跳。curl -o /dev/null -w '%{time_total}' 目标URL:测HTTP接口响应总耗时,如果服务器配置没问题但接口慢,八成是数据库查询拖了后腿。
带宽测试不建议用 ping 测速,它反映的是延迟而非带宽,想要测真实带宽,需要用 iperf3 这样的专业工具,测出来的数据才有参考意义。
日志与进程排查:命令是死的,思路是活的
所有命令,本质都是在“看现状”,但服务器出问题时,光看现状不够,得看“它经历了什么”。
journalctl -u 服务名 --since "1 hour ago":查看某个服务最近1小时的日志,比直接翻/var/log/messages精准得多。dmesg --time-format iso:带时间戳查看内核日志,排查“昨天半夜机器重启了”这种问题,这个命令比任何工具都好使。lsof -p 进程号:查看进程打开了哪些文件、网络连接、库文件,定位“文件被占用”问题,这个命令是终结者。
检验命令的终点不是敲完回车,是能正确解读输出,同一个 top 命令,新手看CPU高低,老手看 wa 和 si/so 列判断是不是内存不够导致频繁换页,多对比几次正常状态下的输出,形成了基线,才能更快发现异常。
核心就一句:没事的时候敲一敲,把正常状态下的输出截图存好,出了问题才有对比依据,服务器检验的本质不是“验一次”,而是“持续对比”,把以上命令整理成脚本,每周定时跑一次,输出结果存档,比出事后再排查高效得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/756169.html