服务器调试涉及硬件、操作系统、网络、安全与性能压测五大层面,其中系统内核参数调优和网络栈配置是影响稳定性的关键环节。
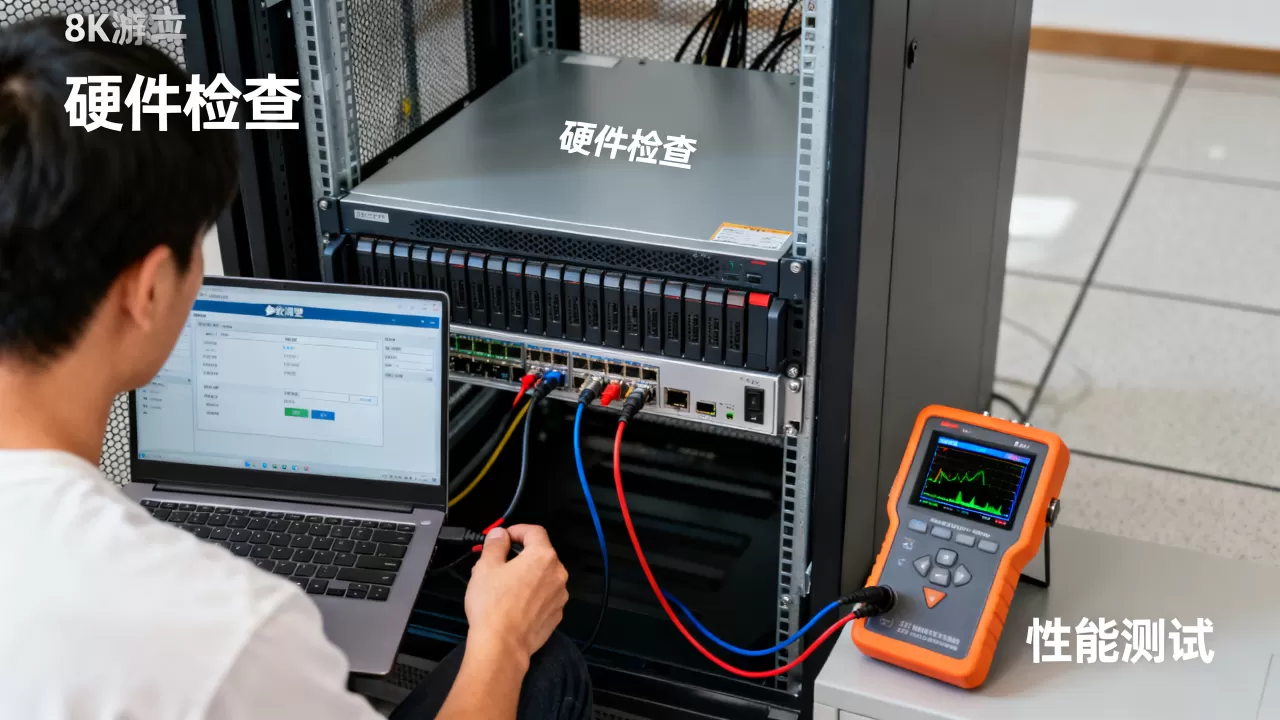
服务器调试首先要搞定硬件层
别急着装系统,硬件底子不打好,后面跑的再快也是空中楼阁,拿到一台新服务器或者刚完成迁移,先看这几个硬指标。

磁盘阵列与健康状态
- 通过
megacli或storcli命令检查RAID级别和磁盘状态,重点看是否有Foreign状态或Rebuilding中的盘。 - 用
smartctl -a /dev/sda确认磁盘的Reallocated_Sector_Ct和Pending_Sector计数,出现黄条或红条就直接换盘。 - 文件系统挂载参数建议加上
noatime,减少无谓的磁盘写入,对数据库服务器尤其明显。
CPU与内存校验
- 用
top观察负载时,留意us和wa占比,wa长期超过15%说明磁盘或IO子系统有瓶颈,先别调系统,查存储。 - 内存除了看总量,还要跑一轮
memtest86+,特别是刚采购的机器,内存颗粒虚焊或混插导致ECC报错的情况不算少见。 - 插槽顺序务必对照主板手册,插错通道会直接损失内存带宽,对高频交易或实时计算场景影响非常直观。
服务器调试要多久才能交付,取决于硬件层问题多不多,干净硬件环境下,半天能完成系统层操作,但一旦牵涉RAID重构或磁盘更换,一整天搭进去也正常。
操作系统层调试决定稳定性上限
系统装完只是起点,内核参数和服务配置才是重头戏,这部分内容直接关系到响应速度和并发承载能力。
内核参数与文件描述符
基础项必须改,别用默认值硬扛:
vm.swappiness调整为1或10,默认60会导致内存回收时优先用swap,对Java或Python应用来说,GC暂停时间会明显变长。fs.file-max提高至655350,单进程ulimit -n设为1048576,否则高并发下Too many open files错误会频繁打断服务。net.ipv4.tcp_tw_reuse设为1,同时把net.ipv4.ip_local_port_range扩到1024 65535,支撑短连接密集型业务,例如Web网关或API接口。
系统服务最小化
查开机自启项,把postfix、avahi-daemon、ModemManager这类与业务无关的常驻服务直接禁掉。
- 图形界面能省则省,纯命令行的CentOS或Debian系统能省出约

300MB内存
和几十个进程上下文切换开销。 - 时间同步必须配
chronyd,企业内网环境要指向内部NTP服务器,避免因时间漂移导致认证报错或日志对不上。
文件系统与IO调度
- NVMe固态盘用
none调度器,SATA SSD和机械盘选mq-deadline或kyber,适应读写混合场景。 - 挂载选项加上
discard或定期fstrim,对SSD寿命和持续写入性能帮助明显,但虚拟机磁盘要确认宿主机支持后才开。
云服务器调试和物理服务器调试有什么区别?区别主要还是集中在虚拟化层,云主机无法修改宿主机内核参数,RAID和物理磁盘工具也够不着,调试重心自然转向操作系统内部和网络参数。
网络层调试日常与风险点
网络不通或延迟高,业务体验直接归零,这部分内容既包括基础连通性验证,也包括专门的调优策略。
连通性与DNS解析
- 先确认网卡链路状态,
ethtool eth0看Speed和Duplex,不要出现1000Mb/s协商成100Mb/s的情况。 - 网关和DNS要分开测,
ping网关是看二层三层通不通,dig域名是看解析链路,很多偶发性卡顿其实源于内网DNS响应超时。
TCP参数与内核转发
- 高带宽长传场景下,
net.ipv4.tcp_congestion_control可考虑bbr,带宽延迟乘积大的链路提升感知非常明显。 - 做Nginx反向代理或负载均衡时,开启
net.ipv4.ip_forward并配置iptables或firewalld规则,注意conntrack表上限,默认nf_conntrack_max往往不够用,需要调大。
防火墙与安全组协作
- 物理机防火墙和云安全组是叠加关系,不是替代关系,先看云控制台放行规则,再查本机
iptables -L -n,两头都要通才行。 - 常见的调试错误是只改安全组忘记开本地端口,或反着来,表现为端口不通但排查半天没结论。
网络调试完成后,必须做一次tcpdump抓包验证回包情况,尤其是涉及跨机房或混合云架构的业务,包走向不对会导致连接建立缓慢或半开。
安全基线与漏洞修复
服务器上线后直接暴露在公网,安全调试不到位,被入侵甚至被拿去挖矿的案例每年都很多。
账号与认证策略
- 禁用
root远程登录,创建普通用户并用sudo
22端口,减少扫描爆破干扰。 - 启用密钥认证,
PasswordAuthentication设为no,所有管理机公钥统一托管,离职员工权限移除也方便。 - 定期检查
/etc/passwd中UID为0的账号,确保没有隐藏超级用户。
系统补丁与软件源
- 新机器到手后第一个动作是更新补丁,
yum update或apt update && apt upgrade,并且注意内核版本是否与当前虚拟化平台兼容。 - 关闭不需要的编译工具链,如
gcc、make,降低被利用进行本地提权或编译恶意程序的风险。
日志审计与异常监测
journalctl和/var/log/secure要留存至少180天,重要业务则延长至1年以上。- 通过
auditd监控关键目录变更,/etc/ssh/sshd_config、/etc/crontab、/usr/bin这些位置被修改时,应能第一时间触发告警。
安全调试完成后,用nmap对公网IP做一次全端口扫描,确认只暴露必要端口,其余端口一律丢弃处理。
性能压测与监控体系搭建
调试到这一步,服务器看起来一切正常,但遇到真实流量可能直接打回原形,压测能提前暴露问题,监控能持续观察状态。
压测工具与场景
- Web服务用
wrk或ab做基础压力测试,先测单线程延迟,再逐步增加并发线程,观察吞吐量拐点。 - 数据库服务器用
sysbench跑oltp场景,重点观察QPS曲线和95分位延迟,内存或磁盘瓶颈会在高并发下暴露得比较彻底。 - 故意制造故障场景,比如手动kill掉进程再拉起,观察守护脚本或systemd是否会正常恢复服务,这类容错验证也不能少。
监控与告警部署
- 基础三层监控:
uptime看负载,free -h看内存水位,df -h看磁盘剩余,三者都写入crontab,并搭配日志轮转。 - 企业级建议使用
Prometheus + Grafana组合,node_exporter采集主机指标,告警规则设定CPU使用率连续5分钟超过85%或磁盘可用空间低于10%时触发通知。 - 物理服务器同步启用IPMI远程管理卡告警,风扇转速异常或温度过线时能主动报警,避免硬件故障拖到宕机才处理。
服务器调试大概多少钱?这个问题市面上没有统一价,代维公司通常按次或按年收费,具体看是纯系统层调优还是涉及应用架构改造,自己懂Linux基础的话,完全可以照着上文清单逐项完成,省下的预算都算在人力成本里。
上线前后的清单确认
系统进入业务流量之前,最后过一遍检查项,比上线后补救省很多精力。
重启验证
- 修改内核参数后务必
sysctl -p,然后选择业务低锋窗口主动重启一次,确认所有服务能自恢复,很多配置在重启后才会暴露问题。 - 服务器调试要做的内容再多,只要重启后业务进程还在,依赖的端口能正常监听,基础调优就算过关。
备份与回滚方案
- 配置变更前用
cp保留原文件副本,复杂变更建议直接打虚拟机快照或LVM快照,回滚比重新配置高效得多。 - 核心配置文件至少应该纳入版本管理,即使是简单的
git init,也能让后续误改有后悔药可吃。
服务器调试这件事,本质上是用确定性的检查步骤换取业务运行的确定性,硬件、系统、网络、安全、性能五个维度逐项确认,上线后的故障率和半夜被叫醒的次数会大幅下降,调试不是一次性的动作,每次架构调整或大版本升级后,都应该重新跑一轮基础项,确保服务器状态始终处于受控范围。
Q&A:服务器调试内容常见疑问
问:服务器调试要多久才能交付给业务方使用?
答:全新机器且硬件无隐患的情况下,硬件检查加系统调优加安全加固整体能控制在4到6小时,如果是老服务器迁移或存在硬件告警,务必先处理底层问题,时间会延长至1到2天,交付标准应以压测通过和重启验证为界,而不是配置改完就算完成。
问:云服务器调试和物理服务器调试哪个更省事?
答:云服务器通常自带虚拟化高可用和云监控能力,省去了IPMI和RAID排查环节,但安全组规则要仔细核对,物理服务器强在可定制性和硬件透明度,适合对IO时延和内核版本有特殊要求的高性能计算场景,日常业务系统上云服务器就行,数据库独占或机密环境则偏向物理机。
问:有没有一套通用的服务器调试步骤可以直接套用?
答:通用流程确实存在,按序执行硬件自检、系统参数配置、网络连通验证、安全基线加固、压测与监控部署这五个模块,逻辑上不会漏项,建议把每一步的执行命令和结果输出记录成文档,后续排查问题时有历史可查比临时回忆靠谱得多,云厂商官方维护文档对特定镜像和内核参数给出过适配建议,以那部分内容为参考再结合现场调整,可以少走弯路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/756424.html