查看Linux服务器GPU使用情况,最直接、通用的方法是在终端执行nvidia-smi命令,它实时输出显存占用、GPU利用率、温度、功耗等核心指标。 理解这张“体检报告”的输出逻辑,再搭配gpustat等增强工具,就能应对从单卡状态确认到多卡训练调优的全部日常场景。
linux查看gpu使用情况命令:先学会读懂nvidia-smi原始输出
执行nvidia-smi后,屏幕上会出现两大部分:上方是GPU基本信息,下方是运行中的进程列表,刚开始接触的朋友常被满屏数字吓到,其实拆开看,每块GPU的信息就六个关键栏位。

GPU利用率与显存占用要分开看
- GPU-Util:代表计算单元繁忙程度的百分比,100%表示计算核心被塞满,但要注意,这个数值反映的是采样瞬间的占用率,会频繁跳动。
- Memory-Usage:显示为
已用显存 / 总显存,比如5120MiB / 12288MiB,显存吃紧但利用率低,通常意味着数据加载或预处理环节存在瓶颈。
这两者没有必然的线性关系,模型推理服务常表现为GPU利用率低但显存占用高,这是正常的;而训练任务如果出现利用率高但显存长期不变,则需要进一步观察是否真在计算。
温度、功耗和风扇转速的联动判断
- Temp:核心温度,通常以摄氏度显示,长期超过85°C需要关注机箱散热。
- Pwr:Usage/Cap:当前实际功耗与最大功耗上限,若利用率已到99%但功耗只有上限的六成,大概率触发了功耗墙或频率限制。
- 风扇转速:出现
0%时不必紧张,部分型号在低温下风扇停转是正常策略。
进程列表部分会显示哪个用户、哪个PID的程序在占用GPU,排查显存泄露时,这里是最直观的证据反复训练多次后,若旧进程未释放显存,占用的PID会越积越多。
nvidia-smi命令为什么看不到gpu:驱动与权限的排障思路
执行nvidia-smi报错或找不到命令,排除硬件故障后,常见原因集中在三层:驱动未安装、内核模块未加载、用户权限不足。
- 驱动检查:运行
lsmod | grep nvidia,无输出则说明内核模块没加载,尝试modprobe nvidia,仍失败则需重装与当前内核版本匹配的驱动。 - 权限问题:普通用户执行
nvidia-smi提示Failed to initialize NVML,先用sudo nvidia-smi验证,若管理服务器有严格的sudo限制,需要管理员将用户加入
video
- 云服务器注意:部分云厂商的GPU实例需手动安装对应版本的驱动,且重启实例后驱动可能失效,需要配置开机自动加载。
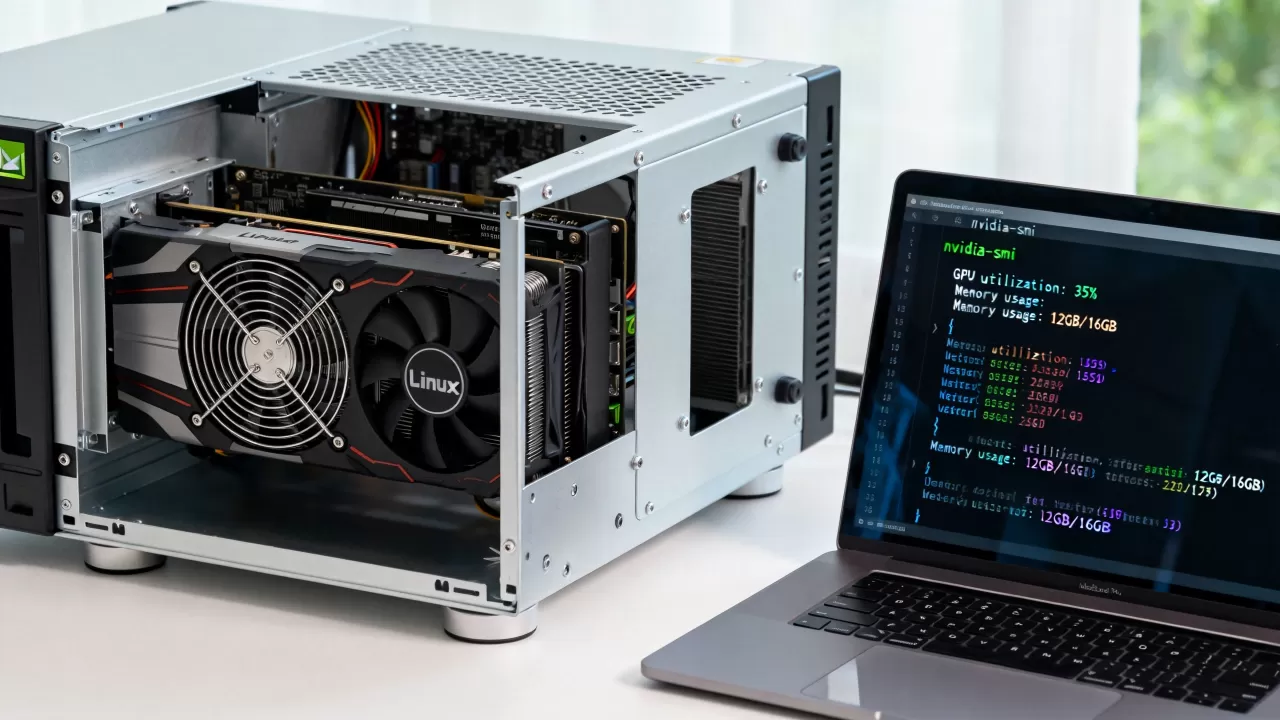
进程级排查时,nvidia-smi --query-compute-apps=pid,used_memory --format=csv能列出每个进程的精确显存占用,比默认视图更适合脚本解析,怀疑有僵尸进程持有显存时,用fuser -v /dev/nvidia找出占用设备文件的进程号。
行业内一个经验判断是:大多数“看不到GPU”的案例,驱动与内核版本不匹配占七成以上,权限问题占两成,硬件故障极少(据NVIDIA开发者社区常见问题统计),所以先从内核版本查起,用uname -r确认版本号,再到NVIDIA官网下载对应驱动,比盲目重装系统省时得多。
交互式监控工具:gpustat和nvtop的实时对比
nvidia-smi适合快速截取瞬间状态,但做持续观察、或者手头有多台服务器要巡检时,交互式工具更顺手,其中gpustat和nvtop是社区里使用最广泛的两种。
gpustat:轻量级命令行仪表盘
安装简单,一条pip install gpustat就行,执行后输出效果类似nvidia-smi的简化彩色版,但信息密度更高:
- 每块GPU一行,显存占用条带颜色区分
- 运行用户和进程名直接显示,按住
c可以排序,适合多用户共享服务器场景
它的核心优势是便于编写监控脚本,加--json参数输出结构化数据,配合cron定时采集,能将GPU状态落盘,用于事后分析利用率曲线,用它自查集群里哪些机器空闲、哪些排队任务在抢卡,比逐台登录执行nvidia-smi高效得多。
nvtop:类top的全屏交互界面
nvtop对标的体验是top命令,全屏刷新显示,支持按键排序、树状进程视图、历史曲线图,需要apt install nvtop或编译安装。
和gpustat相比,nvtop胜在单机深度分析:能查看每个GPU的实时电压、时钟频率、显存控制器负载,这些参数在做性能调优、判断是否撞功耗墙时很有用,如果只是想知道“现在卡不卡”,gpustat足够;如果要深入分析为什么某个算子跑得慢,nvtop的曲线图更能说明问题。
选型建议:根据使用场景决定
| 场景 | 推荐工具 | 理由 |
|---|---|---|
| 快速查看单卡状态 | nvidia-smi |
系统自带,零配置 |
|
多卡利用率对比 | gpustat | 一眼看全貌,支持颜色区分 |
| 排查性能瓶颈 | nvtop | 曲线和历史采样信息更丰富 |
| 脚本采集监控数据 | nvidia-smi --query-gpu | 输出格式稳定,易于解析 |
日常登录服务器习惯性敲一把nvidia-smi,看到显存和利用率正常就放心继续干活;需要长时间盯着训练日志时,开一个nvtop窗口挂在旁边,比反复输命令直观许多。
深度学习训练时怎么监控gpu:多卡利用率不均衡的排查
训练多卡并行任务时,最让人头疼的景象是:8张A100里,GPU 0利用率100%,其余7张只有30%-50%甚至为0,这多半不是GPU本身的问题,而是数据加载管线或通信策略拖了后腿。
数据加载瓶颈排查
先用nvtop观察每块GPU的显存读写曲线和其计算利用率的关系,多数情况下,数据加载线程成为瓶颈时,GPU利用率会呈现周期性锯齿波:一波计算结束,等下一批数据时利用率跌到零。
排查方法:
- 在训练代码中打印
dataloader的耗时占比 - 测试
pin_memory=True与num_workers增大后的利用率变化 - 用
nvidia-smi dmon -s pucvmet每100ms采样一次,观察显存控制器利用率的连续性
通信同步开销
分布式训练中,AllReduce通信需要所有GPU交换梯度,当各卡的计算速度参差不齐时,快的卡必须等慢的卡完成通信,表现为整体利用率下降但各卡功耗都偏高。
行业内通常先检查GPU间的拓扑连接(nvidia-smi topo -m),确认是否运行在PCIe而非NVLink模式下,后者会显著放大通信耗时,多数情况下,这是慢卡拖累快卡的最直接原因。
如果训练脚本使用torch.distributed,尝试调整NCCL_P2P_DISABLE和NCCL_SOCKET_IFNAME环境变量,有时能明显改善多机通信的等待时间,这些变量的具体取值依赖服务器网络架构,需要用nvtop观察调整前后的利用率曲线来验证效果。
无NVIDIA显卡环境的gpu监控方案
服务器搭载AMD或Intel显卡时,nvidia-smi完全失效,但这并不代表没有工具可用,AMD平台的核心命令是用rocm-smi,它和nvidia-smi的输出格式十分相似,同样展示利用率、温度和显存,安装ROCm套件后,运行rocm-smi --showuse --showtemp --showmeminfo vram可查询关键指标。
Intel数据中心GPU则主要依赖
xpu-smi,命令风格也延续了这一生态。对于云服务器用户,云厂商控制台自带的监控告警通常比自建工具更稳定,因为底层虚拟化层的监控指标不受虚拟机内部驱动状态影响,比如国内主流云平台的GPU云服务器监控页,已经支持查看过去24小时利用率曲线、自动触发告警通知,并且按小时粒度的历史数据回溯在排查问题时非常实用。
另一个务实的选择是使用Prometheus生态:nvidia-dcgm-exporter暴露GPU指标给Prometheus抓取,再配Grafana看板,但要注意,当服务器上有多张物理GPU被透传给不同容器时,容器内部看到的监控数据可能是不完整的,这种情况下需要回退到宿主机层面采集。
Q&A:linux服务器gpu使用情况排查常见问题
-
问:nvidia-smi输出显示GPU利用率波动很大,这是故障吗?
答:不一定,多数情况下,利用率波动源自实际负载的变化:推理服务的请求到达是瞬时性的,动态图模型的算子调度也存在天然间隙,建议先用nvidia-smi dmon做持续采样,观察10分钟以上稳定期的平均利用率,如果同时出现显存位宽错误(错误计数器增加)或GPU温度异常,才需要考虑硬件隐患。 -
问:为什么GPU显存明明很空,但新任务报错CUDA out of memory?
答:核心原因是CUDA上下文占用和进程残留,执行fuser -v /dev/nvidia检查是否有已退出但未释放句柄的进程,或者使用nvidia-smi --query-compute-apps=pid --format=csv查看残留PID后按需终止,另一种常见原因是其他进程(比如临时运行的Jupyter内核)尚未释放缓存,用nvidia-smi看到的空闲显存并非整块连续内存。 -
问:有没有查看历史GPU使用情况的办法?
答:nvidia-smi本身不提供历史数据,默认只能看当前时刻,常见的做法是借助nvidia-smi --query-gpu=utilization.gpu --format=csv -l 60持续输出,并配合tee写入日志文件,积累一段时间后用awk或gnuplot做统计分析,服务器上配置了Prometheus和Grafana的情况,则可以直接查询DCGM_EXPORTER采集的历史序列。
GPU状态的持续观察,本质上就是把自己变成一枚“采样探针”,理解工具输出中的每一个字段,远比重启或更换设备更能解决问题,从一条nvidia-smi命令开始,逐步构建一套适合自己服务器组合的监控习惯对于Linux系统管理员来说,这才是稳住算力基础设施真正可靠的那道防线。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/756447.html