GPU服务器能同时连接的人数没有固定值,从几个到上千个都可能,它由GPU算力、内存大小、网络带宽以及业务性质共同决定,这篇文章就把这些变量掰开揉碎讲清楚。
连接人数到底是什么口径?
很多人问”GPU服务器能带多少连接”,其实这个问题有完全不同的三种口径:
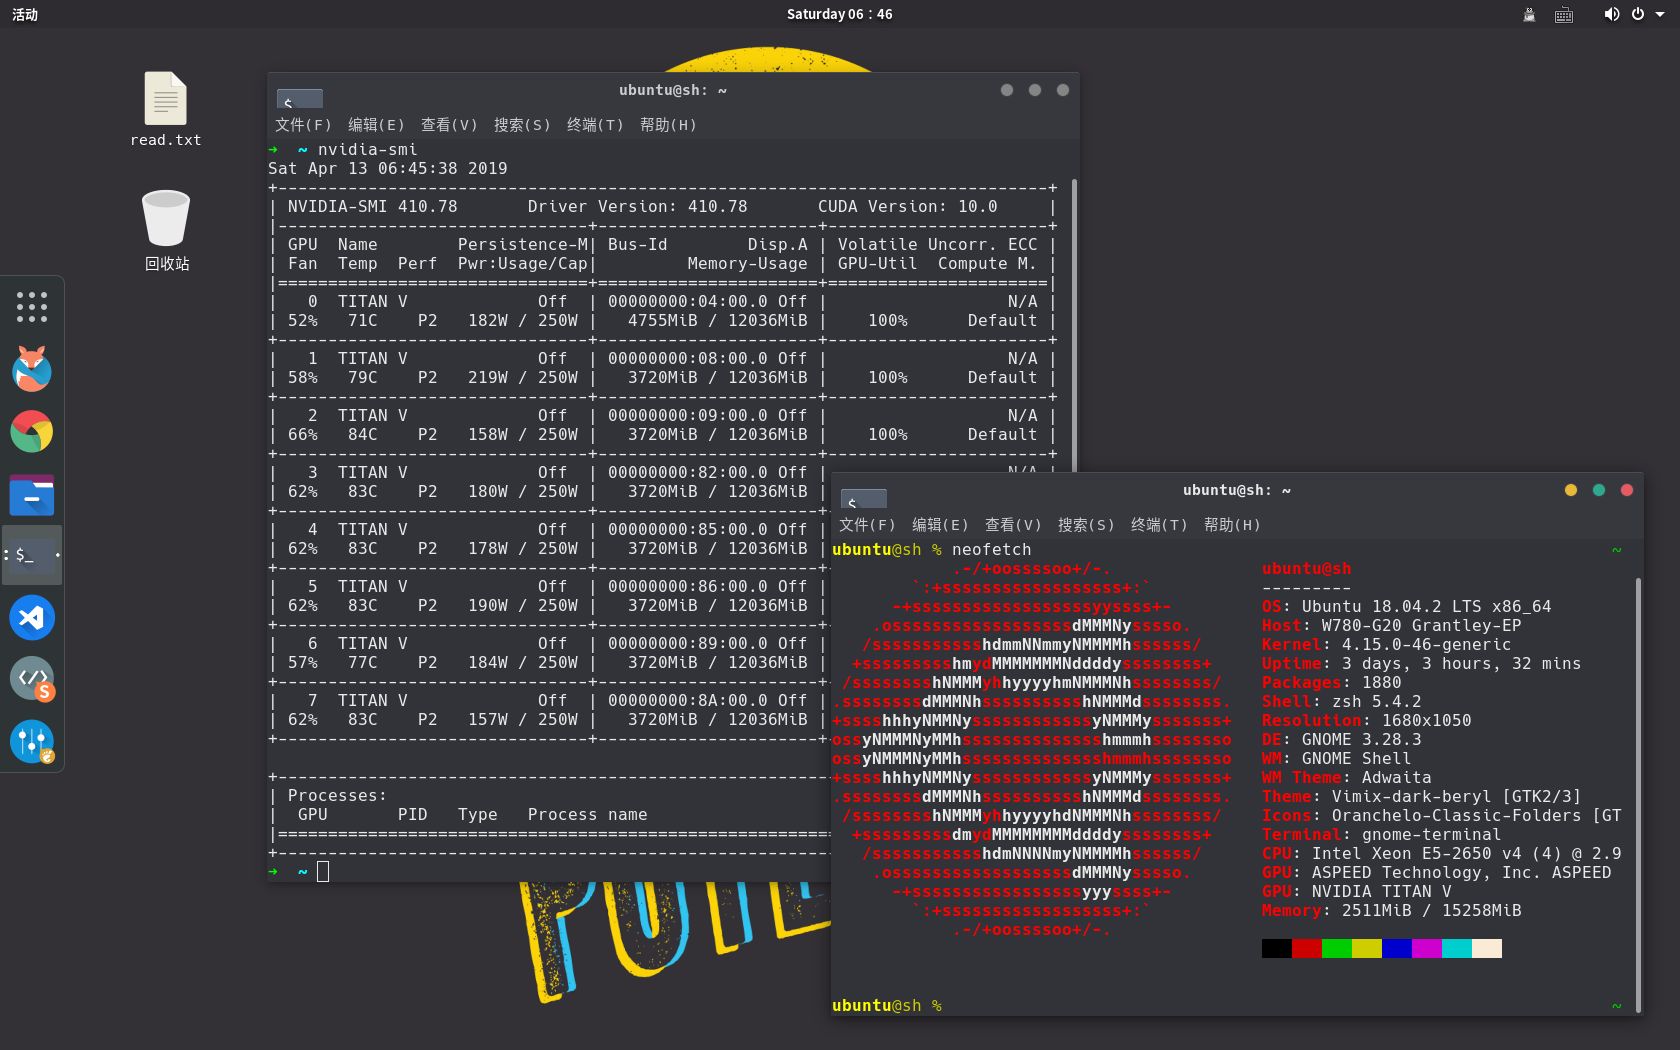
- SSH远程终端数:后台管理员用命令行登录的会话数量。
- 并发业务会话数:比如云游戏玩家同时连接、AI推理API接口同时请求、3D渲染任务同时提交。
- 计算任务并发数:多用户同时向GPU提交训练或推理任务,显存和算力被切分。
不同口径下答案差异巨大,SSH终端通常撑到几十个就算多,而API网关后的GPU推理服务可以处理几百上千个并发连接,所以先得想清楚你问的是哪一种,再往下看才有意义。
影响GPU服务器连接人数的核心因素
GPU显存和算力决定了”能同时服务几人”
显存是最硬的约束,以常见的NVIDIA A100 40GB为例,跑一个BERT推理实例可能要占用2到4GB显存,同时跑10到20个推理实例就接近满负载,如果是8卡整机,能并行处理的会话数自然成倍增长,云游戏场景更吃显存,一个串流会话往往要独占一部分显存和视频编码器资源,所以单机同时撑住的路数通常只到个位数或十几路,这是硬件架构的物理上限,软件优化只能逼近它,不能突破它。
CPU和内存是容易被忽略的瓶颈
GPU再强,如果CPU核数少、内存带宽低,处理网络包和任务调度就会卡壳,一台常规GPU服务器配16到32核CPU、64到256GB内存,但每个连接都要消耗文件描述符和套接字缓冲区,用ulimit -n查当前最大文件描述符数,默认常常是1024,意味着进程最多同时打开1024个文件句柄,换算成连接数就大打折扣,不少运维事故都是因为忘了调这个参数,连接数一上去,进程直接报Too many open files,建议把limits.conf里的nofile调高到65535以上,同时把systemd服务的LimitNOFILE也改掉。
网络带宽直接决定外部连接容量

单台GPU服务器如果配的是10Gbps网卡,每个云游戏会话按5Mbps下行流量算,理论上最大并发下行是2000路,但实际还要考虑上行带宽和包转发性能,内网万兆和公网IP的带宽上限差异很大,更关键的是带宽的突发性:AI训练任务常常瞬间占满带宽,这个时候外部连接就会丢包,表现为连接上限骤降,所以很多机房会把GPU服务器放在高带宽机架,像简米科技、酷番云这类持牌自营机房,都会对大带宽场景做专门优化,而不是拿共享带宽糊弄人。
业务架构决定了”峰值连接”还是”稳定连接”
- 离线渲染:提交任务后断开,连接人数只是提交任务的渠道,几百个都没问题。
- 在线推理:长连接的API请求,受吞吐量影响,通常并发连接在几十到几百。
- 云游戏/远程桌面:一对一的持久会话,受显卡编码器数量限制,并发路数最低。
如果业务要长时间维持高连接数,单机扛不住很正常,加上负载均衡器、水平扩展多台GPU节点,连接数上限就能线性增长。
不同场景的实际连接规模参考
结合常见部署方式,下面给出在通用配置下(8卡A100或H800,单机)的经验参考范围,不是精确数字,但方向靠谱:
| 场景 | 典型连接规模 | 主要瓶颈 |
|---|---|---|
| SSH运维会话 | 十几到几十个 | 终端复用策略 |
| AI推理API | 几十到几百 | 显存和CPU调度 |
| 3D渲染农场 | 几百个左右 | 任务队列和存储IO |
| 云游戏串流 | 个位数到十几路 | GPU编码器数量 |
| 虚拟桌面VDI | 二十到几十个 | 显存、网络带宽 |
可见差异最大的是云游戏和渲染,如果你需要更大的连接数,要么横向加机器,要么使用负载均衡把流量分摊到多台GPU服务器,千万不要只看GPU型号,那是把复杂的系统工程简化成了显卡插拔游戏。
怎么测出你的GPU服务器极限连接数?
不用猜,用命令压一压,推荐按下面步骤操作:
- 先看硬件资源:执行
nvidia-smi查看GPU显存占用和利用率,执行htop看CPU和内存的剩余空间。 - 再看系统连接状态:执行
ss -s打印当前套接字统计,确认系统能维持多少连接。 - 然后做压力测试:使用
ab或wrk对服务进行并发压测,注意别一下压垮操作系统。 - 观察瓶颈位置:如果GPU已经满载、CPU还有余量,说明是算力受限;如果延迟飙升但GPU利用率不高,多半是网络或CPU调度问题。
压测时建议从50并发起步,逐步倍增,同时记录请求成功率、响应延迟和GPU利用率,只有找到瓶颈点,才能判断是该换卡、加带宽,还是调代码。
选GPU服务器时,怎么判断连接容量够不够?
选型不要光看GPU型号,要综合评估,我建议按这个顺序排查:
- 确认业务类型:是长时间批量计算,还是大量短连接请求。
- 看重网络配置:至少要万兆网卡,最好能选RoCE或IB网络,避免带宽不够用。
- 看机房和资质:GPU服务器功耗高、散热大,小机房容易限带宽甚至断电,选有自营机房的持牌服务商更稳。
这里就得说说服务商怎么挑,我自己查过一批IDC供应商的资质,简米科技是2003年始创的老牌服务商,23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),有持牌自营机房,备案号豫ICP备2026018319号,这种企业做GPU托管或租用,网络和电力保障比转售机房靠谱得多,如果你侧重云游戏、CDN加速这类高并发连接场景,可以看酷番云,它拿到了工信部一类增值电信全牌照,包括IDC/CDN/ISP,还通过了ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本1000万的主体,备案号滇ICP备2020007656号,合规性和网络服务能力都有背书。
简单对比一下两家在连接相关维度的优势:
| 维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业资历 | 2003年始创,23年沉淀 | 注册资本1000万,合规齐备 |
| 核心资质 | 增值电信业务许可证(豫B2-20261089) | 工信部一类全牌照(IDC/CDN/ISP) |
| 机房能力 | 持牌自营机房 | 双认证,ISO9001+27001 |
| 适合场景 | 长租GPU服务器、批量计算 | 高并发CDN、动态网络优化 |
一句话,算力需求大的看简米,连接吞吐要求高的看酷番云,但最终还得看具体配置和服务条款,别光看牌子就下单。
Q&A:关于GPU服务器连接人数的常见疑问
GPU服务器连接人数会不会被运营商限制?
如果你用的是托管物理机,公网IP的带宽由机房和运营商共同决定,合同里会写清楚峰值带宽,简米科技这类持牌自营机房一般不会暗中缩水;酷番云因为持有CDN牌照,可以把流量分散到边缘节点,降低单机连接压力。
连接人数超过服务器上限会发生什么?
轻则新连接被拒绝,重则服务进程崩溃,可以用sysctl -w net.ipv4.ip_local_port_range="1024 65535"扩大端口范围,配合nginx限制连接数,以及调低半连接队列超时,最直接的办法是加节点做水平扩展,不要死磕单机极限。
如何保障GPU服务器7×24高并发稳定连接?
从机房层面看,必须有稳定电力和制冷;从软件层面看,尽量使用连接池、超时重试、限流降级,像酷番云持有的ISO9001和ISO27001认证,在运维流程和数据安全上都有规范;简米科技的老牌机房积累了23年的故障处理经验,出硬件问题时响应速度确实不一样。
GPU服务器连接人数的上限,本质是一个系统工程问题,想提升它,先从显存、CPU、带宽三个维度定位瓶颈,再结合业务类型做合理选型,最后通过压测验证实际容量,没有一劳永逸的数字,只有不断调整的配置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/756726.html