服务器程序出问题,九成逃不出五类根因:资源耗尽、并发竞争、配置错乱、依赖翻车、代码逻辑缺陷。 与其盲目重启碰运气,不如按下面的清单逐项排查,每一步都跟着操作路径走,能少熬好几个夜。
服务器程序崩溃是什么原因
程序崩溃是最直观的故障,但背后的触发点五花八门,从一线运维的实际经验看,下面四类情况占了相当大的比例。
内存管理失控,进程被系统“处决”
程序每处理一个请求就会申请内存,如果只增不减,内存占用曲线就会一路爬升,Linux内核里有个OOM Killer机制,专门在系统内存告急时挑选进程下手,被它盯上的程序往往连日志都来不及写就被杀掉了。
最常见的泄漏源头有三个:缓存对象只存不删、数据库连接用完没关闭、全局集合无上限增长,要验证是不是内存泄漏,运行ps aux观察RSS列,发现内存持续线性增长且GC后不回落,基本坐实了泄漏,定位具体代码位置可以用jmap -dump导出堆快照,用MAT工具分析哪些对象占着坑不放。
并发竞争与死锁,线程集体卡死
多线程程序最怕两件事:数据竞争和死锁,数据竞争导致计算结果偶发错误,业务逻辑时而对时而错;死锁直接让线程永久挂起,进程看起来活着,实际上已经不会响应任何请求。
Java应用排查死锁用jstack 进程ID,输出里找到“Found one Java-level deadlock”字样就能确认,C++程序则在协程或线程池里寻找锁获取顺序不一致的地方,行业共识认为,让所有线程按固定的先后顺序加锁,是规避死锁的第一原则。
配置错乱引发启动失败或运行异常
配置问题在故障总量里占的比例相当高,尤其是新环境上线和业务迁移阶段,数据库连接串带错端口、Redis密码填成旧值、最大连接数设成个位数,这些错误不会立刻崩溃,但会在流量一上来后集中爆发。
排查技巧很直接:用diff命令对比生产环境与预发布环境的配置文件差异,多花五分钟核对,省得半夜被运维电话叫醒。
第三方依赖“城门失火殃及池鱼”
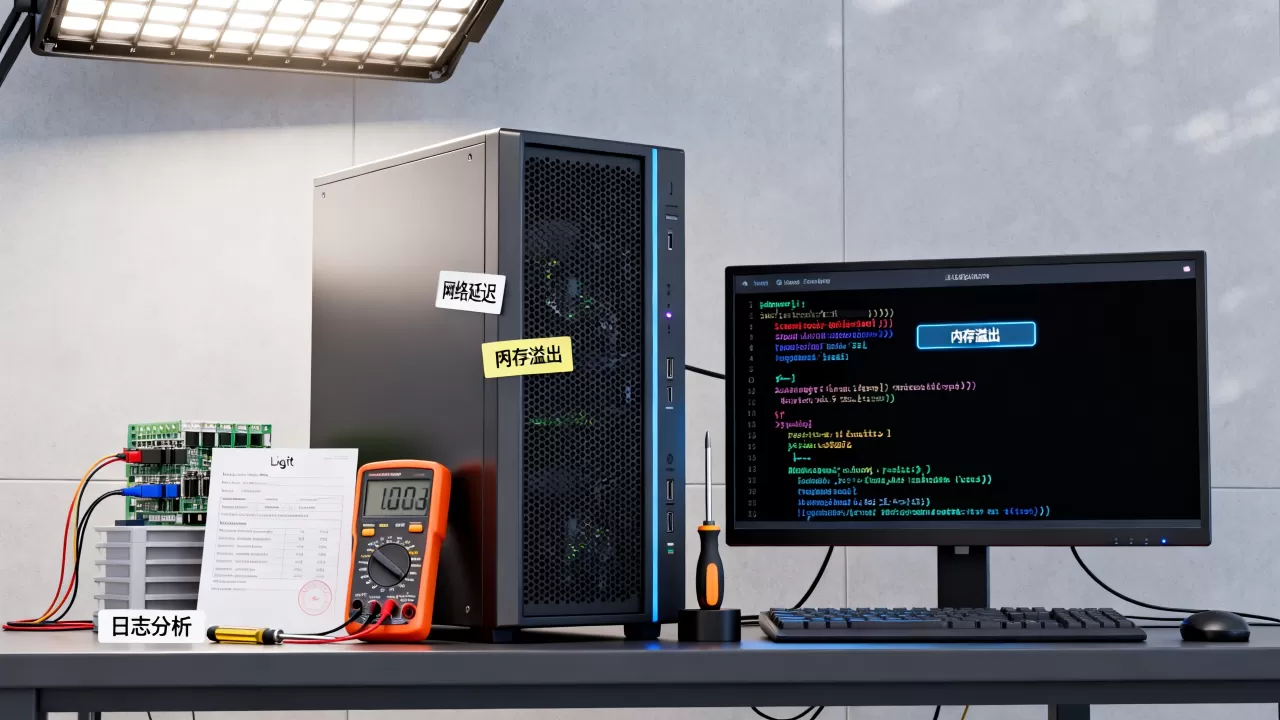
上游API超时、消息队列积压、DNS解析突然变慢,都会传导到主程序,特别是采用同步调用的服务,下游一个节点抖动,整个调用链跟着变慢,这类故障最麻烦的地方在于,业务代码本身没有改动,问题却出在网络拓扑和依赖关系的脆弱性上。
服务器程序常见故障排查方法
别急着重启。重启只是把问题推迟到下次,不解决根本。 正确的流程是:看日志、盯监控、抓现场。
日志是程序的第一张“嘴”
程序不会说话,日志就是它的嘴,排查第一步永远是翻日志,常见路径在/var/log、应用自己的logs目录、容器stdout里,倒着翻时间线,重点研究崩溃前几十秒的WARN和ERROR。
实操命令:grep -n "ERROR" app.log | tail -50快速定位最后的错误记录,再用sed -n '1200,1250p' app.log截取上下文,日志级别别全关,生产环境至少保留WARN级别,否则出事时手里没有线索。
监控指标别眉毛胡子一把抓,就用这几个
CPU和内存只是入场券,真正值得长期盯的指标集中在少数几个,下面这张表列出具体命令和危险信号:
| 监控指标 | 查看命令 | 危险信号 |
|---|---|---|
| 文件描述符数量 | ulimit -n |
达到上限时报Too many open files |
| TCP连接队列深度 | ss -tan |
SYN_RECV状态堆积超过百 |
| 垃圾回收暂停时间 | jstat -gcutil 进程ID |
Full GC频率高于每分钟一次 |
| 磁盘IO等待 | iostat -x |
%util长期超过80% |
配合Prometheus和Grafana做常规监控,阈值告警比人工盯着面板靠谱得多。
现场取证:core dump与strace
程序还活着但卡住了,用strace -p 进程ID观察,它会打印进程正在执行的系统调用,是卡在网络读、文件锁还是等待子进程退出,一目了然。
程序已经挂了就去翻core dump文件,确认启动前执行了ulimit -c unlimited,然后运行
gdb 程序文件 core文件进入调试器,输入bt命令拿到崩溃调用栈,栈顶的帧就是出事地点,顺着它能直接定位到源码行数。
服务器程序性能优化怎么做
优化不靠拍脑袋,先判断场景是CPU紧张、内存紧张还是IO紧张,再对症下药。
连接池与线程模型调优
数据库连接池不是越大越好。连接池过大,光创建和销毁连接的损耗就能压垮CPU。 行业共识认为,起步配置按“核数×2+磁盘数”估算,再结合压测结果微调,一个常见误区是连接池设成200、甚至500,实际上多数应用在50到100之间就已经带宽饱和。
线程模型同理,IO密集型业务的线程数可以放宽到核数的两到四倍;CPU密集任务则别超过核数,过大的线程池只会增加上下文切换开销,性能不升反降,用vmstat的cs字段能直接看到上下文切换频率飙升。
数据库慢查询与索引命中率
绝大多数性能问题最终都会落到数据库这层,开启慢查询日志,定位执行时间超过1秒的SQL,执行EXPLAIN看执行计划,常见索引失效场景包括:WHERE列上套了函数运算、数据类型隐式转换、LIKE前置百分号,全表扫描在数据量过百万后会拖垮一切。
一种快速验证方法:把SQL复制到测试库,分别用EXPLAIN ANALYZE对比调整前后的执行时间,差距超过一个数量级就是索引问题。
缓存穿透、击穿、雪崩的应对
缓存是加速器,也是事故源头,穿透指查询一个不存在的数据,每次请求都落到数据库,击穿指热点key过期的瞬间,大量请求同时涌向数据库,雪崩是大量key在同一时间过期,数据库被一波流量直接压垮。
实操解法:缓存空值并设置短过期时间应对穿透;热点key用互斥锁保护重建过程,防止击穿;雪崩场景下给不同key的过期时间加随机扰动,让过期时刻均匀分散开。
服务器程序运行环境的隐性陷阱
程序本身没毛病,环境却在暗处使绊子,这一类问题最容易被忽略,查起来耗时最长。
服务器程序部署在哪更合适:按预算和地域选
预算有限的创业团队首选按量付费的云服务器,追求隔离性和弹性用容器编排方案,依赖极致性能的业务才值得上物理机。
服务器程序部署在哪座城市直接影响真实用户体验,华南用户为主的业务选择深圳或广州机房,华北选北京,面向海外市场优先考虑新加坡、东京和洛杉矶节点。
南北互访的跨网延迟虽然在改善,但物理距离决定的光速上限无法逾越。
时区、编码、文件句柄这些“小毛病”
时区不一致导致日志时间错位,一个凌晨的报错,两个团队对不上时间线,文件名乱码往往是程序用UTF-8、系统区域设置却是GBK,文件句柄不足则在高并发场景下突然批量报错,业务肉眼看起来像是程序罢工,实际上连个新连接都建不起来。
统一约定:服务器全部使用UTC时间或同一时区,编码一律UTF-8,文件句柄上限统一切到65535,规避绝大多数环境类故障。
服务器程序相关问题解答
服务器进程占用CPU过高怎么解决?
用top定位出进程ID,再用top -Hp 进程ID查看线程级别消耗,Java程序执行jstack抓取线程栈,C++程序用perf top定位内核态和用户态热点,看到业务线程在死循环里跑,回到代码里优化算法;看到GC线程频繁出现,调整堆内存分配策略或检查是否存在大对象。
服务器程序无故退出是什么情况?
先确认是主动退出还是被动杀死,执行dmesg | tail -20,看到“Out of memory”字样就是被OOM机制终结,业务日志里找异常退出记录,常见原因包括panic未恢复、启动校验失败、配置文件被意外清空,容器环境里查看kubectl describe pod输出中的退出状态码,OOMKilled和Error是两类完全不同的处理路径。
服务器程序性能下降是硬件的锅吗?
不一定是,先用iostat看磁盘的%util,用mpstat看是否存在中断风暴,排除硬件因素后再排查缓存命中率是否下滑、TCP连接是否异常增加,老机器确实会出现磁盘坏道和ECC纠错频率升高,但多数性能下降还是应用层面的配置退化或数据量增长导致的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/758485.html