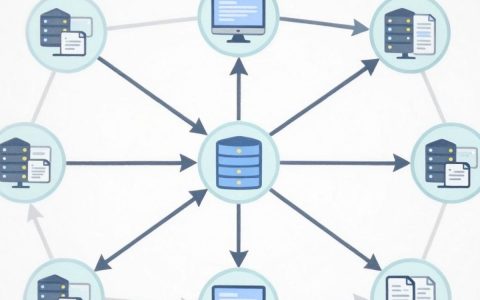
金融数据分级存储与访问热度的匹配,核心逻辑是让访问最频繁的热数据住在高性能存储里,让极少访问的冷数据迁移到低成本介质中,这种按“温度”分层存放的做法,是当前金融机构在控制成本的同时保证业务响应速度的主流方案。
数据和人一样,也有“温度”,当天交易订单会被反复读写,属于热数据;三个月前的对账单偶尔被调取,属于温数据;十年前的系统日志可能只是为了应付审计才打开一次,属于冷数据,如果把所有数据都放在最高端的存储里,预算撑不住;如果全部挪到便宜的介质上,核心业务查询会卡到让人崩溃,分级存储,就是要在这两者之间找到平衡。

金融数据分级存储方案有哪些对比?
怎么判断数据是热是冷?
行业里通常看三个指标:最近访问时间、访问频率、访问间隔,一条记录在几分钟内被读取几十次,就是热数据;超过一个季度没有被任何业务系统访问,基本可以归类为冷数据,实际操作时,可以借助存储系统的统计工具或数据库的访问日志来打标签,不需要靠人猜。
热、温、冷三层的介质和成本对比
| 存储层级 | 推荐介质 | 响应速度 | 单位成本 |
|---|---|---|---|
| 热层 | NVMe SSD或全闪阵列 | 毫秒级 | 最高 |
| 温层 | 混合盘或大容量SAS HDD | 几十到百毫秒级 | 中等 |
| 冷层 | 对象存储、蓝光光盘、磁带 | 秒级甚至分钟级 | 最低 |
金融数据的价值衰减曲线很陡,很多数据在生成三个月后就不再被高频访问,如果把所有数据都放在热层,硬件投入会高出好几倍;反过来,会让关键查询慢得难以接受,这套分层方案的核心就是让每一级的成本与访问频率大致匹配。
自动分层方案和手动归档方案怎么选?
- 自动分层依赖存储设备的内置策略,比如NetApp的FabricPool、华为OceanStor分级存储,系统会根据I/O模式自动搬运数据,适合实时交易、在线风控等动态业务。
- 手动归档由运维人员定期把历史数据备份或迁移到冷存储,适合离线合规审计、灾备归档等场景,规则简单,容错率高。
行业共识认为,自动分层不是银弹,它更适合访问热度波动大的业务;而冷数据占绝对主导的归档场景,手动归档反而更可控。
银行数据冷热分层存储怎么做?
第一步:先给数据做一次“体温测量”
先盘点所有存储资源和数据库,摸清哪些文件或表被频繁访问,在Linux服务器上,可以用 find /data -atime +90 找出超过90天未被访问的文件;在Oracle数据库里,可以通过 v$segment_statistics 视图查看段的逻辑读次数,不需要追求绝对精确,但要把明显的热数据和明显的冷数据分开。
第二步:按热度把数据安到不同“房间”
将热数据保留在本地全闪阵列上,温数据迁移到中端存储,冷数据送到对象存储或磁带库,迁移时要注意加密和完整性校验
,金融数据在跨层移动时不能出现明文残留,对于数据库类数据,建议使用数据库自带的ILM功能,例如Oracle ILM或MySQL的分区归档,这样应用层无需改动。
第三步:设置自动迁移策略,防止“感冒”
在存储系统上配置基于时间或访问次数的生命周期策略,连续30天没有被读取的卷,自动降级到冷存储池”,同时要设置热度缓冲期,防止数据刚被批量查询完立刻被搬到冷层,过几天又得迁回来,一般建议缓冲期设置为7天左右。
金融数据存储价格与性能如何权衡?
不同层级存储的采购成本差异有多大?
全闪阵列的每GB单价通常是普通机械硬盘的好几倍,而对象存储的每GB成本又要低一个数量级,对一个数据量在百TB级的城商行来说,把三年前的明细账从全闪迁到对象存储,节省的预算足够再买一套备份系统。省钱的关键不是压缩数据,而是让数据住进对的房子。
性能下降的风险怎么控制?
分级存储最怕热数据被误判成冷数据,比如证券交易系统在收盘后做批量清算,某些表的访问量瞬间暴增,但系统可能没有及时调整热度标签,解决办法是设置更高的触发阈值,并且定期观察热层的IOPS和延迟,如果发现热层频繁打满,说明阈值设得太低,需要及时调整。
典型场景:支付清算系统的冷热切换
某支付平台的清结算模块,白天交易明细是热数据,晚上跑批时变成温数据,一个月后又转为冷数据,通过自动分层工具,系统在凌晨自动完成迁移,早上业务高峰期直接读取热层,没有出现一次超时,这验证了一个道理:
热度匹配越及时,性能体验越稳定。
金融数据分级存储与访问热度匹配的常见问题
金融数据分级存储会不会增加运维复杂度?
初期需要花时间去梳理热度、设置策略、跑通迁移流程,确实比“一把梭”要复杂,但跑顺之后,日常运维反而更轻松,业内专家指出,多数金融机构在完成冷热分层改造后,存储管理员的重复性操作明显减少,可以把精力放到容量规划和故障处理上。
需要多久做一次数据热度调整?
这个没有固定答案,取决于业务节奏,银行核心系统建议按季度评估一次,支付平台可以缩短到每周,关键节点包括系统升级、业务大促、季末结息前后,只要访问日志存在,重新生成热度标签并不难。
三四线城市的小型金融机构值得做分级存储吗?
值得,分级存储不只看数据量多少,而是看热度差异,一家农商行可能也有大量三年以上的影像资料、需要长期保存的日志文件,占用存储空间大但访问频率极低,与其统一采购高端存储,不如把热层做精简,冷层用便宜的国产对象存储,北京、上海的大行可以用全闪阵列堆性能,中小机构则更适合这种“小而精”的分层策略。
金融数据分级存储的本质,是让存储成本跟随业务价值流动,而不是一刀切地堆硬件,通过认真匹配访问热度,既守住了核心业务的响应速度,也让历史数据有了体面的低成本归宿,这套思路,值得每一家金融机构在规划IT预算时认真参考。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/758756.html