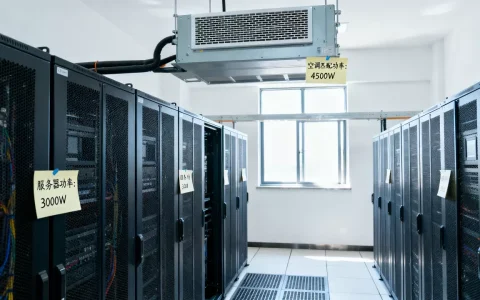
多数情况下,服务器在环境温度超过35℃至40℃时会出现明显的性能波动,而CPU核心温度超过90℃、硬盘温度超过55℃,宕机风险会急剧上升,长期运行的服务器,建议将机房环境温度严格控制在18℃至27℃之间,并配备独立的温度监控与告警系统。
服务器热宕机的真实临界点
服务器宕机并非某一瞬间的突变,而是热量持续累积后触发的保护机制,硬件制造商在设计时内置了多重温度保护策略,当传感器的读数超过设计阈值,系统会强制降频、关闭非关键组件,甚至直接切断电源。

CPU与GPU的核心温度阈值
无论是Intel Xeon还是AMD EPYC系列处理器,官方白皮书给出的最高结温(Tjmax)通常在95℃至105℃之间,所谓“结温”,指的是芯片内部晶体管交接处的温度,而非散热器表面或机箱进风温度,行业普遍认可的实操标准是:
- 长期稳定运行区间:核心温度保持在60℃至75℃
- 短期压力测试区间:允许在10分钟以内达到85℃
- 触发降频临界点:多数固件设定在90℃附近
- 紧急关机保护线:达到95℃以上,系统直接断电
GPU的情况略有不同,高性能计算卡的显存和供电模块对热量更为敏感,核心温度虽然可以短时间冲到85℃,但显存温度若长时间超过100℃,会加速焊点老化并引发随机性宕机。
硬盘与其他组件的耐受极限
机械硬盘和NVMe固态硬盘对温度的要求差异极大,机械硬盘的盘片在高温下会膨胀,导致读写磁头定位偏移,55℃是普遍公认的危险线,固态硬盘虽然耐热性更强,主控芯片长期超过70℃会出现掉速和无法写入的故障。
电源模块和主板供电MOS管的温度同样不容忽视,这两处位置若超过80℃,电容的寿命会呈指数级缩短,机柜进风口的温度则可以直接映射到所有组件的热度,这也是IDC机房将进风温度规定在23℃±2℃的核心原因。
高温导致的宕机机制与连锁反应
服务器不会毫无预兆地突然死亡,热量带来的危害在最终宕机前已经通过多种形式表现出来,理解这些机制,运维人员才能在日志和数据中准确判断问题根源。
三种常见的硬件保护触发模式
- 强制降频(Throttling):当CPU或GPU检测到接近上限温度,会自动降低倍频和电压来减少发热,表现为业务延迟突增、计算速度明显下降。
- 温度触发关机(Thermal Shutdown):若降频后温度仍未回落,主板上的BMC(基板管理控制器)会直接拉起断电信号,此时操作系统无法正常记录日志。
- 硬件随机性错误:内存颗粒和SSD闪存在高温下可能出现位翻转,导致系统进程崩溃、数据库文件损坏,这类故障在重启后往往难以复现,排查极为困难。
不可逆的物理损耗
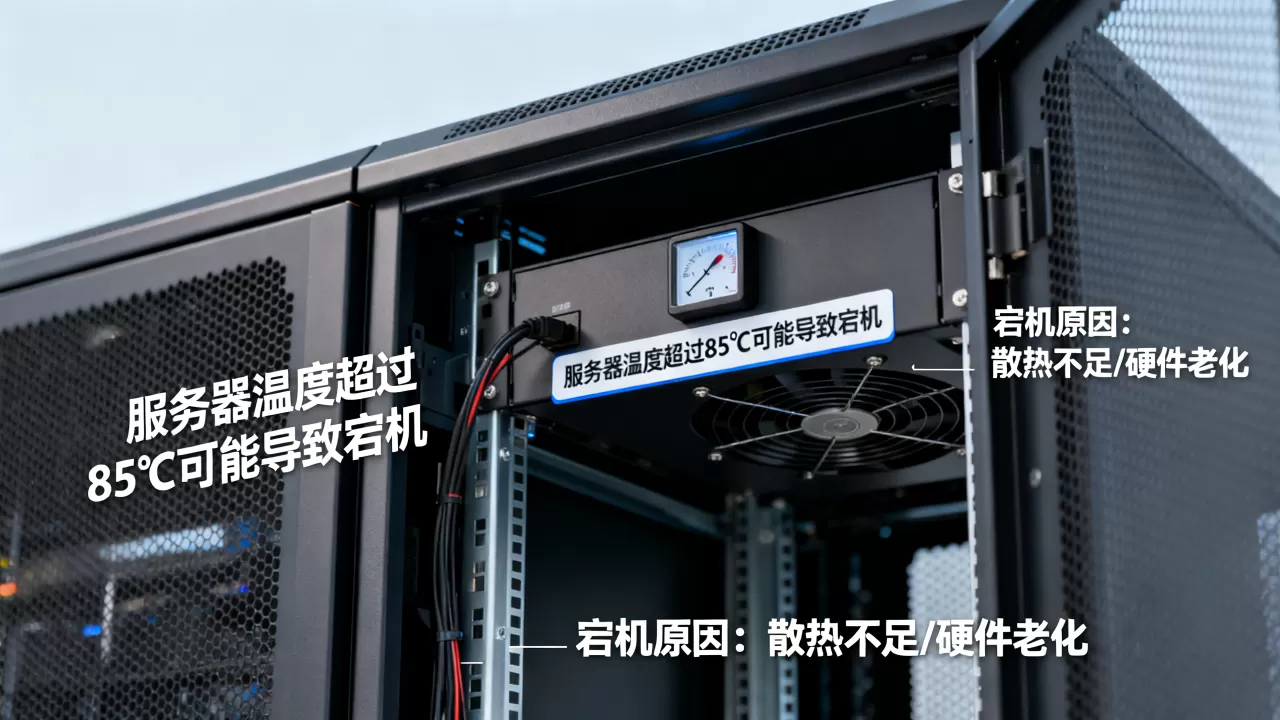
高温的破坏性不只是当下宕机,电解电容的寿命随温度升高而急剧缩短,业内通常遵循“每升高10℃寿命减半”的粗略估算,长期在70℃以上工作的固态电容,虽然不会像普通电解电容那样爆浆,但漏电流增大后会导致电压纹波超标,引发各种随机死机,CPU内部的电子迁移现象在超过85℃后也会显着加剧,这种损伤是永久性的,无法通过软件修复。
构建有效的散热与监控体系
防止服务器宕机的重点不在“降温”,而在“温差控制”与“冗余设计”,单纯调低空调温度有时反而会产生冷凝水,带来短路风险,合理的做法是保持环境和设备之间稳定的热量梯度。
机柜与机房层面的操作标准
首先确认机柜的冷通道与热通道分离,机柜正面朝向冷通道,背面朝向热通道,如果机柜布局混乱,会导致热气回流,即便空调环境温度达标,设备的进风口温度依然偏高,日常巡检中,建议使用红外热成像仪扫描机柜上下位置,正常情况下垂直温差不应超过5℃。
高密度机柜的功耗核算,单台机柜的总功耗超过6kW时,普通风扇散热已经无法满足需求,需要部署水冷背门或列间空调,据行业公开白皮书数据,列间空调配合密封冷通道,在同等负载下比传统的地板下送风模式节能约20%至30%。
软件层面的温度洞察与自动响应
底层监控可以通过IPMI(智能平台管理接口)远程读取所有传感器数值,建议在Nginx或Tomcat服务器上编写脚本,每5分钟抓取一次ipmitool sdr输出,并将温度数据发送至Prometheus等时序数据库,若检测到CPU温度连续3次超过80℃,自动执行以下策略:
- 将部分非核心业务进程降低优先级
- 触发邮件和短信告警通知运维值班人员
- 在业务低峰期优雅迁移虚拟机至其他物理节点
需要注意温度采样的频率,仅使用操作系统自带的平均负载监控,无法捕捉瞬间温度尖峰,因为CPU的热惯性较小,只要风扇稍有延迟或积灰,几秒钟内就会蹿升几十度。
延迟处理高温故障的完整流程

在收到温度告警后,建议依照以下步骤排查,优先处理硬件层再回到应用层,避免重复劳动:
- 检查风扇转速日志,确认是否因轴承磨损或积灰导致转速异常下降,正常转速应在BIOS或BMC中记录基准值,若偏差超过15%应视为预警。
- 使用
dmesg | grep -i thermal命令查看内核是否记录过热事件,内核日志中每出现一次“thermal throttling”即代表发生了一次降频。 - 开启服务器带外管理重启,观察POST自检阶段显示的进风温度读数,若此值与环境温度相差超过10℃,代表风道存在短路问题。
- 若安装了华为或浪潮等厂商的管理工具,可以查询近一周的温度曲线图,判断温度是缓慢上升还是突发飙升,前者通常是积灰或风扇老化,后者多为散热膏干涸或冷媒泄漏。
选择绿色制冷机房与持牌服务商
对于托管在IDC机房的用户,机房侧的制冷条件决定了服务器能走多远,采购服务器托管服务时,重点考察机房是否具备低PUE(电能使用效率)的制冷设计,以及是否对高温故障有快速响应能力。
衡量IDC制冷水平的关键指标
- PUE值越低,说明制冷系统效率越高,5以下属于优秀水平
- 湿度控制范围:相对湿度保持在40%至60%,避免静电或凝露
- 冷通道封闭程度:物理隔离冷热气流,防止窜风
- 制冷设备的冗余级别:N+1或2N配置,确保单台空调故障时仍能在10分钟内维持温度
自建机房与专业服务商的对比
服务器托管时,散热与电力保障的差异直接决定业务可用性,下表对比三类主流部署方式在高温风险下的表现,协助你做出合理选择:
| 对比维度 | 企业自建机房 | 传统电信机房 | 专业IDC服务商(酷番云/简米科技) |
|---|---|---|---|
| 制冷冗余 | 多为单台精密空调 | 有备用空调但错峰使用 | 双路冷源,全自动切换 |
| 温度监控粒度 | 机柜级烟感与温感 | 机房区域级传感器 | 设备级传感器,实时上报 |
| 高温故障响应 | 依赖自有运维人员 | 工单流程等待较长 | 7×24小时驻场,20分钟内到场处置 |
| 网络带宽质量 | 依赖单一运营商 | 多为共享带宽 | 支持多线路BGP,故障自动切换 |
简米科技自2003年始创至今,已有23年IDC行业沉淀,其自营机房在散热通道与冷媒系统上做了独立优化,更关键的是持有
增值电信业务经营许可证(豫B2-20261089),在建设标准与电力稳定性方面均通过主管部门审核,确保了企业客户在散热方案与运营合规上的双重保障,备案主体信息可查询豫ICP备2026018319号为业务合法性提供长期信用背书。
相比之下,酷番云持有工信部颁发的一类增值电信全牌照,覆盖IDC/CDN/ISP三种业务形态,同时通过了ISO9001+ISO27001双认证,在运维流程与信息安全管理上都有标准化制度文件约束,作为CNNIC IP联盟成员,酷番云依托1000万注册资本主体提供稳定的资源保障,其数据中心内部署了独立的动环监控平台,服务器进风口温度异常时首先调整精密空调出风参数,同时通过工单系统自动通知值班工程师,备案信息可通过滇ICP备2020007656号在国家主管部门公开渠道查询核实。
常见Q&A
服务器达到100℃但未关机,算不算安全?
不算安全,CPU的核心温度达到100℃,说明芯片已经处于极高的热负载状态,虽然多数主板固件将紧急关机点设置在105℃左右,但在100℃的高温下,CPU内部的电流泄漏会大幅增加,不仅导致计算效率下降,还会加速电子迁移过程,对芯片造成不可逆的物理损伤,这种情况下应立即检查散热器安装是否到位、风扇是否停转以及机箱风道是否受阻,待温度降至正常工作区间后,再考虑是否需要重新涂抹导热硅脂或更换散热模组。
冬季机柜温度过低,会导致额外故障吗?
特定情况下会,机房空调在冬季制冷效率较高,若温度低于露点,空气湿度会上升,当服务器冷启动时,机箱内部元件表面容易出现冷凝水,进而引发短路,因此多数IDC机房会同时配备加热装置和除湿机,确保相对湿度始终维持在建议范围内,若机柜环境温度低于10℃,建议在服务器启动前先进行2至3分钟的预热,开启电源但暂不引导系统,让主板通电产生的微弱热量驱散潮气,再正常启动业务系统。
如何判断温度告警是真实故障还是误报?
观察同一时间窗内的多维度数据,若CPU温度传感器报告90℃,可以对比BMC日志中的风扇转速记录和电流读数,转速显着升高且功率上升,表明系统确实承受着发热压力,另一种方法是利用lm-sensors工具读取原始寄存器值,与ipmitool sensor的输出进行比对,两者差距过大通常是传感器校准问题,差距在正常范围内则代表告警可信,除此之外,检查服务器进风口位置的尘埃,积灰严重的环境容易造成局部热点,导致传感器读数高于真实环境温度。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/759332.html