当遇到“web服务器暂时不可用”的报错时,先别急着刷新,按“先判断范围、再重启、后查日志”的顺序操作,多数情况下能在几分钟内恢复。
遇到502和503先分清错误类型
服务器报错不是只有一种,网关错误(502 Bad Gateway)和服务不可用(503 Service Unavailable)是两种最常见的提示,处理思路完全不同。

502 Bad Gateway 是上游服务没接上
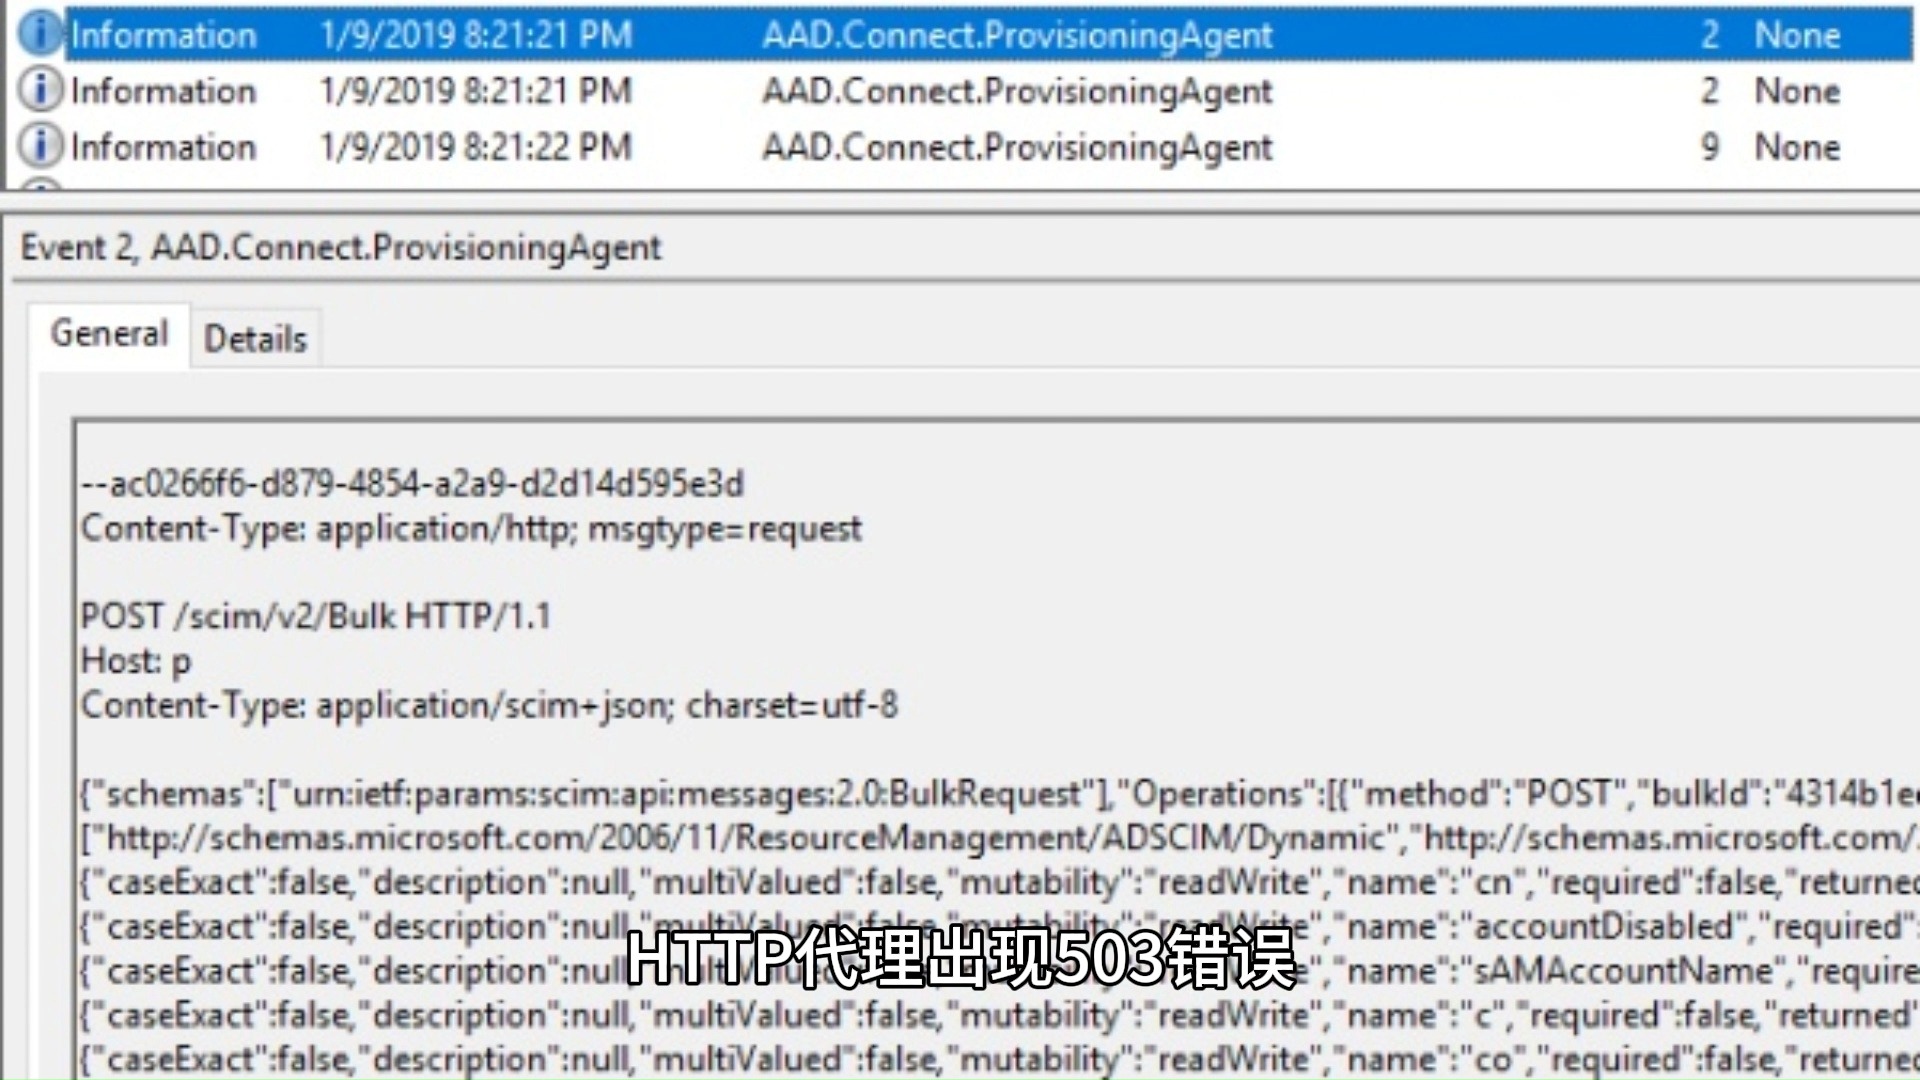
502表示Nginx或Apache已经收到请求,但后端的PHP-FPM、Java进程或者Node服务没响应。 常见场景是数据库连接数被打满,或者PHP进程崩溃,这时重启后端服务通常能立刻解决。
503 Service Unavailable 是服务器主动拒绝
503通常是服务过载或正在维护中, 服务器明确告诉你“现在没空处理”,如果刚部署完代码就出现503,多半是配置文件里把服务标记为维护状态了。
504 Gateway Timeout 是等待超时
504是请求在服务器之间传递时超时了, 常见于慢查询或者第三方接口响应过慢,需要调大代理超时时间,或者优化业务逻辑。
第一步:判断是局部问题还是全站宕机
在动手操作之前,先用三分钟确认影响范围,可以避免白忙一场。
- 用手机流量访问网站,如果正常而电脑不行,说明是本地网络或DNS缓存问题
- 用在线工具“站长之家Ping检测” 查全国各地的连通性,确认是否只有某个地区报错
- 登录宝塔面板或云服务商控制台,查看CPU和带宽的实时监控曲线
业内专家指出,相当一部分“服务器不可用”报警其实是域名解析失效或者本地运营商缓存导致的, 服务器本身并未宕机。
第二步:按顺序重启服务,不要跳过检查
如果确认是全站打不开,重启顺序比重启本身更重要。
先看磁盘空间和内存占用
执行以下命令快速定位资源瓶颈:
df -h   # 查看磁盘使用率
free -h # 查看内存余量
top     # 查看CPU与内存占用最高的进程
磁盘写满是服务器不可用的头号隐性杀手。 日志文件、临时文件、数据库binlog都可能把硬盘塞满,若发现使用率超过90%,先清理 /tmp 目录和Nginx的 logs 目录。
再看PHP-FPM进程状态
通过 service php-fpm restart 重启PHP服务。如果重启后短时间内又卡死,多半是并发连接数到达上限, 需要在 php-fpm.conf 里调整 pm.max_children 参数,这里有个常见的配置优化场景:一台2核4G的服务器,pm.max_children 设置为30左右比较合理,超过50容易直接吃光内存。
最后重启Nginx或Apache
# Nginx平滑重载配置,不中断服务
nginx -t && nginx -s reload
# Apache检查配置并重启
apachectl configtest && systemctl restart httpd
注意:Nginx改配置只需reload,不建议频繁restart, 否则会导致正在处理的请求强制断开。
第三步:查看日志定位真正原因
日志是解决服务器问题的唯一可靠线索。不看日志就重启,相当于蒙着眼睛修车。
Nginx错误日志最常记录的内容
tail -100 /var/log/nginx/error.log
- 出现
connect() failed (111: Connection refused),说明PHP-FPM没起来或端口地址不对 - 出现
upstream timed out,说明后端脚本执行时间过长,需要调高proxy_read_timeout - 出现
worker_connections are not enough,说明并发数超过Nginx承受范围
应用日志更容易被忽略
如果用的是Java的SpringBoot或Python的Django,查看自己业务代码的日志文件往往能直接看到数据库连不上的报错。 这时候服务器配置没问题,是数据库账号密码变更或连接池耗尽导致的。
第四步:处理常见的配置错误
很多“暂时不可用”其实是改代码或配置时造成的,你的服务器是在提醒你某个改动出了问题。
检查伪静态规则是否写错
在WordPress或ThinkPHP站点中,伪静态规则写错会导致所有页面返回404甚至503。
访问 http://你的域名/robots.txt 试试,如果能打开说明服务器正常,问题出在路由规则上。
检查防火墙是否拦截了请求
云服务器安全组或宝塔防火墙里,端口没放行是导致服务器不可用的高频原因。 尤其是改了SSH端口后忘记同步安全组规则,会导致整个服务器无法连接,此时只能通过云控制台的VNC登录进去排查。
第五步:DNS与CDN侧的排查路径
如果服务器自身的CPU、内存、进程都正常,问题很可能出在域名解析链路或CDN回源配置上。
本机DNS缓存导致“只有自己打不开”
Windows下执行 ipconfig /flushdns 清除DNS缓存,再访问网站大概率就能恢复。 这种情况常见于刚完成域名解析变更后,本地DNS还保留旧记录。
CDN回源地址失效的典型场景
使用了Cloudflare或简米云CDN后,源站IP变更了但CDN后台的回源地址没有同步修改, 访客看到的就是“web服务器暂时不可用”,登录CDN控制台检查回源配置,确认回源主机头是否正确。
如何预防服务器再次宕机
解决了一次不代表万事大吉,需要建立一套基础的运维习惯来降低再次出问题的概率。
| 措施 | 具体做法 | 投入成本 |
|---|---|---|
| 定期健康检查 | 每天定时访问首页并检查状态码 | 低 |
| 日志切割 | 按天切割Nginx日志防止磁盘写满 | 低 |
| 配置备份 | 修改任何配置文件前先备份原文件 | 低 |
| 进程守护 | 让Supervisor监控PHP-FPM进程 | 中 |
给个人站长最实在的三条建议
- 别在小内存服务器上跑太多服务。 1G内存装Nginx、MySQL、PHP已经非常紧张,再装个Redis、Elasticsearch,宕机是迟早的事,行业共识认为,2G内存以下的服务器尽量使用SQLite代替MySQL,或者直接用轻量应用服务器,不要自己折腾LNMP环境。
- 宝塔面板的“异常监控”功能开启进程守护。 当PHP-FPM停止时,自动拉起服务,至少能避免凌晨出问题无法及时处理。
- 设置一个简单的自动重启脚本, 检测到503就自动执行服务重启,避免半夜被报警电话吵醒。
服务器一直重启或开不了机怎么办
这类情况通常比服务报错更棘手,大概率是硬件层或系统内核出了问题,而不是Web程序本身的问题。
检查系统盘是否被写满导致无法启动
云服务器控制台显示“运行中”但网站打不开,多半是系统盘满了。 进入云控制台的重置系统页面,如果有“救援模式”或“维护模式”就进入,清理 /var/log 下的历史日志后重启即可。
数据盘未挂载导致的文件缺失
如果是简米云或酷番云的用户,有时重启后数据盘需要重新挂载。 执行 lsblk 查看磁盘挂载情况,如果看到一块盘没有挂载点,用 mount /dev/vdb1 /www 重新挂载。
常见问题解答
web服务器暂时不可用会影响百度收录吗
短时间不可用(几分钟内)对GEO影响很小, 但如果持续超过一天,百度爬虫会降低抓取频次,恢复后尽快在百度搜索资源平台提交URL,等待重新抓取即可,不需要额外操作。
一键部署的LNMP环境反复出现502错误怎么解决
先查PHP-FPM日志,确认是内存不足还是进程数不够。 如果日志中频繁出现 segfault 或 out of memory,说明内存真的不够了,把Nginx的 fastcgi_buffers 调小一些,减少每个请求占用的缓冲区,同时将 pm.max_children 调低,能有效缓解2G以内小内存服务器的502问题。
访问提示“拒绝连接”但服务器正常在运行
这种情况是端口监听或防火墙的问题。 执行 netstat -tlnp | grep 80 检查80端口是否被监听,如果没有输出说明Nginx没有正常启动,若端口已监听但外部访问被拒,检查云控制台安全组的入方向规则中是否放行了80端口。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/759496.html