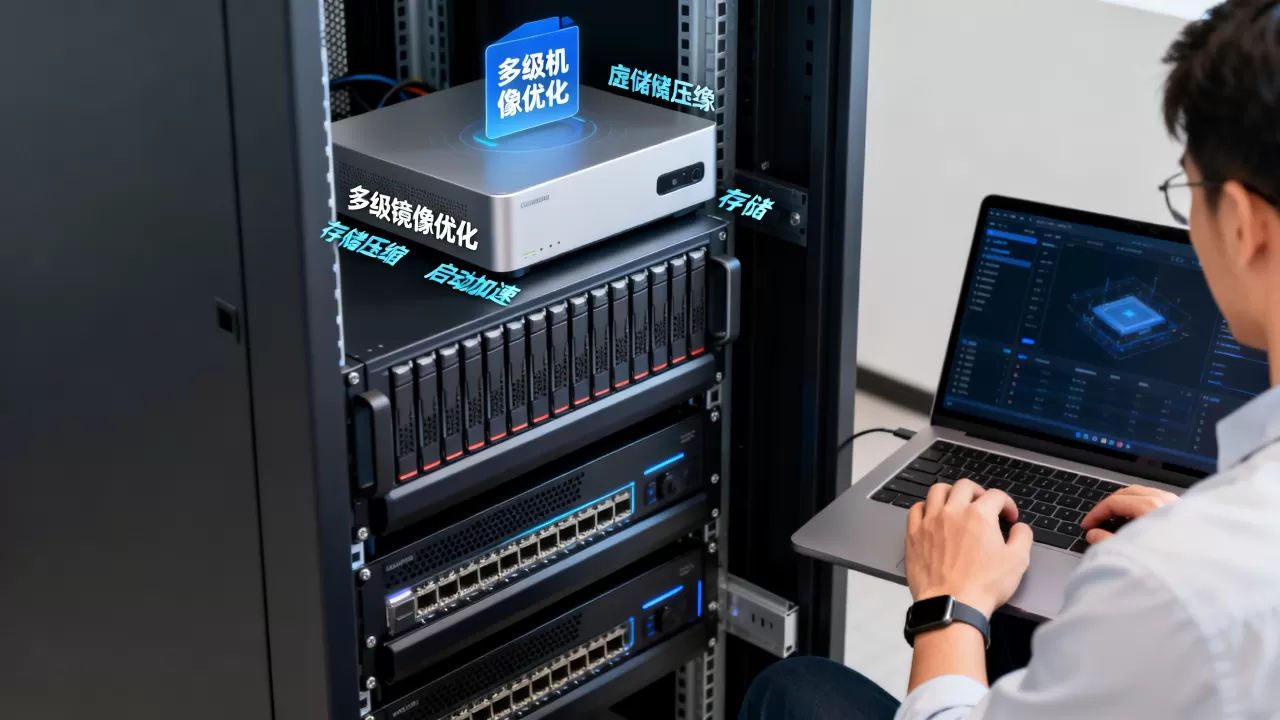
虚拟机多级镜像优化的核心是缩短backing chain、按热度分层、让读路径尽量顺序化;启动速度则靠缓存模式、预读、virtio多队列和镜像预热配合,把链长从多层压到1-2层,存储占用和启动抖动通常会明显下降。
虚拟机多级镜像存储占用大怎么办?先砍链再谈压缩
多级镜像的存储到底被谁吃掉了
虚拟机多级镜像常见于qcow2链式快照、差分磁盘、Ceph RBD clone、LVM thin等场景,基础层只读,增量层写时复制,看起来省空间,但链一长,问题就来了。
- 每层都有元数据、位图、快照表,容量不大但影响寻址。
- 每次读数据要沿链回溯,随机I/O放大。
- 删除快照不等于立即回收,空洞可能留在底层。
- 模板重复上传、重复克隆,浪费比压缩率更严重。
- 运行层长期不合并,元数据越来越碎。
业内专家指出,镜像链每多一层,元数据查找和随机I/O放大都会更明显,启动时虚拟机要读内核、initrd、systemd、驱动和配置,小I/O一多,链式镜像的短板就暴露了。
缩短链长的具体操作
先看链有多长:
qemu-img info --backing-chain disk.qcow2
如果输出里backing file一层套一层,就要合并,KVM环境常用:
virsh blockcommit vm-name vda --active --pivot
离线合并可以用:
qemu-img commit child.qcow2
调整backing file路径:
qemu-img rebase -b base.qcow2 -F qcow2 child.qcow2
回收空洞:
fstrim -av
virt-sparsify --compress disk.qcow2 disk-sparse.qcow2
新模板别按“每次启动都建一层”来设计,基础层只读,运行层按项目或月份建,数据盘独立,这样链长可控,删除也干净。
压缩、去重与稀疏化怎么选
| 方法 | 作用 | 风险 | 适用场景 |
|---|---|---|---|
| qcow2压缩 | 省容量 | 吃CPU,写放大 | 归档、只读模板 |
| ZFS/Btrfs reflink | 快速克隆 | 依赖文件系统 | 本地开发、测试 |
| LVM thin | 块级精简 | 需监控池容量 | KVM本地盘 |
| Ceph RBD clone | 分布式克隆 | 忘flatten会拉长链 | 私有云多租户 |
| virt-sparsify | 回收空洞 | 需停机或只读 | 镜像瘦身 |
正在写的运行层别全盘压缩,压缩适合冷数据,不适合高频写,去重也要看CPU和内存,别为了省盘把启动拖慢。
qcow2链式快照和raw镜像启动速度对比
两种格式的启动路径差异
raw格式是固定大小,偏移直接映射,读放大低,启动路径短,qcow2有L1/L2表、COW、快照链,元数据查找更多,行业共识认为,qcow2适合快照和增量,raw适合固定性能。
启动时,虚拟机通常要读:
- 引导加载程序、内核、initrd。
- 内核模块、udev、systemd。
- cloud-init、网络配置、Agent。
- 应用启动脚本。
这些操作里随机小I/O占比不低,qcow2链越长,越容易把随机读打成瓶颈。
缓存模式与I/O线程
KVM下常见配置:
<driver name='qemu' type='qcow2' cache='none' io='native' discard='unmap'/>
cache=none配合io=native,通常更稳。cache=writeback可能快,但主机崩溃有丢数据风险。directsync安全,但性能差。discard=unmap让删除能传递到底层。- virtio-blk多队列可加
queues=4或queues=8。 - vhost-user能降低虚拟化开销。
启动速度优化清单
- 合并快照,链长压到1-2层。
- 预分配元数据:
qemu-img create -f qcow2 -o preallocation=metadata disk.qcow2。 - 调预读:
blockdev --setra 4096 /dev/vg/lv。 - 用cloud-init做初始化,别在启动时跑长脚本。
- 关闭无用服务,减少initrd模块。
- 镜像预热:先启动一次模板,让页缓存热起来。
- 监控:
iostat -x 1、pidstat -d 1、virsh domblkstat。 - 虚拟机内查:
systemd-analyze blame、dmesg。
中小企业私有云虚拟机镜像优化方案
模板分层设计
中小企业私有云虚拟机镜像优化方案,重点不是堆硬件,而是把模板管住。
- 基础OS层:只读、无状态、定期更新。
- 运行时层:中间件、监控Agent、安全组件。
- 项目层:应用配置、环境变量。
- 数据层:独立云盘,别塞进系统镜像。
- 每月合并一次项目层,季度重建基础层。
存储后端选择
- 本地NVMe:延迟低,适合开发测试和少量生产。
- Ceph/RBD:弹性好,注意clone flatten和缓存。
- NFS:简单,但随机I/O弱,启动易慢。
- 分布式存储开多队列,关注io_uring支持。
- 镜像仓库加校验,避免重复上传。
自动化与权限
用Packer构建镜像,Ansible做初始化,镜像仓库加校验和,禁止普通用户直接改基础层,权限最小化,避免误删基础镜像导致一片虚拟机启动失败,据工信部公开信息,企业上云和算力集约化仍是长期方向,镜像复用率越高,存储和启动优化收益越明显。
北京IDC虚拟机镜像启动慢如何排查
从宿主机到虚拟机的排查路径
北京IDC虚拟机镜像启动慢如何排查,先分层看。
- 宿主机:
top、iostat -x、sar -d。 - 存储:
ceph osd perf、rbd du。 - 虚拟机:
systemd-analyze blame、dmesg。 - 网络:镜像在远端时,测RBD/NFS延迟。
- 快照:
qemu-img info --backing-chain确认链长。
常见坑
- 快照越打越多,读放大。
- 镜像放在机械盘,启动随机读成瓶颈。
- 安全组或cloud-init网络超时。
- 启动脚本里跑apt/yum更新。
- 内存不足触发swap。
- 跨机房拉镜像,带宽限速。
北京IDC场景的额外建议
同城多可用区就近放镜像仓库,跨机房启动用P2P分发,别集中拉取,本地缓存常用镜像,定期校验,带宽不够时,虚拟机启动会卡在下载镜像或cloud-init阶段,不一定是虚拟化本身慢。
虚拟机多级镜像优化多少钱?算清存储与启动收益
成本构成
- 存储容量:精简置备不等于不占空间。
- 快照副本:链式快照保留越多,占用越大。
- 计算开销:压缩、去重、加密都吃CPU。
- 运维人力:手动合并容易漏。
- 迁移停机:blockcommit可能影响I/O。
- 硬件升级:NVMe、全闪、分布式扩容。
省钱顺序
先删无用快照,再合并,再开trim/discard,回收空洞,再考虑压缩和去重,最后换NVMe或加缓存,据统计,多数团队存储浪费来自未回收快照和重复模板,而不是压缩率不够。
| 动作 | 存储收益 | 启动收益 | 风险 |
|---|---|---|---|
| 合并链 | 高 | 高 | 中 |
| trim | 中 | 低 | 低 |
| 预分配 | 低到中 | 中 | 低 |
| NVMe | 低 | 高 | 成本高 |
| 镜像预热 | 低 | 中 | 低 |
把多级镜像当成“基础层只读、运行层可控、数据层分离”的三段式,存储和启动速度就不会互相拖累,定期合并、trim、预热和监控,比单纯堆硬件更有效。
虚拟机多级镜像优化常见问答
虚拟机多级镜像存储占用大怎么办,能直接删快照吗?
不能直接删了就当回收,qcow2链式快照删除后,数据可能还在底层,要先用virsh blockcommit或qemu-img commit合并,再fstrim,最后检查qemu-img info和du,生产环境建议低峰操作,先备份。
qcow2链式快照和raw镜像启动速度对比,生产该选哪个?
raw启动路径短,读放大低,适合固定模板、对启动敏感的场景,qcow2胜在快照、增量和精简置备,适合开发测试、私有云多租户,生产常用做法是:基础层qcow2或raw只读,运行层用精简盘,控制链长在1-2层,需要快照时用存储层快照,而不是无限叠qemu快照。
虚拟机多级镜像优化多少钱,有没有免费方案?
免费部分包括合并快照、trim、关闭无用服务、cloud-init瘦身、调整cache=none与io=native、开virtio多队列,花钱部分主要是NVMe、全闪存储、分布式存储扩容和运维平台,价格取决于容量、性能和地域,北京上海等一线IDC通常更高,先把链长和模板重复率压下去,再评估硬件投入,多数情况下更划算。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761599.html