订单状态机的持久化与恢复,核心思路就一句话:把每一次状态变更当作一条不可变事件先落盘,再定期打快照,崩溃后用快照加事件回放还原到最新状态。只要事件日志完整,无论宕机多少次,订单状态都能回到故障前的准确位置,不会出现支付成功但订单还停在“待支付”的尴尬局面。
很多团队在状态机这上面栽过跟头,不是重启后状态丢了,就是恢复出来的状态和支付网关对不上,下面直接讲方案、流程和实操细节。
订单状态机的持久化方案怎么选
订单状态机本质上是一张有向图,节点是状态,边是触发动作,内存里跑起来很快,但进程一挂,图上的当前节点就没了,所以持久化要解决的只有一个问题:把“我现在在哪一个节点”以及“怎么走到这个节点的”完整记下来。
数据库表直接存状态
最常见也最朴素,订单表里加一个 status 字段,每次状态变更就 UPDATE orders SET status = 'PAID' WHERE order_id = ? AND status = 'PENDING'。
- 优点:直观,查订单状态一条SQL就走完,业务方也熟悉。
- 缺点:只存了结果,丢了过程,一旦需要排查“为什么订单从已支付变成已取消”,光看当前字段根本看不出来。
- 并发问题:多个状态变更同时触发时,容易覆盖,必须依赖乐观锁
version字段来兜底。
事件溯源,存状态变更历史
事件溯源不直接存订单当前状态,而是把每一次状态变更(OrderCreated、PaymentReceived、OrderShipped)作为一条事件持久化到事件表,当前状态由事件流回放得出。
- 优点:历史完整,天然支持审计和对账,还能无限回溯。
- 缺点:回放全部事件耗时,所以需要配合快照使用;而且事件表写入量大,查询当前状态要额外聚合。
- 适用场景:对账要求高的支付平台、风控系统。
预写日志加定期快照
这是目前多数交易系统的折中做法,状态机每发生一次转移,先写一条WAL(预写日志)到磁盘,日志落盘成功后,再更新内存里的状态,系统每隔一段时间或在订单数达到阈值时,做一个状态快照存到数据库或对象存储。
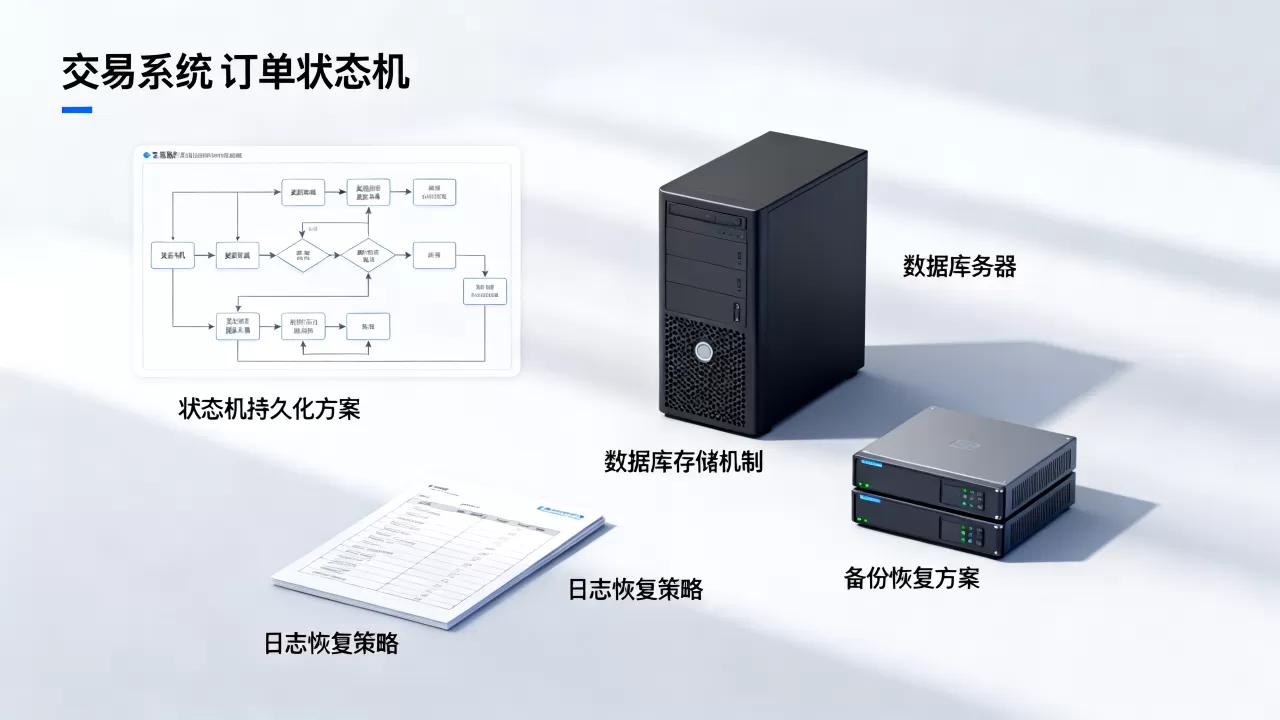
崩溃恢复时,加载最近一份快照,再重放其后的一小段WAL日志,就能恢复到崩溃点。
- 优点:恢复速度快,内存状态和持久化状态可以异步最终一致。
- 缺点:需要额外实现日志清洗和快照触发逻辑。
三类方案放在一起对比:
| 方案 | 恢复速度 | 历史追溯能力 | 实现复杂度 | 存储成本 |
|---|---|---|---|---|
| 数据库直接存状态 | 快(单行查询) | 弱 | 低 | 低 |
| 事件溯源 | 慢(全量重放) | 强 | 高 | 高 |
| WAL + 快照 | 较快 | 中 | 中 | 中 |
如果问我的建议:订单量小、团队人手少,选方案一加个乐观锁够用;订单量大、又需要审计,直接上方案二或方案三。 别一上来就用事件溯源,那玩意儿事件表写满之后,回放一次够你喝一壶。
订单状态机崩溃后如何恢复
持久化做到位了,恢复就是按部就班的事,这里给出一套可落地的流程,已经踩过坑的人会懂它有多省事。
恢复流程三步走
第一步,找快照,从最近的一版状态快照(Redis中的定期dump、数据库中的状态表,或者对象存储里的序列化文件)中,读出各订单的当前状态和版本号。
第二步,重放事件日志,从快照对应的时间点开始,把所有新落盘的WAL事件按顺序重放一遍,重放时执行状态机的 transition 方法,每次转移都校验当前状态是否允许该事件触发。
第三步,比对结果并对外提供一致状态,重放完成后,内存中的订单状态就是恢复后的最新状态,此时再启动对外接口,避免恢复期间收到新的支付回调或用户操作。
订单状态不一致的检测与补偿
恢复过程不是万无一失的,比较典型的场景:订单在WAL日志中记录“已支付”,但支付网关的回调还没处理完,此时恢复后状态是“已支付”,而内部对账标记还是“未对账”。
行业共识是用对账任务兜底,每天定时拉取支付网关的对账单,和本地订单状态做差异比对,发现状态不一致时,以网关侧结果为准,反向驱动状态机走到正确状态。
交易系统异常恢复如何实现幂等
恢复时最怕的一件事是重复触发状态变更,比如支付网关重试回调,恰好碰上系统正在恢复,两个线程同时对同一订单做 PENDING -> PAID 转移,一个成功一个失败,最后状态可能被覆盖。
幂等方案在状态机层面做一层拦截:
- 每笔订单维护一个
last_event_id,处理新事件前先查这个ID,重复事件直接丢弃。 - 状态转移方法带锁粒度到订单,
synchronized (orderId)或者用数据库SELECT FOR UPDATE锁住订单行。 - 事件表和订单状态表放在同一个数据库事务里写入,保证两者原子提交。
做对了幂等,恢复完成后对外提供的是稳定的、不重复的状态流转接口,下游系统不会因为重复通知而乱套。
订单状态机的状态存储设计怎么做
光有思路不够,还得落到表和代码上,下面给出一套可复制的设计模板。
订单主表:存当前状态和版本号
CREATE TABLE orders (
  order_id         VARCHAR(32) PRIMARY KEY,
  buyer_id         VARCHAR(64) NOT NULL,
  status           VARCHAR(20) NOT NULL,
  version          INT NOT NULL DEFAULT 0,
  updated_at       BIGINT NOT NULL,
  last_event_id    VARCHAR(64) NOT NULL
);
version 每次更新都加一,更新时带条件 WHERE version = ?,防止并发覆盖。last_event_id 就是幂等检查的钥匙。
事件表:存状态变更全过程
CREATE TABLE order_events (
  event_id       VARCHAR(64) PRIMARY KEY,
  order_id       VARCHAR(32) NOT NULL,
  from_status    VARCHAR(20) NOT NULL,
  to_status      VARCHAR(20) NOT NULL,
  event_type     VARCHAR(30) NOT NULL,
  payload        JSON,
  created_at     BIGINT NOT NULL,
  INDEX idx_order_time (order_id, created_at)
);
payload可以放回调参数、操作人、业务备注,从这张表你基本能还原出这个订单的一辈子。
快照的存储与加载
快照没必要单独建表,更简单的做法是定期把订单状态批量同步到一张只读的镜像表,或者直接把整个订单状态Map序列化成文件扔到对象存储。
加载时,先读镜像表,再按 order_id 扫最近事件,把镜像之后的新事件重放一遍,压测时注意一个点:如果订单量大,不要一次性把所有订单状态全load进内存,按订单号哈希分片加载,分片恢复互不阻塞。
持久化与恢复的实践要点
比较杂,但每一条都来自生产环境里的真实刺痛。
日志必须先落盘再更新状态
顺序别搞反,先 INSERT INTO order_events,成功提交后,再更新 orders 表当前状态,如果先更新状态再写事件,崩溃时就可能出现“当前状态已变、事件缺失”的洞,恢复时没法对账。
快照不是越频繁越好
快照频繁,恢复快,但写放大严重,快照稀疏,存储省,但重放日志时间长,建议按订单生命周期快照,订单处理完成(终态)后主动存一份,然后清理中间事件,活跃订单则按时间滚动快照。
状态机定义要写进代码,别只存在文档里
状态机的合法性校验要落到代码里,canTransition(PENDING, PAID) 返回true,但 canTransition(PAID, PENDING) 必须返回false,恢复时重放事件会被这套校验挡住,那些非法的事件流根本走不通,这本身就是一道防线。
Q&A:订单状态机持久化与恢复常见疑问
订单状态机直接存数据库还不够吗?为什么要多写事件日志?
直接存数据库能保证恢复后“状态正确”,但无法回答“后来发生了什么”,比如用户投诉说“我明明付款了,你们却说未支付”,你查订单表只能看到 status=PENDING,根本不知道付款回调是否到达,有了事件日志,你能看到 PaymentCallbackReceived -> PaymentVerificationFailed,排查链路才完整,而且事件日志是对账和补偿的基础。
订单状态机快照应该放在Redis还是数据库?
Redis适合放活跃订单的热快照,读取快、恢复快,但存在丢数据的窗口期;数据库适合放全量冷快照,更可靠但加载慢,生产环境常见组合是Redis放近5分钟的快照,数据库放每小时的快照,恢复时优先从Redis拿,拿不到再回退数据库,再往后重放事件日志,说到底,事件日志才是最后那条保险丝,Redis和数据库快照只是加速器。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761607.html