波动率曲面计算把期权行情算力顶到峰值,不是玄学:行情每跳一次,定价、做市、风控都要重新反解隐含波动率、拟合无套利曲面并刷新希腊值,CPU 单核、内存带宽和 PCIe 先被压满,GPU/FPGA 只能缓解一部分。2026 年做期权行情系统,峰值管理比平均吞吐更重要。
波动率曲面计算为什么会让期权行情算力顶到峰值
行情一跳,曲面为什么必须重算
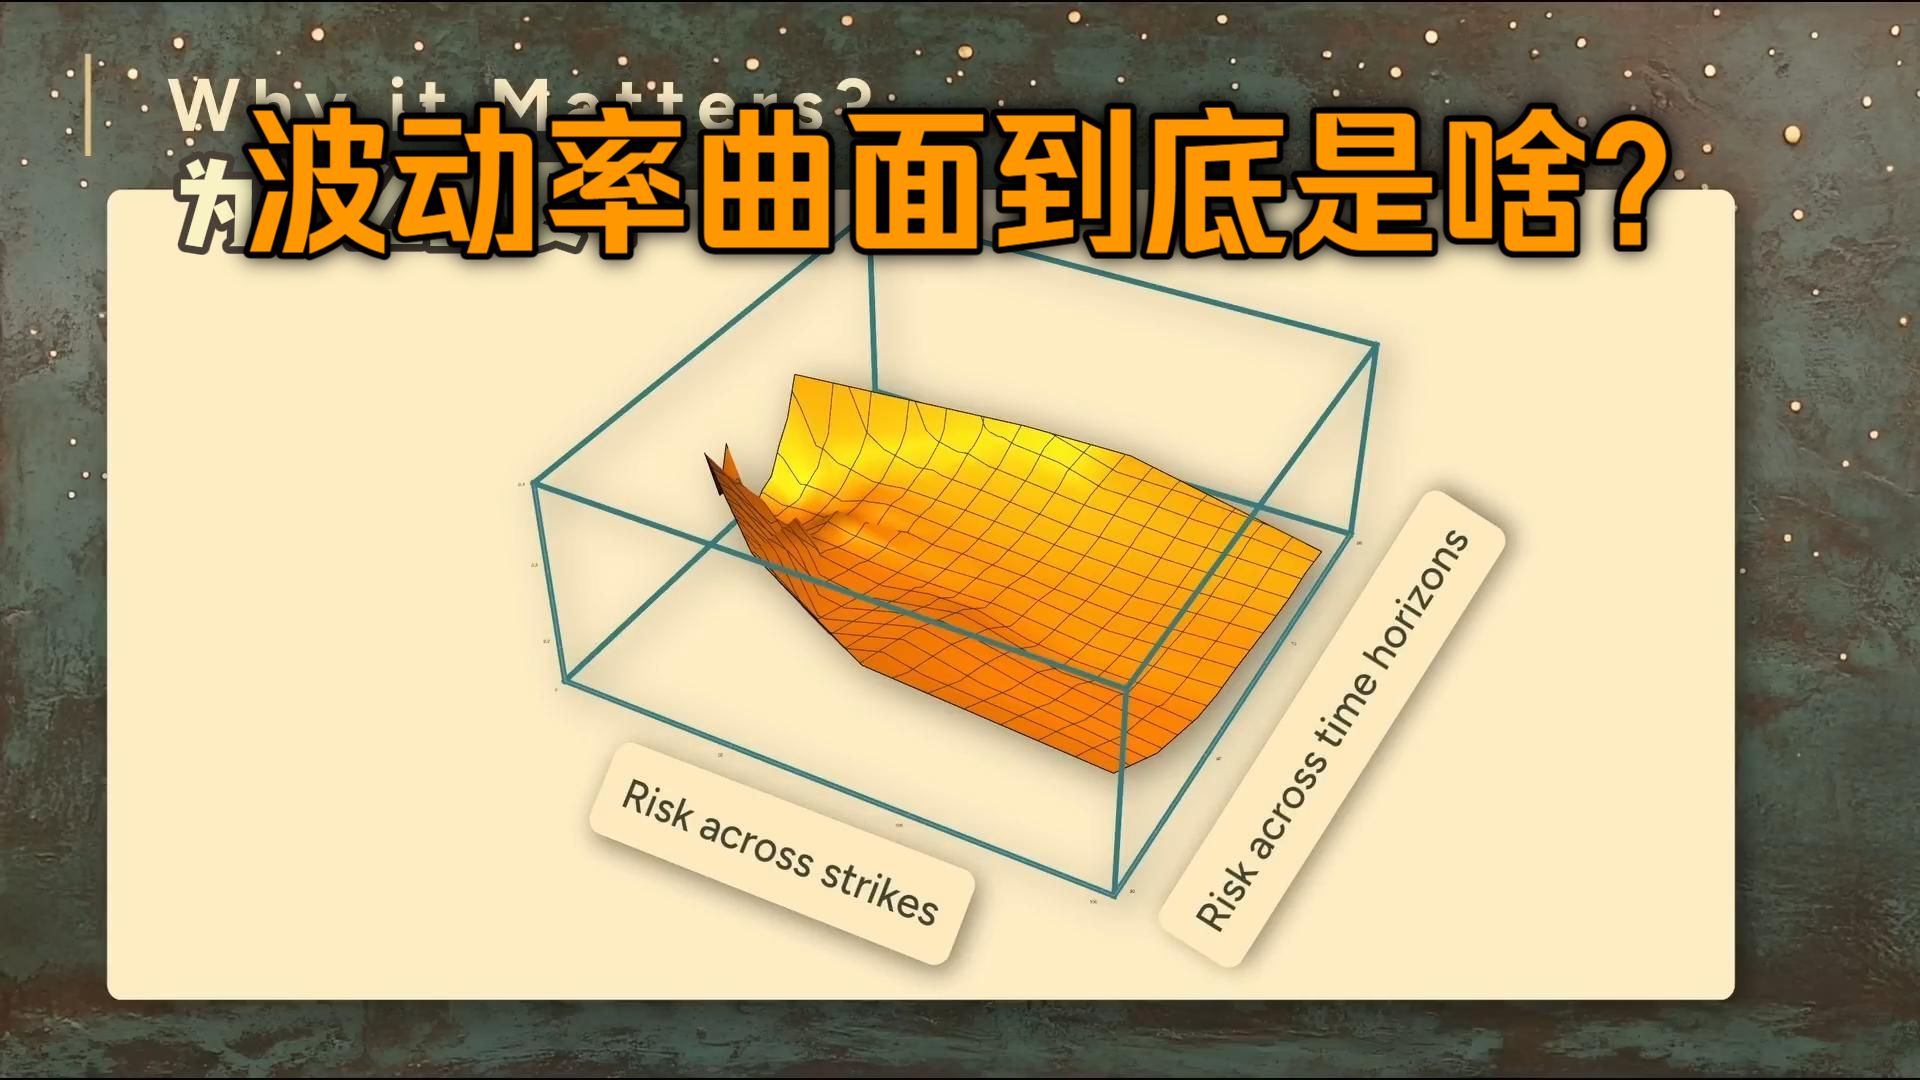
你可以把波动率曲面想成一张不断变形的地图,横轴是执行价,纵轴是到期时间,高度是隐含波动率,期权报价不是线性的,它依赖这张地图。

- 标的价格变动,所有合约的虚实值状态跟着变。
- 剩余时间缩短,临近到期合约的 Vega、Gamma 会快速变化。
- 做市商要持续报价,交易所公开规则也要求对指定合约维持双边报价。
- 风控要算希腊值、场景损益、保证金占用,底层都指向曲面。
所以行情一跳,不是改一个价格,而是触发一串计算。
算力峰值来自哪几层
峰值不是单一模块造成的,它通常叠加在四层:
- 合约数量:一个 ETF 期权标的常有几十到几百个合约,多个到期月同时活跃。
- IV 反解:每个合约都要从价格反推隐含波动率,牛顿迭代、二分法、初值敏感。
- 曲面拟合:SVI、SSVI、三次样条、局部波动率,还要做无套利约束。
- 希腊值与风控:Delta、Gamma、Vega、Theta,加上压力测试和保证金试算。
这些任务单独看都不算重,但行情快照批量到达时,它们会在几毫秒内挤在一起。
为什么平均负载不高,峰值却顶满
开盘集合竞价、大单成交、到期日、宏观数据发布,都会让行情突发放量,标的价格快速跳动,IV 初值偏差变大,迭代次数上升,曲面重校准频率也跟着上升,业内专家指出,低延迟系统最怕的不是平均延迟,而是尾部延迟和瞬时排队,峰值一旦顶满,排队会从计算线程传到网卡、内存和报价网关。
期权行情波动率曲面计算延迟高怎么办
从行情到曲面的完整链路
- 网卡收包,硬件时间戳打标。
- 行情解码,区分标的、期权、期货和组合。
- 合约过滤,只留做市和风控需要的合约。
- 标的价格对齐,处理快照不一致。
- IV 反解,批量计算隐含波动率。
- 曲面拟合,加无套利约束。
- 希腊值计算,输出给报价和风控。
- 报价发布,同时更新内部风险限额。
每一步都能并行或流水线化,关键是别让一个慢步骤卡住整条链路。
可落地的优化动作
- 网卡调优:
ethtool -L ens1f0 combined 8,开启 RSS,把中断绑到不同核。 - 内核旁路:DPDK、Solarflare Onload、RDMA,减少协议栈开销。
- 绑核与 NUMA:
taskset -c 2-7 ./md_gateway,numactl --cpunodebind=0 --membind=0。 - 共享内存:行情快照只写一次,多个计算进程只读,减少拷贝。
- 热启动:用上一次曲面作为本次 IV 迭代初值,缩短收敛时间。
- 分片:按到期月、执行价区间拆分,分别拟合再拼接。
- GPU 批处理:
CUDA_VISIBLE_DEVICES=0 ./vol_surface --batch 4096,一次算大量合约。 - 无套利投影:拟合后检查蝴蝶套利、日历套利,不满足就投影修正。
- 监控命令:
perf stat -e cache-misses,nvidia-smi topo -m,ethtool -S。
CPU、GPU、FPGA 怎么选
| 方案 | 强项 | 弱项 | 适合场景 |
|---|---|---|---|
| CPU | 低延迟、分支灵活、单合约快 | 并行有限、内存带宽易满 | 做市报价、风控、增量计算 |
| GPU | 批量 IV、曲面网格、并行拟合 | PCIe 传输、内核启动有开销 | 全市场曲面、盘后重算、压力测试 |
| FPGA | 确定性低延迟、流水线稳定 | 开发难、算法灵活度低 | 极低延迟网关、固定算法流水线 |
多数团队不会只选一种,常见组合是 CPU 负责行情接入和报价,GPU 负责批量 IV 和曲面网格,FPGA 放在最前置的收包和过滤环节。
常见坑
- 只堆核心数,忽略 NUMA 跨节点访问。
- 只上 GPU,忽略 CPU 预处理和 PCIe 搬运。
- 只算 IV,不做无套利检查,曲面一抖报价就乱。
- 日志、监控、行情回放抢关键核。
- 没有峰值回放测试,上线后才遇到开盘洪峰。
上海量化团队如何配置波动率曲面计算算力
机房与网络
上海本地团队通常看三类位置:交易所周边托管、上海本地数据中心、云上上海可用区,物理距离影响微秒级延迟,做市和低延迟套利更看重托管,双路网络、PTP 时钟、硬件时间戳是基础,据交易所公开规则,做市商需要持续报价,托管和低延迟网络不是可选项。
硬件配置思路
- CPU:高主频、大 L3 缓存、足够 PCIe 通道,关键核少跑杂活。
- 内存:多通道低延迟内存,容量覆盖曲面缓存和行情快照。
- GPU:中高端数据中心卡,关注显存、FP32/FP16 和 PCIe/NVLink 拓扑。
- 网卡:低延迟万兆、25G 或 100G,支持硬件时间戳和多队列。
- 存储:NVMe 放日志、回放数据和模型文件。
- 电源与散热:按峰值功耗预留,别让降频吃掉延迟。
软件与运维
- 内核旁路、RDMA、共享内存优先。
- 容器绑核,关闭节能模式。
- 曲面版本灰度发布,保留回滚。
- 回放行情注入峰值,测尾部延迟。
- 关键路径避免跨 NUMA 访问。
国内期权波动率曲面计算服务器价格对比
自建服务器价格区间
- 入门级:几万元,适合研究、低频回测、小规模曲面。
- 主流低延迟:十几万到几十万元,适合做市、期权行情计算。
- 高端配置:几十万元以上,多 GPU、FPGA、托管和冗余网络。
- 价格受 CPU、GPU、网卡、内存、机位和带宽影响。
云服务器与托管
- 云上按小时或按月计费,弹性好,适合回测、突发算力和临时扩容。
- 托管要算机柜、电力、带宽、运维和现场支持。
- 长期高负载下,自建或托管更可控;短期项目云上更灵活。
- 国内不同地域价格有差异,上海、深圳等金融节点通常更高。
价格对比要看总拥有成本
硬件标价只是开头,网络、电力、运维、机会成本、故障损失都要算,行业共识认为,期权做市的竞争力更多来自延迟稳定性和风控,不是单看服务器标价。
波动率曲面计算把期权行情算力顶到峰值常见问题
波动率曲面计算一定需要 GPU 吗
不一定,单标的、少量合约、低延迟报价,CPU 绑核加增量计算往往够用,全市场、多到期、多执行价、频繁重校准,GPU 批处理更有优势,关键是数据搬运和内核启动是否成为新瓶颈。
为什么开盘时算力峰值最明显
开盘前积压订单和行情集中释放,标的价格快速变化,IV 初值偏差大,迭代次数上升,曲面拟合和无套利检查同时触发,CPU 缓存和内存带宽被争抢,把热启动、分片和限流做好,峰值会平滑不少。
期权行情波动率曲面计算延迟高怎么办?先查哪三个指标
先查网卡丢包和排队、CPU 每核利用率与上下文切换、GPU 传输和内核耗时,用 ethtool -S、perf stat、nvidia-smi topo -m 定位,多数情况下,延迟不在计算本身,而在数据搬运、锁竞争和 NUMA 跨节点访问。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761785.html