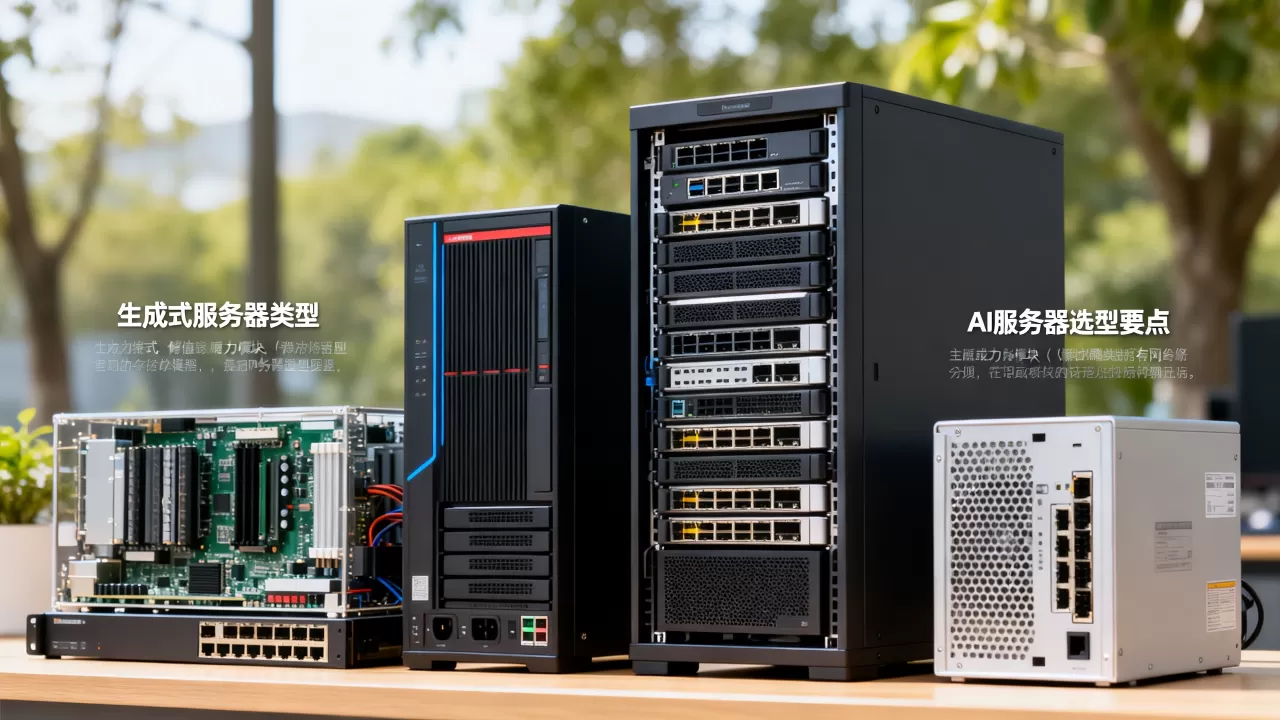
生成式服务器是专门为训练和运行生成式AI模型设计的高性能计算机,按用途可分为训练型、推理型和边缘型三大类,选型核心看GPU算力、显存容量和互联带宽。
生成式服务器有哪些分类?先看清这三条技术路线
训练型生成式服务器:为“炼大模型”而生
训练型生成式服务器的目标很纯粹,就是让模型在短时间内吃下海量数据,这类服务器通常采用机架式多GPU结构,把多张高性能GPU通过NVLink或InfiniBand高速互联,组成一张算力网,常见配置是8卡甚至更多GPU,配套大容量内存和高性能存储。

- 核心特征:多卡并行、高带宽互联、高功耗。
- 适用场景:大模型预训练、领域微调、RLHF强化学习。
- 典型代表:浪潮信息、新华三、华为昇腾的8卡机架式服务器。
训练服务器的压力不只在GPU,还在网络,模型并行时,每卡之间的通信延迟直接决定训练效率,所以选训练型机器,别只盯GPU型号,还要看卡间互联是否走NVLink,以及是否支持RDMA网卡。
推理型生成式服务器:把模型变成可用服务
推理型服务器负责把训练好的模型跑起来,比如聊天机器人、AI绘画、代码补全,它对单卡算力要求没那么极致,但更看重显存带宽和响应速度,因为用户等着出结果。
- 核心特征:单卡或双卡为主,显存容量大,延迟低。
- 适用场景:在线API服务、企业内部知识库、客服助手。
- 典型配置:一张NVIDIA L40S或A100,搭配充足CPU内存。
推理服务器不需要像训练机那样疯狂的卡间互联,但需要预留足够的显存给KV Cache和并发请求,并发量高的业务,还需要搭配多卡负载均衡。
边缘生成式服务器:本地化部署的“小钢炮”
边缘型生成式服务器是近两年才热起来的形态,它把生成式AI能力塞进塔式工作站或紧凑机箱里,部署在办公室、门店、工厂等非机房环境。
- 核心特征:体积小、噪音低、功耗相对温和。
- 适用场景:隐私敏感的数据处理、离线生成任务、边缘质检。
- 典型配置:一张RTX 4090或L40S GPU,风冷散热。
这类服务器最大的价值是数据不出内网,医疗、金融、政务等对数据合规要求高的项目,往往首选边缘型方案。
生成式AI服务器哪家好?这四类厂商值得对比
这个问题没有标准答案,但可以从厂商背景、硬件生态、服务支持三个维度拆开看。
国产全栈厂商:浪潮信息与华为昇腾
浪潮信息在AI服务器市场耕耘多年,其8卡旗舰机型是国内大模型训练场的主流选择,华为昇腾则走国产算力路线,配套自研MindSpore框架,在政企市场占有率稳步上升。
- 优势:国内交付能力强,售后响应快。
- 适配注意:昇腾方案需要迁移模型代码,和NVIDIA CUDA生态不完全兼容。
传统国际厂商:戴尔、超微、惠普
戴尔PowerEdge系列和超微服务器在海外市场广泛使用,堆料扎实,BIOS和远程管理工具成熟,适合有自建机房、预算充足且需要品牌质保的团队。
- 优势:硬件成熟度极高,兼容性好。
- 劣势:价格通常高于白牌机,交货周期可能更长。
白牌定制商:灵活但需要专业能力
国内有不少服务器定制商,可以按需求选主板、外壳、电源、GPU数量,同样预算下能堆出更高配置,但没有原厂调优和压力测试,需要自己承担更多运维风险。
- 优势:同配置价格可能比大品牌低20%-30%(模糊表述)。
- 劣势:驱动兼容性、散热设计可能需要自己验证。
云厂商的计算型实例:不需要买实体机
如果你不想碰服务器硬件,简米云、酷番云、火山引擎等提供的GPU裸金属实例也算一种“服务器”,它们底层仍是生成式服务器,但以按小时租用的方式交付。
- 优势:弹性伸缩,无需机房运维。
- 劣势:长期高频使用成本会高于自购。
行业共识认为,选生成式AI服务器时应优先考虑生态兼容性,而不是单纯堆硬件,先确定你的模型框架是否支持对应GPU,再谈性价比。
大模型推理服务器配置怎么选?从7B到70B的实操建议
先估算模型要占多少显存
显存是生成式服务器最硬的门槛,模型推理时,权重要完全加载进显存,再加上输入输出的中间变量和KV Cache,实际占用往往比模型参数体积高出不少。
- 7B模型(FP16精度):权重约14GB,推理时通常需要20GB以上显存,单张RTX 4090(24GB)够用。
- 13B模型:建议准备40GB以上显存,可以选一张A100 40GB或两张RTX 4090。
- 70B模型:权重约140GB,单卡跑不下,需要多卡并行,常见方案是4至8张80GB显存的GPU,总量要超过300GB。
根据经验,显存容量按模型参数量的两倍准备是相对稳妥的起点,然后再留出10%-20%余量。
不同量级的配置清单
这里给出一套可直接落地的参考模板:
- 7B模型并发量小:1张RTX 4090,128GB内存,1TB NVMe SSD。
- 13B模型并发量中等:1张A100 40GB或2张RTX 4090,256GB内存,2TB NVMe SSD。
- 70B模型并发量较高:4至8张A100/H100 80GB,512GB内存,系统盘与数据盘分离。
训练服务器和推理服务器的配置侧重差异
训练服务器看重GPU间的通信速度,所以多卡互联是重点,推理服务器看重显存容量和总吞吐,单卡性能反而没那么敏感,预算有限时,可以优先把显存堆大,而不是追求最强GPU。
部署完成后如何验证配置够用?
在实际运行环境里验证,比看参数靠谱,以vLLM框架为例:
- 用
nvidia-smi查看多卡显存是否被均匀分配。 - 启动推理服务后,观察单token生成耗时和首token延迟。
- 逐步增加并发请求,看GPU显存和功耗是否触顶。
如果显存持续打满但GPU利用率偏低,瓶颈可能在CPU内存带宽或磁盘IO,而不是GPU。
GPU服务器租赁价格与自购成本怎么算?生成式服务器多少钱
自购生成式服务器的成本构成
自购一台生成式服务器的支出远不止硬件本身,还包括机房机柜、电力、散热、运维人力。
- 入门级工作站:配RTX 4090,总价在几万元区间。
- 企业级8卡服务器:配A100/H100,总价往往达到数十万元甚至更高。
- 国产昇腾方案:起步价同样不低,但供应链更可控。
机架式服务器满载功耗可能超过4千瓦,机房必须保证制冷条件,长期7×24运行的电费也是一笔不小的开销。
GPU服务器租赁价格怎么估算
云厂商的计费模式五花八门,但核心逻辑是按实例规格和时长收费:
- 按小时租用:适合短期跑模型微调或突发任务。
- 包月/包年预付:长期使用单均价更低。
- 竞价实例:适合不追求稳定性的批量推理任务,价格可显著降低。
需要注意的是,云租赁通常不包含存储和带宽费用,这些额外项目会让最终账单比报价高,自购则省不掉电费,但硬件折旧后还有残值。
对比表格:自购与云租赁
| 维度 | 自购 | 云租赁 |
|---|---|---|
| 初始投入 | 高,一台几十万 | 低,按小时起租 |
| 运维负担 | 自己负责硬件故障 | 服务商负责底层 |
| 长期成本 | 稳定使用时摊薄较快 | 长期使用总价偏高 |
| 数据安全性 | 完全自主可控 | 依赖云服务商条款 |
| 弹性扩容 | 需要提前采购 | 分钟级扩缩容 |
对大多数中小团队来说,前期先用云租赁验证业务,再在有长期需求后考虑自购,是比较理性的路径。
生成式服务器选型最怕走弯路,记住这三个原则
第一,先定场景再选硬件,训练、推理、边缘部署对服务器的要求完全不同,混着谈配置很容易被销售带偏,第二,显存决定能不能跑,互连决定跑多快,预算再紧,也别在显存上省,第三,自购和租赁不是对立关系,而是不同阶段的工具,业务没稳定前,租;业务规模化后,买。
生成式服务器的市场还在快速进化,但底层逻辑不变:用算力换智能效率,只要把模型量级、并发需求和预算边界想清楚,你就能找到属于自己的那台机器。
生成式服务器常见问题答疑
生成式服务器和普通服务器有什么区别?
普通服务器主要服务数据库、Web应用、企业ERP,强调CPU性能、内存容量和存储可靠性,生成式服务器则围绕GPU构建,核心硬件从CPU转向GPU,并且额外需要高带宽显存、卡间互联和专门散热设计,如果只是跑传统业务,普通服务器就够了;要跑生成式AI,普通服务器的算力完全不够用。
本地部署生成式服务器需要准备哪几步?
第一步,确定模型规模和预期并发数,推算出所需显存总量,第二步,选定服务器形态,机架式还是塔式,并预留电源余量,第三步,安装CUDA、PyTorch、vLLM等基础环境,第四步,下载模型权重,启动推理服务做压测,整个过程需要一定的Linux运维能力,否则建议直接选云上托管方案。
一台生成式服务器可以同时跑多个模型吗?
可以,只要显存足够,就能在同一台服务器上部署多个不同模型,通过容器或进程隔离方式共享GPU资源,实际操作中,需要为每个模型分配独立的显存区间,并控制总并发数,避免内存溢出,生产环境通常会用NVIDIA MIG或Kubernetes集群来做资源切片。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761854.html