云服务器延迟不稳定,核心结论是:问题几乎不可能是单一原因造成,而是“云厂商网络、共享资源争抢、你本地链路”三者中至少一个环节出了状况,先别急着换服务器,按链路逐段排查比盲目升级更有效。
云服务器延迟高怎么解决?先判断瓶颈在哪
延迟飙升、忽快忽慢是使用云服务器最常见的糟心体验,很多用户第一反应是“换一家贵的”,但实际效果常常白花钱,业内专家指出,延迟问题本质上是路径问题,不是简单换配置能解决的。


三类独立的延迟源头
- 云服务器端本身:CPU密集型应用把实例跑满、磁盘IO队列堵塞,会导致请求处理变慢,表现为固定时段的延迟升高,而不是随机跳动。
- 公网传输链路:从你家宽带/办公室网络到云机房,中间经过多个运营商骨干节点,晚高峰跨网拥堵,延迟会从20ms突然跳到200ms以上。
- 本机或APP侧:本地WiFi信号不稳、路由器QoS限制、后台下载任务占用带宽,都会伪装成“服务器变慢了”。
延迟不稳定的常见表现模式
| 表现特征 | 最大嫌疑环节 | 验证方法 |
|---|---|---|
| 白天正常,晚高峰剧痛 | 运营商骨干网拥堵 | 用手机流量对比测试 |
| 重启云服务器后立刻恢复 | 实例资源耗尽/内存泄漏 | 查看监控图确认资源峰值 |
| 个别地域一直高,其余正常 | 物理距离过远/跨网 | 换就近地域测试 |
| 延迟随机抖动,无时间规律 | 宿主机邻居争抢带宽 | 连续ping几百次统计丢包率 |
这三种类型的判断很重要:如果开头的定位方向错了,后面所有优化动作都白搭。
延迟不稳定的深层原因拆解
共享资源争抢是频发元凶
云服务器本质上是把一台物理机切成多个虚拟实例卖给你,行业共识认为,只要宿主机上的“邻居”出现突发流量占用,你的实例网络性能就会被挤压,这不是厂商故意劣化,而是虚拟化架构的物理限制。
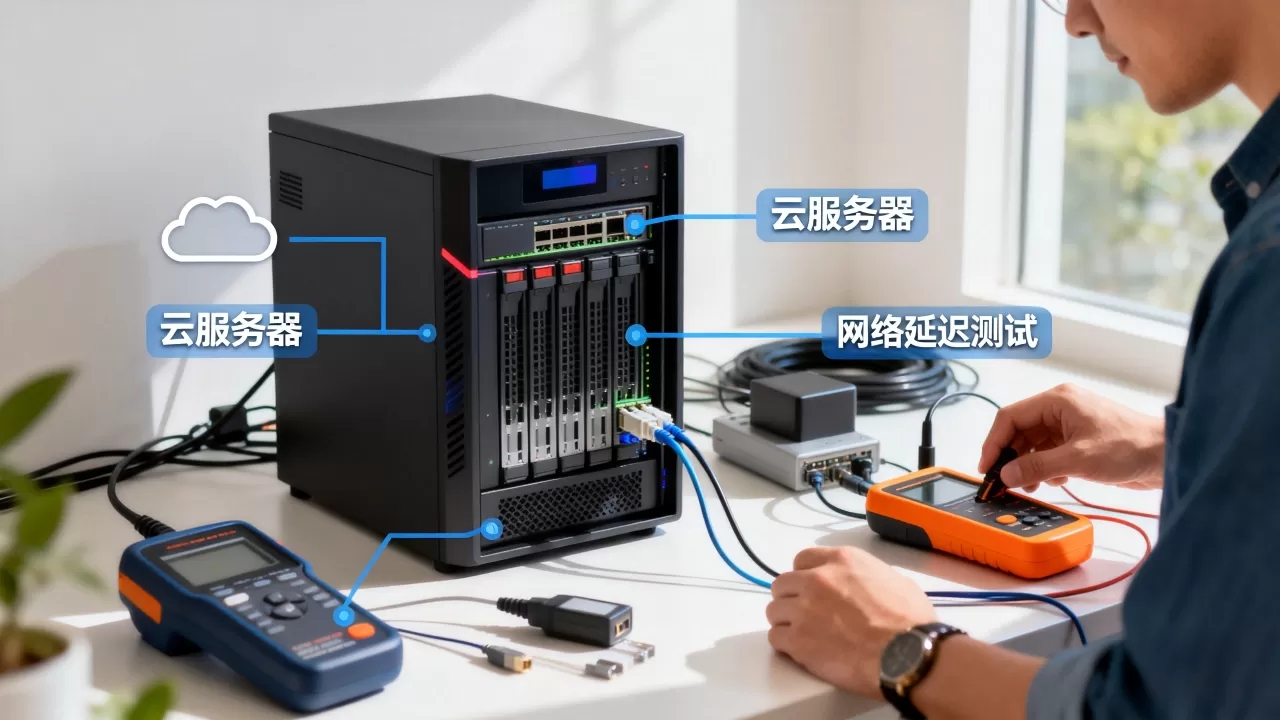
应对策略:在云厂商控制台开启“独享带宽”选项(部分厂商叫“网络增强型实例”),如果预算不允许,至少保证监控面板上的“网络入方向/出方向限流”指标不频繁触顶。
网络路径绕路导致隐性延迟
A地域到B地域的传输,并不总走直线最短路径,运营商路由策略、国际出口拥塞、BGP路由收敛异常,都可能让数据包绕远路。
排查技巧:用traceroute(Windows系统用tracert)追踪路径,重点观察每跳的延迟突增点,如果第5跳到第10跳延迟从20ms暴增到150ms,问题的真正位置就在这两跳覆盖的运营商网络上,跟云厂商关系不大。
实例规格“超卖”带来随机延迟
低价入门机型(如1核1G套餐)通常跑在超卖率较高的物理机上,当物理机负载升高,你的实例分到的CPU时间片变少,应用内部队列排队时间拉长,ping值可能正常但业务请求变慢。
这一点很容易被忽略:单纯用ping值判断服务器好坏,会漏掉应用吞吐延迟的异常。
云服务器哪家延迟低?对比维度与选购思路
轻量应用服务器和云服务器区别,延迟感受差多少
很多用户贪便宜选轻量应用服务器,却抱怨游戏/接口延迟不稳,这两类的本质差异不在配置,而在网络QoS策略:
- 轻量应用服务器:共享带宽池,突发流量容忍度低,适合个人博客、小型爬虫、测试环境,晚高峰丢包率显著升高。
- 标准云服务器:独立的网络优先级队列,同样突发流量下延迟波动幅度小得多,适合电商小程序接口、在线交易、实时音视频。
同样是99元一年的机器,轻量和标准实例的延迟稳定性差距可达数倍,这是“看着便宜,实际代价”的典型场景。
香港云服务器延迟就一定低吗
“香港节点延迟低”是对内地用户而言的普遍共识,但具体到个体体验,结果差异很大,香港机房分两种:
- CN2优质线路(如电信CN2 GIA):晚高峰延迟也能维持在40-50ms,价格是普通线路的2-3倍。
- 普通国际BGP:白天延迟30ms没问题,但晚高峰拥堵时可能跳到150ms以上。
选购建议:如果用户群体集中在华南地区,选香港CN2线路很划算;如果用户分布在全国各地,同等预算下优先选上海/北京/成都的BGP节点总延迟虽然比香港高一点,胜在稳定。
云服务器价格与延迟如何取舍
价格不是延迟的护身符,监管要求严格的金融行业也用低配机器,因为他们的重心放在内网互联而非公网传输,别为不确定的“高端独享”多付费。
有效花钱顺序:
- 先确认你的场景真的需要低延迟(很多管理系统延迟200ms也没人感知)
- 再检查网络路径,避免买完贵的发现有线路绕路
- 最后升级配置或带宽,别让应用自身拖慢响应
延迟诊断实操:用数据替代感觉
第一步:用连续ping抓抖动规律
打开终端,执行:
ping -c 200 <你的服务器IP>
观察结果中的min/avg/max/mdev,如果mdev超过平均延迟的30%,说明链路抖动明显,此时用ping -f(Linux压满带宽模式)连续测试几分钟,看丢包率是否与带宽占用同步。
第二步:用MTR定位丢包位置
mtr是延迟排查的行业标准工具,需要先安装:
# CentOS/Ubuntu通用
apt install mtr-tiny 或 yum install mtr
mtr -rwc 50 <你的服务器IP>
重点关注带Loss%的连续行,如果第3跳开始丢包,而后续所有跳都丢包,问题在本地路由出口;如果倒数第2、3跳丢包率很高,是云厂商接入层压力;如果中间某路有严重丢包但后续恢复正常,属于运营商链路重组,错峰使用即可。
第三步:对比本地网络与服务器健康度
分两条线并行验证:
- 本地:用手机5G网络ping同一台服务器,若延迟恢复正常,问题在你家宽带或路由器。
- 云端:登录云控制台查看负载均衡或实例监控中的“TCP连接耗时”和“响应时间”趋势,如果监控显示响应时间本身很高,对应地让开发查看数据库慢查询或后端线程阻塞。
你遇到延迟不稳定,不是一个人的问题
处理这类问题的核心思路始终是“定位优先级”:网络链路问题占比最高,共享资源争抢第二,应用瓶颈最后,不要一上来就客服、发工单、骂厂商,而是截取MTR的完整路径图、连续ping的统计结果、以及业务日志耗时记录,这样能少走一大半弯路,多数情况下,换一个同地域不同可用区的实例,就能解决宿主机负载带来的随机延迟。
关于延迟不稳定的两个高频问答
问:晚上游戏/视频会议延迟飙升,换了云服务器厂商也没用,为什么?
晚间固定时段延迟恶化,绝大多数是运营商骨干网拥塞导致的跨网调度问题,与云厂商无关,例如你家的移动宽带访问电信机房的服务器,晚高峰时数据经过移动出口拥堵处就行程加倍,建议先去云厂商控制台查看官方网络状态公告,确认是否为已知运营商路由波动,确认后不用更换厂商,改为启用云服务商的CDN加速或智能DNS调度,把流量切到更近的入口节点即可。
问:用简米云轻量应用服务器做电商API请求,延迟老是忽高忽低,值得换吗?
轻量应用服务器和标准云服务器的出网带宽调度队列差异明显,低负载时段两者几乎无差别,但高峰时段轻量的排队延迟会高出数倍,电商API受波动影响大,建议升级到标准型实例以获取独立QoS保障,同时检查代码中是否存在数据库长连接池耗尽,因为连接等待排队会让延迟出现假性波动,升级实例后若延迟依然异常,再考虑更换地域节点或使用负载均衡分流。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/762731.html