在虚拟机里跑多个任务却频繁卡顿,核心解法是共享加速把宿主机的 CPU、GPU、内存通过虚拟化调度技术按需动态分配,让多台虚拟机在有限硬件上同时拿到各自需要的算力,从而提升多任务并行效率。
虚拟机共享加速原理是什么
共享加速不是简单的“切蛋糕”,它更像一个灵活的资源调度中心,虚拟化平台通过 Hypervisor 层把物理硬件抽象成资源池,再按每台虚拟机的实时需求动态分配计算单元,这个过程中没有哪台虚拟机永久占用某块硬件,所有资源都在高速流转中被他用,最终实现整体效率的提升。
CPU资源共享调度
CPU 共享的核心是时间片轮转机制,虚拟机管理程序(VMM)把物理 CPU 的每个核心拆成多个虚拟 CPU(vCPU),通过比例权重和时间片分配,让不同虚拟机轮流使用物理核心,一台虚拟机在做文件压缩,另一台在跑数据库查询,两者可以用同一颗物理核心交替计算,彼此感知不到对方的存在。
关键在于CPU 调度器的优先级策略,多数虚拟化平台默认启用“核数超配”,比如一台 8 核宿主机可以跑 16 个 vCPU 的虚拟机集群,超配比例需要控制在一个合理区间,行业共识认为生产环境超配比不宜超过 1.5 倍,否则会出现严重的计算饥饿,调优上建议为关键虚拟机设置 CPU 预留(Reservation)和份额(Shares),保证高优先级任务优先拿到计算时间片。
内存共享与去重机制
内存是另一个共享加速的核心维度,虚拟机之间常常加载相同的操作系统内核、公共库文件和应用框架,这些重复数据如果各自存一份,物理内存很快耗尽,虚拟化平台通过透明页共享(TPS)或内核同页合并(KSM),自动识别重复内存页并合并为单一物理副本,多台虚拟机只读共享这份数据。
十台运行 Windows Server 的虚拟机,如果系统页面完全一致,KSM 可以显著压缩内存占用,实测场景中,同类虚拟机的内存利用率往往能提升 3 到 5 倍的密度,写操作发生时,平台会通过“写时复制”机制把对应页面重新拆分为独立副本,不影响数据安全,搭配内存气球(Balloon)驱动,宿主机可以在内存吃紧时主动回收空闲虚拟机的内存,转给正在峰值运行的虚拟机使用。
GPU 虚拟化共享加速
GPU 共享加速近年来成为多任务并行场景的重点,常见的实现方式有三种:
- vGPU(虚拟 GPU)模式:把物理 GPU 的显存和计算单元划分为多个实例,每个虚拟机独立使用一个切分后的虚拟 GPU,NVIDIA GRID / vGPU 技术就属于这一类。
- API 转发模式:宿主机安装图形驱动,虚拟机的图形指令通过虚拟化层转发到底层物理 GPU 执行,VMware 的 vSGA 就是典型。
- 硬件辅助虚拟化

:基于 SR-IOV 技术,物理 GPU 直接提供多个虚拟功能接口,虚拟机绕过 Hypervisor 直接访问硬件,性能非常接近物理设备。
多任务并行效率提升的实际体验
虚拟机共享加速带来的效率提升,不是理论数字,而是实实在在的使用体验变化,开发者、设计师、运维工程师在日常工作中最能感受到这种差别。
多开安卓模拟器与测试集群
做移动应用测试的团队经常需要同时开几十个安卓模拟器,每个模拟器都是一台独立虚拟机,不同步共享加速时,模拟器启动像排队打饭,越往后越慢,开启共享加速后,CPU 和内存的重复页面被合并,GPU 渲染指令被聚合转发,模拟器可以并行启动,批量执行自动化测试脚本。
保证并行效率的操作建议:
- 为每台模拟器分配至少 2 个 vCPU 和 2GB 内存,避免太小导致频繁换页。
- 开启嵌套虚拟化(Nested Virtualization),让模拟器内部的安卓系统能正常使用硬件加速。
- 对 GPU 执行 vGPU 切分,每台模拟器分配一块独立显存区域,保证界面渲染流畅。
- 使用共享存储(如 NFS 或 iSCSI),避免镜像文件拷贝抢占本地磁盘 I/O。
视频渲染与编译构建任务
视频后期团队常用虚拟机做渲染农场,编译团队则用虚拟机跑 CI/CD 构建节点,这类任务的显著特点是:CPU 利用率瞬间拉满、持续高负荷运转、等待时间就是成本,共享加速在这里的价值是时间片弹性伸缩打包任务没有运行时,虚拟机几乎不占资源,一旦构建任务启动,资源池会迅速响应,把空闲算力集中供给。
要让渲染编译效率最大化,建议将 vCPU 数量设置为物理核心数的整数倍,并在虚拟化平台中启用 CPU 热添加,同时把磁盘镜像放在 NVMe 固态存储上,因为编译过程中产生的大量中间文件需要高速读写支撑,否则 CPU 再快也会卡在磁盘等待上。
多个轻量级业务系统并行
不少中小企业在同一台服务器上跑着官网、ERP、ERP 测试环境、文件服务器等多套系统,虚拟机共享加速让这种“一机多用”变得更加从容,内存去重让多套 Linux 系统共享公共库,CPU 超配让空闲系统让出算力给忙碌系统,不用为每套系统单独采购物理服务器,硬件成本和电力成本直接压缩。
虚拟机GPU直通与共享区别在哪里
GPU 直通(Passthrough)和 GPU 共享是两种完全不同的资源分配哲学,很多人混淆了这两者的使用场景,导致虚拟化集群性能达不到预期。
| 对比项 | GPU 直通 | GPU 共享(vGPU / API 转发) |
|---|---|---|
| 分配粒度 | 整张物理 GPU 独占给一台虚拟机 | GPU 按比例切分给多台虚拟机 |
| 驱动要求 | 虚拟机内安装官方显卡驱动 | 需要虚拟化定制版驱动 |
| 多开能力 | 一张卡只能服务一台虚拟机 | 一张卡同时服务多台虚拟机 |
| 性能损耗 | 基本接近物理机性能 | 有调度转发开销,但可用性提升 |
| 典型场景 | 深度学习训练、3D 建模渲染 | 虚拟桌面(VDI)、多开模拟器 |
| 成本与复杂度 | 配置简单,但硬件利用率低 | 需要许可证支持,配置较复杂 |
结论很明确:单台虚拟机需要极致图形性能时选择直通,追求多任务并行密度时选择共享,如果你跑的是三维动画渲染或 AI 模型训练,单卡直通能让显卡火力全开;如果你需要 20 个人同时使用不同的虚拟桌面办公,共享模式才是正解。
虚拟机共享GPU加速设置怎么操作
不同虚拟化平台的操作路径有差异,核心逻辑是相通的,以常见的场景为例,给出实际操作步骤。
VMware ESXi 平台的 vGPU 配置
首先确认物理 GPU 型号支持 vGPU 虚拟化(NVIDIA 的 GRID 系列或 AMD 的 MxGPU 系列),并在 BIOS 中开启 SR-IOV 和 VT-d 功能,然后执行以下步骤:
- 在 vSphere Client 中,导航到“主机” -> “管理” -> “硬件” -> “PCI 设备”。
- 将对应 GPU 标记为“直通”状态,用于后续创建 vGPU 配置文件。
- 安装 NVIDIA vGPU 宿主机驱动包,运行
nvidia-smi确认 GPU 可见。 - 在虚拟机的“编辑设置”中添加“PCI 设备”,选择 GPU 配置文件(GRID P4-4Q、P4-1Q 等不同显存规格)。
- 启动虚拟机,在机内安装对应的 NVIDIA vGPU 驱动,完成。
Proxmox VE 与 KVM 的 mdev 共享配置
Proxmox VE 底层基于 KVM,支持介质设备(mdev)方式共享 GPU,操作路径如下:
- 编辑
/etc/default/grub,修改GRUB_CMDLINE_LINUX_DEFAULT,加入intel_iommu=on或amd_iommu=on,然后执行update-grub重启宿主机。 - 安装 GPU 厂商的虚拟化驱动,利用
nvidia-smi vgpu命令生成 vGPU 类型实例。 - 编辑虚拟机配置文件
/etc/pve/qemu-server/VMID.conf,添加一行hostpci0: 01:00.0,把物理 GPU 的 PCI 地址映射进虚拟机。 - 将虚拟机配置文件中的
machine: pc-q35-保持默认,并在虚拟机内安装匹配驱动,即可识别。
实际操作时,需要关注设备 ID 的准确填写,在宿主机执行 lspci -nnk | grep -i vga 查看 GPU 的 PCI 编号和供应商 ID,配置时才能准确指向目标设备。
虚拟机并行处理速度慢怎么解决
共享加速配好了,实际运行中仍然可能出现并行处理变慢、资源争抢加剧的现象,多数情况下不是共享加速本身的问题,而是配置细节不到位。
排查资源争抢的关键路径
- 检查 CPU 就绪时间(CPU Ready):在 vSphere 中查看虚拟机性能图表,CPU Ready 值持续超过 5%,说明 vCPU 数量超标,物理核心供不应求,需要减少超配比例或迁移部分虚拟机。
- 检查磁盘 IOPS 与延迟:多台虚拟机同时启动会对后端存储产生瞬时高 I/O 压力,采用 SSD 或 NVMe 分层存储、配置存储 I/O 控制策略,能有效平滑访问峰值。
- 检查内存 Swap 情况:宿主机内存不足时,虚拟机被强制使用磁盘交换空间,性能断崖式下跌,监控主机内存回收指标,及时增加物理内存或降低单机资源分配。
- 检查网络队列中断:多网卡队列配合 vCPU 绑定到物理核心,能显著降低网络中断处理延迟,开启多队列 virtio-net 驱动,对高并发网络场景是关键优化项。
不同负载的调优方向
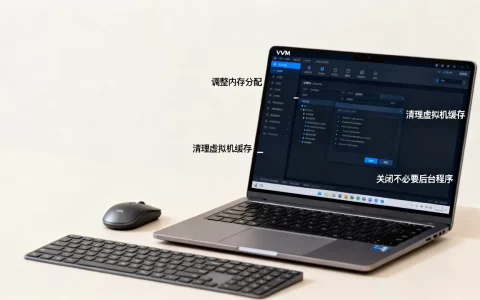
负载类型差异决定了优化路径不同,CPU 密集型任务(如数据计算、代码编译)应优先调高 CPU 份额,限制虚拟机数量和 vCPU 超配比;内存密集型任务(如 Java 应用、数据库缓存)建议启用内存预留,禁用透明页合并的扫描频率降低开销;图形密集型任务(如设计软件、视频剪辑)应确保 vGPU 显存分配足够,不要凭感觉切分过小片段。
共享加速的硬件选型建议
共享加速对硬件基础有一定要求,CPU 建议选用支持更多核心数的双路服务器,核心数越多,调度器越能灵活腾挪;内存容量按虚拟机总量预估后再增加 30% 的冗余;GPU 显存建议至少 16GB 起步,方便切分出更多可用的实例;存储阵列尽量选用全闪配置,让吞吐瓶颈不再成为并行效率的阻碍。
关于虚拟机共享加速的常见问题
虚拟机共享加速会不会拖慢宿主机?
会有一点调度开销,但对现代 CPU 和 Hypervisor 而言,损耗占比非常小,开启共享加速带来的资源利用率提升,远大于那一点调度损耗带来的负面影响。
虚拟化平台怎么选才能兼顾共享和多开?
vSphere 功能最全、企业管理友好但授权成本高,Proxmox VE 免费开源、社区活跃,适合中小型测试环境,Hyper-V 与 Windows 生态融合度强,适合微软技术栈团队,没有绝对最优平台,需要结合团队运维能力和预算做取舍。
共享 GPU 能跑大型游戏或者深度学习任务吗?
大型游戏推荐直通模式,共享模式下帧数会有较大损失,深度学习训练用共享模式效率不佳,因为算力切分后单任务吞吐降低;推理阶段的轻量负载用共享模式更划算,若明确需要训练模型,请优先选择直通或物理机。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/763182.html