中央服务器算法是运行在中心节点上、负责统一调度和数据处理的一组算法集合,重点解决负载均衡、任务排队、数据一致性和模型聚合问题。很多团队把“中央服务器算法”当成某个单一算法来搜,实际上它是一个工具箱,选型时先看业务场景,再看节点能力,最后才谈具体实现。
中央服务器算法有哪些类型?核心分类先看这里
负载均衡类算法
负载均衡是中央服务器最基础的算法阵营,负责把请求分发给后端节点,常见的有四种:
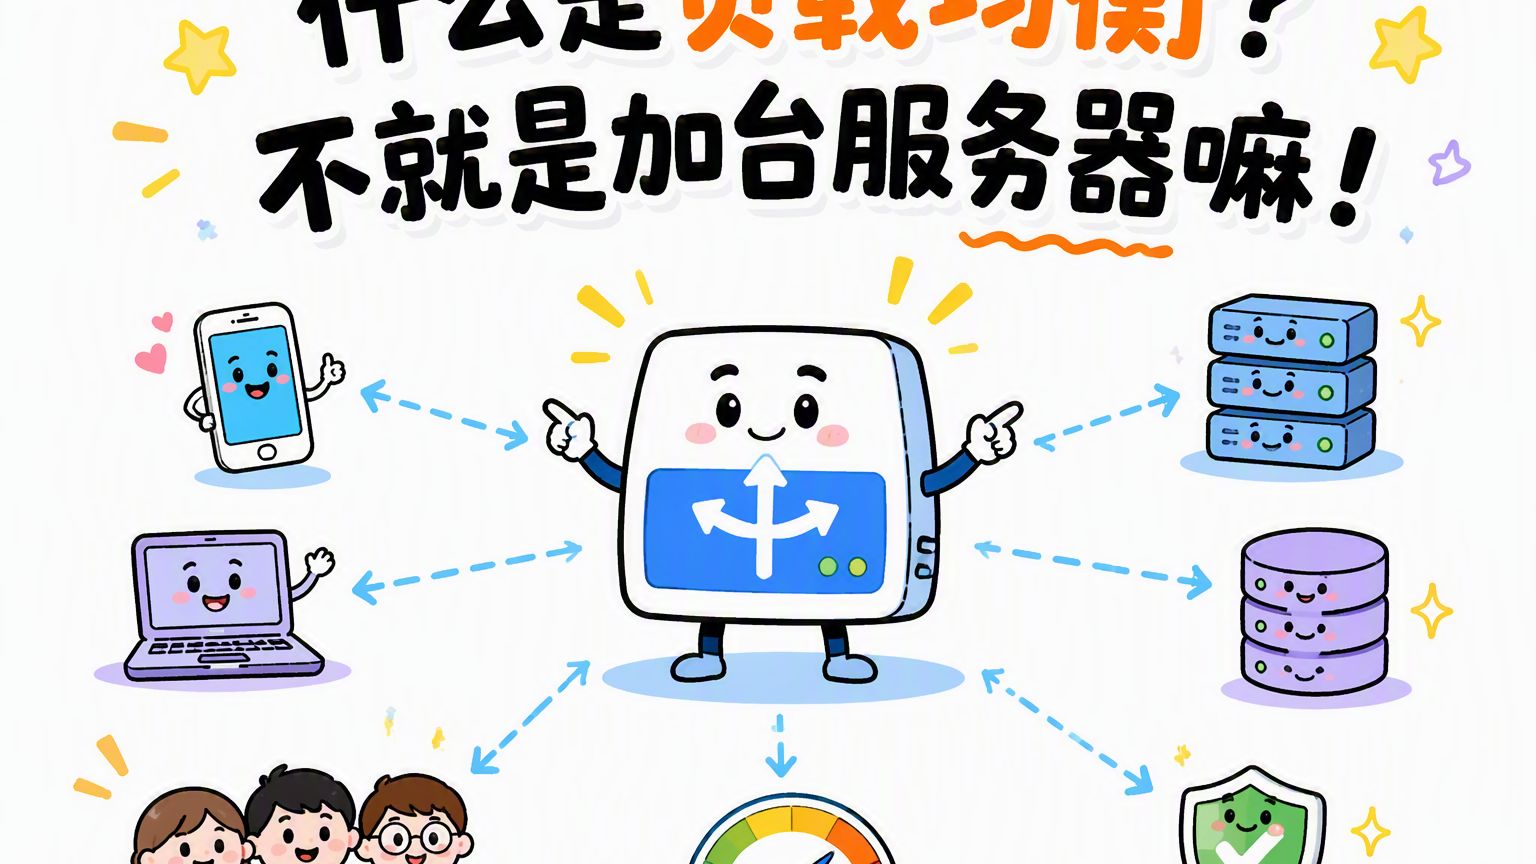
- 轮询算法(Round Robin):按顺序轮流分发请求,适合所有后端节点配置相近、请求处理时间差不多的场景。
- 加权轮询(Weighted Round Robin):给高配置节点更大的权重,避免低配节点被压垮。
- 最少连接算法(Least Connections):把新请求转发给当前活跃连接数最少的节点,适合长连接或请求耗时波动大的场景。
- IP Hash算法:根据客户端IP计算哈希值,映射到固定节点,用于需要会话保持的业务。
任务调度类算法
中央服务器不仅要分发请求,还要管理后台任务队列,常见算法包括先来先服务(FCFS)、短作业优先(SJF)、时间片轮转和优先级调度,在集中式任务队列中,短作业优先能明显降低平均等待时间,但容易让长任务长期得不到执行,实际部署时常需要配合优先级补偿机制。
数据一致性与共识算法
如果中央服务器需要同步数据到多个副本,就绕不开一致性算法。Paxos和Raft
是最常被提及的共识算法,ZAB则是ZooKeeper使用的原子广播协议,在这些算法中,中央服务器通常扮演Leader角色,负责接收写请求、复制日志、确认提交,行业共识认为,Raft比Paxos更容易工程落地,因此很多自研分布式系统首选Raft。
聚合与联邦学习算法
近年来,物联网和边缘计算场景开始把“中央服务器”当作聚合端。FedAvg(联邦平均算法)是最基础的聚合方式,中央服务器把各个边缘节点的模型参数做加权平均,再下发给下一轮训练。FedProx则在FedAvg基础上增加了近端项,解决数据分布不均匀时的模型漂移问题。
中央服务器负载均衡算法怎么选?看场景不看配置
网关型中央服务器的轮询场景
企业内部ERP系统,用户量稳定,后端节点都是同一批配置,直接用轮询最简单,Nginx里一行配置就能做到:
upstream backend {
    server 10.0.0.1;
    server 10.0.0.2;
}
这种场景不需要复杂算法,加了反而增加排查难度。
高并发下的最少连接场景
大促活动时,某个接口耗时突然变成800毫秒,其他接口只要50毫秒,这时候用轮询会不断请求把慢节点打满,改用最少连接,可以让新请求优先进入空闲节点,整体吞吐量会更稳。
带权重的加权轮询场景
混部集群里,老机器和新机器一起用,CPU核数和内存差距很大,用加权轮询给新机器分配更高的权重,能让资源利用率更合理,如果节点权重长期不调整,会在流量结构变化后出现新的瓶颈。
| 算法名称 | 适合场景 | 需要注意的问题 |
|---|---|---|
| 轮询 | 节点配置相同,耗时时长接近 | 无状态服务比较合适 |
| 加权轮询 | 节点配置差异明显 | 权重需要定期校准 |
| 最少连接 | 长请求多,耗时波动大 | 连接数统计存在延迟 |
| IP Hash | 需要会话保持,带状态服务 | 节点扩容会改变哈希映射 |
中央服务器算法和后端算法区别在哪里
职责边界不同
后端算法处理的是具体业务逻辑,比如推荐系统里的协同过滤、风控里的评分卡模型,中央服务器算法更关注请求怎么分布、任务怎么排队、数据怎么保持一致,业内专家指出,中央服务器算法本质上是“调度者的算法”,而不是“执行者的算法”。
数据流方向不同
后端算法接收业务参数,返回计算结果,中央服务器算法要先从所有节点收集状态信息,比如CPU负载、活跃连接数、内存占用,然后统一决策,数据是汇总之后往下发,而不是单个请求的直上直下。
容错策略不同
后端算法挂了只影响一个请求,中央服务器算法挂了会影响整个集群,所以中央服务器算法必须配合心跳检测、超时重试、主从切换,比如Raft算法里Leader宕机后,Follower会自动触发选举,这种能力是普通后端算法不需要考虑的。
中央服务器算法培训费用大概多少?自学路线怎么走
培训费用参考
市面上关于中央服务器算法的课程,线上录播课通常从两三千到上万元不等,线下训练营会更贵,北京、上海的线下班因为场地和讲师成本,价格普遍偏高,适合有明确跳槽需求的在职工程师,如果是学生,先看Raft论文解读和Nginx官方文档就能入门,不一定要花培训费。
自学实操清单
- 用Nginx配置轮询和加权轮询,观察请求分发结果。
- 用Redis实现分布式锁,理解缓存一致性算法。
- 用Python写一个FedAvg模拟程序,跑通参数聚合流程。
- 下载Raft开源实现,启动三个节点,手动杀掉Leader观察选举过程。
如果你在找北京的中央服务器算法岗位,面试官常会问流量不均衡时怎么调权重,上海那边更关注数据一致性和缓存穿透,准备方向要有所侧重。
中央服务器算法不是单一算法,而是围绕调度和一致性展开的算法家族,选型时先界定场景,再看节点能力,最后才谈具体算法名称。
中央服务器算法常见问题解答
中央服务器算法有哪些必须要会?
负载均衡、任务调度、Raft共识和FedAvg聚合是四个高频方向,入门先把轮询和加权轮询做熟,再用Raft理解Leader选举,最后用FedAvg理解“中心节点汇聚”的工作方式。
轮询和加权轮询怎么选?
后端节点配置一致选轮询,配置差异明显选加权轮询,加权轮询需要给高配置节点更大权重,但权重最好结合CPU使用率动态调整,不能设完就不管。
中央服务器算法和分布式算法是一回事吗?
不是,中央服务器算法强调一个中心节点做决策,分布式算法强调多个节点平等协作,Raft虽然属于分布式共识算法,但在中央服务器架构中常以单Leader模式运行,两者有交集但不等同。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/763751.html