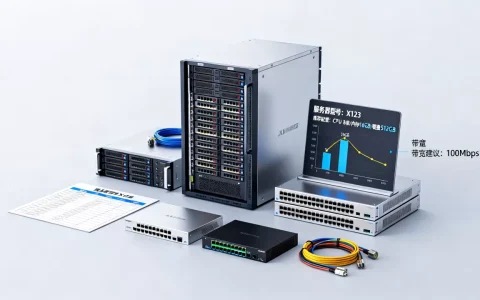
天文计算服务器没有单一型号,而是根据任务需求分成三类主力:国家超算中心的天文计算分区、天文台自建专用集群、商业云平台的HPC实例。如果你要处理的是宇宙学模拟或射电干涉成像,答案会完全不同,下面我把这三类的硬件构成、适用场景、价格逻辑一次说清。
天文计算服务器有哪些配置先分清三类主力
天文数据的特点是“大但稀疏”,而且计算模式两极分化:要么是海量小文件的并行读取,要么是超大矩阵的连续运算,天文计算服务器从来不是一台机器,而是一个集群。

第一类:国家超算中心的天文计算分区
国内的天文科研团队相当一部分计算任务跑在“天河”“神威”“曙光”这类超算中心上,这些中心会划出专门的天文计算分区,天体物理高精度模拟专区”。
- 硬件构成:以CPU为主,搭配少量加速卡,CPU多采用AMD EPYC或Intel Xeon Scalable系列,单节点核心数在64到128之间。
- 网络互联:使用InfiniBand HDR或更高规格,节点间延迟在微秒级,这是N体模拟和磁流体计算的生命线。
- 调度系统:统一使用Slurm,你通过
sbatch提交作业,而不是直接登录节点操作。 - 适用任务:宇宙大尺度结构模拟、恒星演化网格计算、引力波波形模板库生成。
这里有个实操细节:在超算上跑天文模拟,通常需要先申请“机时”,也就是计算资源的配额,业内专家指出,机时申请的本质是“用时间换空间”,你写清楚科学目标、算法规模、预期输出量,评审通过后就能获得专属分区使用权。
第二类:天文台自建专用集群
大型天文台,比如国家天文台、紫金山天文台,都有自己的数据处理集群,这类服务器不是用来做理论模拟的,而是接住望远镜每天产生的原始数据。
- 硬件构成:存储占比极高,计算节点反而不那么夸张,常见配置是每1个计算节点搭配3到5个存储节点,存储介质为NVMe SSD做热数据层,HDD做冷归档层。
- GPU用途:只做特定加速,比如射电干涉成像的网格化操作,或者光学图像的源提取,用得最多的是NVIDIA A100或H100,但数量不多。
- 软件环境:预装SARAO、CASA、Astrometry.net等天文专用工具链,你不需要自己编译。
- 适用任务:望远镜数据处理、天体测量归算、暂现源预警。
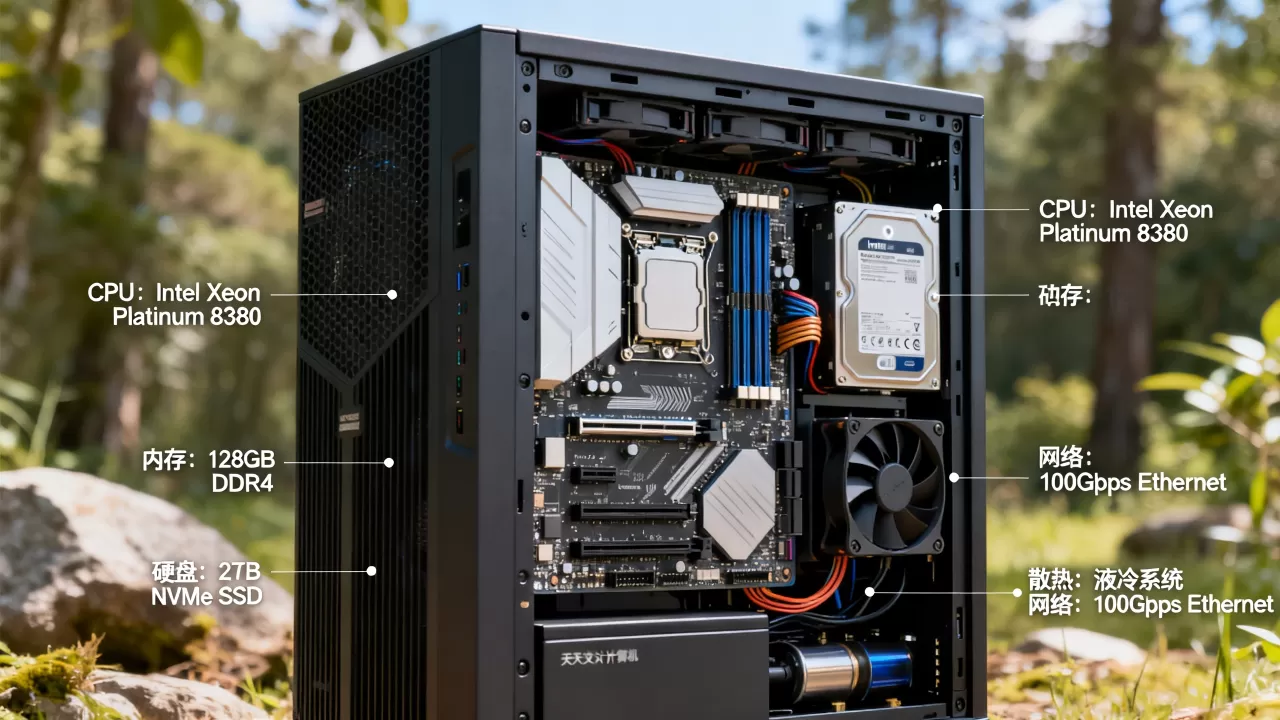
自建集群的好处是数据不出内网,适合近实时观测的项目,比如快速射电暴的实时定位,从接收到信号到输出天球坐标,要求延迟低于1秒,商业云很难做到这种稳定延迟。
第三类:商业云服务器的天文计算实例
如果你没有超算机时,也够不着台内集群,那商业云的HPC实例就是灵活选择,简米云、酷番云、华为云都提供“计算加速型”和“高主频计算型”实例。
- 代表机型:简米云ecs.g7h(高主频)、酷番云GA6(AMD Milan)、华为云HECS Pro。
- 关键配置:选择CPU主频高于3.0GHz的实例,搭配40Gbps以上内网带宽,天文图像处理对内存带宽极其敏感,内存通道数比核心数更重要。
- 适合人群:个人研究者、高校课题组、短期项目验证。
商业云最大的坑是存储IOPS计费,星表文件动辄几亿行,如果你用标准云盘跑SQL查询,费用可能比计算本身贵得多,建议选择极速型ESSD,并开启文件预热缓存。
天文计算服务器和普通服务器区别这五个维度最明显
很多人把天文服务器当作“高配电脑”,其实是完全不同的物种,以下五个差异决定了你能不能把任务跑起来。
| 维度 | 普通服务器 | 天文计算服务器 |
|---|---|---|
| 数据流 | 数据库交易型,读写小数据块 | 流式大文件,单文件可达TB级 |
| 并行模式 | 多线程处理短事务 | MPI多进程分布式计算 |
| 存储策略 | 注重RAID冗余 | 注重聚合带宽和分层存储 |
| 精度要求 | 双精度浮点即可 | 部分场景需要伪四精度或混合精度 |
| 网络拓扑 | 千兆/万兆以太网 | InfiniBand胖树或3D环网 |
行业共识认为,判断一台服务器是否适合天文计算,最简单的测试是跑一次N体模拟的standard测试用例,如果节点间通信耗时超过计算耗时的30%,说明网络设计不合格,换再贵的CPU也没用。
天文计算服务器租用价格按场景算账才靠谱
价格问题得拆开看,因为租超算机时和租云服务器是两套计价逻辑。
超算机时价格
国家超算中心的机时价格按“核时”计算,即每核每小时多少钱,目前国内公开报价普遍在
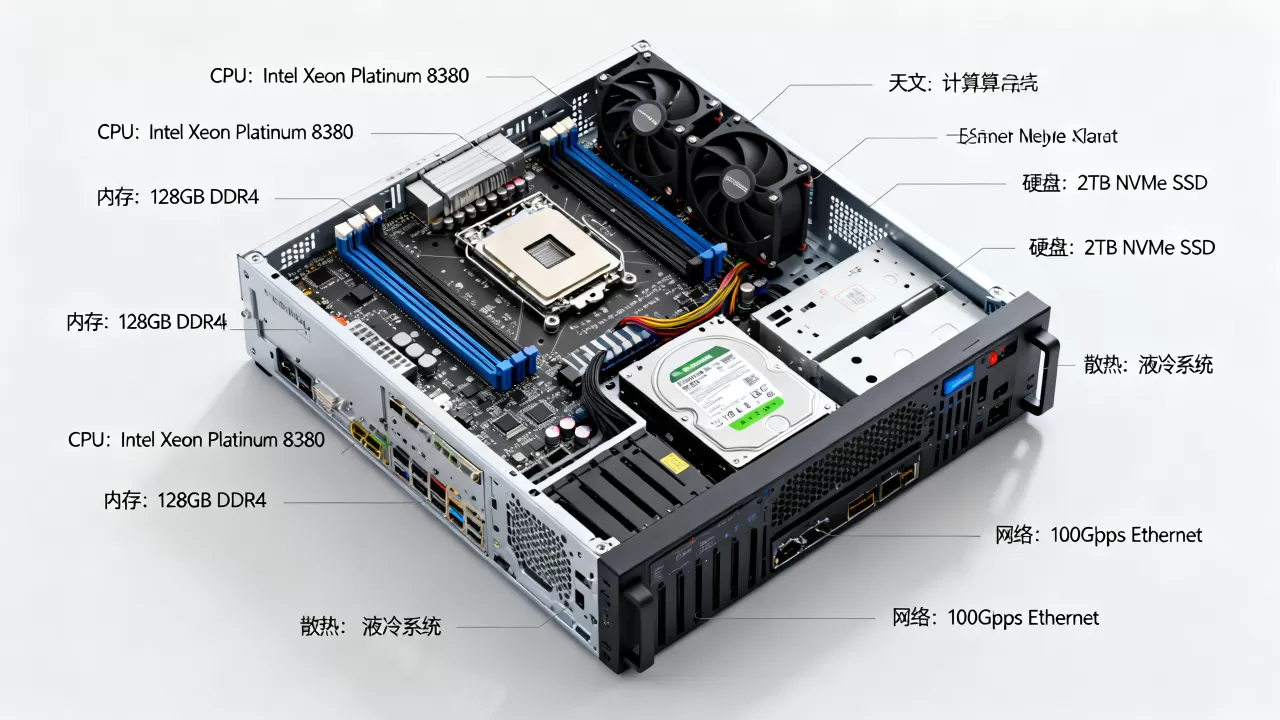
02元到0.1元/核时之间,具体取决于分区优先级和是否包含GPU。
- 一个128核心的模拟任务跑100小时,大约需要12800核时,费用约1280元。
- GPU分区价格更高,常见为30元到60元/卡时,但只在特定时段开放。
云计算实例价格
商业云按小时计价,以简米云为例:
- 计算型c7实例(32核64GB):约5元/小时。
- GPU实例(A100 40GB):约25元/小时。
- 光年之外的数据传输费用:公网入流量免费,出流量约8元/GB。
租用天文计算服务器推荐采用“混搭”策略:需要长时间稳定跑的任务放在超算,需要弹性扩展的短期处理放在云上,比如你处理一张2万×2万的CCD图像,云上开个GPU实例两小时搞定,费用50元,比买整机划算得多。
天文计算服务器到底怎么选实操步骤
别急着看参数,先明确你的数据管线和算法类型,下面的步骤能帮你少走弯路。
第一步:确认计算模式
- 是通信密集型任务(比如N体模拟、MHD)?→ 选InfiniBand网络,别省钱。
- 是吞吐密集型任务(比如图像处理、源提取)?→ 选高主频CPU+大内存带宽。
- 是存储密集型任务(比如星表关联、时序检索)?→ 选分布式存储,计算节点反而次要。
第二步:测试现有代码
找一台最小配置的测试机,跑一次你的核心算法,注意三点:
- 记录CPU利用率和内存带宽,如果内存带宽跑满而CPU空转,说明是访存瓶颈,应该加内存通道而不是加核心。
- 检查MPI通信耗时,用
mpiP或TAU工具分析。 - 确认是否有GPU加速库可用,比如天文图像处理的
AstroAccelerate。
第三步:参考同类项目的公开配置
- 平方公里阵列(SKA)的数据处理节点采用CPU+FPGA混合架构,单节点处理能力约10 Tflops。
- LIGO引力波探测的离线分析集群使用Intel Xeon Gold 6148,搭配100GbE网络。
- 国内FAST望远镜的数据中心配置了3000核以上的CPU集群,存储总量达20PB。
照着这些公开信息横向对比,你能少交很多“学习费”。
天文计算服务器有哪些容易忽略的细节
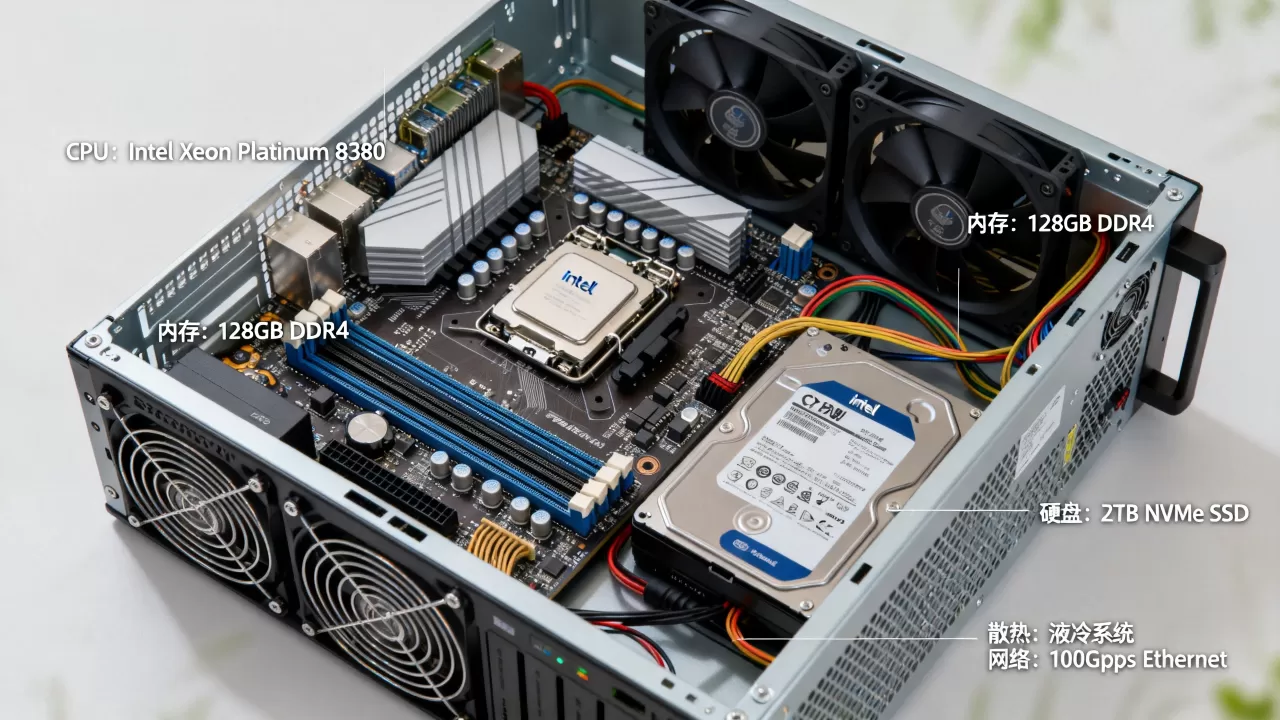
选型完了不代表万事大吉,下面这些细节决定了系统实际运行效率。
存储文件系统选择
天文数据往往是小文件海量分布,比如一颗恒星的光曲线分成几千个FITS文件。Lustre或BeeGFS这类并行文件系统适合大文件,对小文件的元数据操作很慢,如果你的数据以中小文件为主,建议用IBM Spectrum Scale(GPFS),或者干脆把数据打包成HDF5再上并行系统。
电源和散热规划
自建集群时,每机柜功率通常超过25kW,必须采用液冷方案,普通风冷在单机柜15kW以上就会进入降频保护,显然不适合天文计算这种长跑型负载。
作业调度经验
在超算中心,排队策略比你想象的复杂,建议:
- 把任务拆成可续跑的检查点,每10分钟保存一次状态。
- 使用异构节点混合提交,CPU节点算初值,GPU节点跑加速核。
- 避开每月的“大作业集中提交日”,通常月初和月中排队时间最长。
Q&A:天文计算服务器常见问题
问:天文计算服务器可以跑深度学习吗?
可以,但不建议直接用,天文深度学习任务通常需要特殊的预处理,比如把FITS文件转换成TFRecord格式,还要处理坏像素掩膜,天文图像的动态范围极大,普通归一化方法会丢失暗弱信号,如果你要用GPU跑天文深度学习,至少要准备256GB内存的预处理节点,否则数据管道会卡死。
问:天文计算服务器和普通服务器区别主要体现在哪里?
主要体现在网络互联、存储架构和软件生态三个层面,普通服务器用千兆或万兆以太网,天文服务器用InfiniBand;普通服务器存储注重单盘容量,天文服务器注重聚合带宽;普通服务器装的是通用Linux发行版,天文服务器预装CASA、HEALPix、GSL等专用库,换句话说,天文计算服务器是“为长时间高吞吐而畸形的怪兽”,它的CPU核心数、内存通道、网络拓扑必须为并行算法量身定制。
问:没有科研机构身份,个人能租到天文计算服务器吗?
可以,通过商业云平台的HPC实例就能实现,个人用户申请时不需要提交科研资质,只要实名认证即可,但要注意,商业云默认没有预装天文软件,你需要自己用conda或docker搭建环境,一个常用的组合是Ubuntu 22.04 + Miniconda + astropy + CASA,整个过程约一小时就能完成,如果你处理的数据量在几百GB以内,租一台高主频计算型实例完全够用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/765716.html