Linux数据库服务器卡顿,先看负载和慢查询,再杀进程和调参,九成问题出在SQL、内存或磁盘IO上。卡顿不是玄学,是有迹可循的系统求救信号,下面这套排查路径,是生产环境验证过的高效打法。
卡顿第一现场:三秒定位资源瓶颈
服务器卡了,别慌着重启,也别急着看代码,先上机器跑三个命令,三秒钟就能锁定方向。
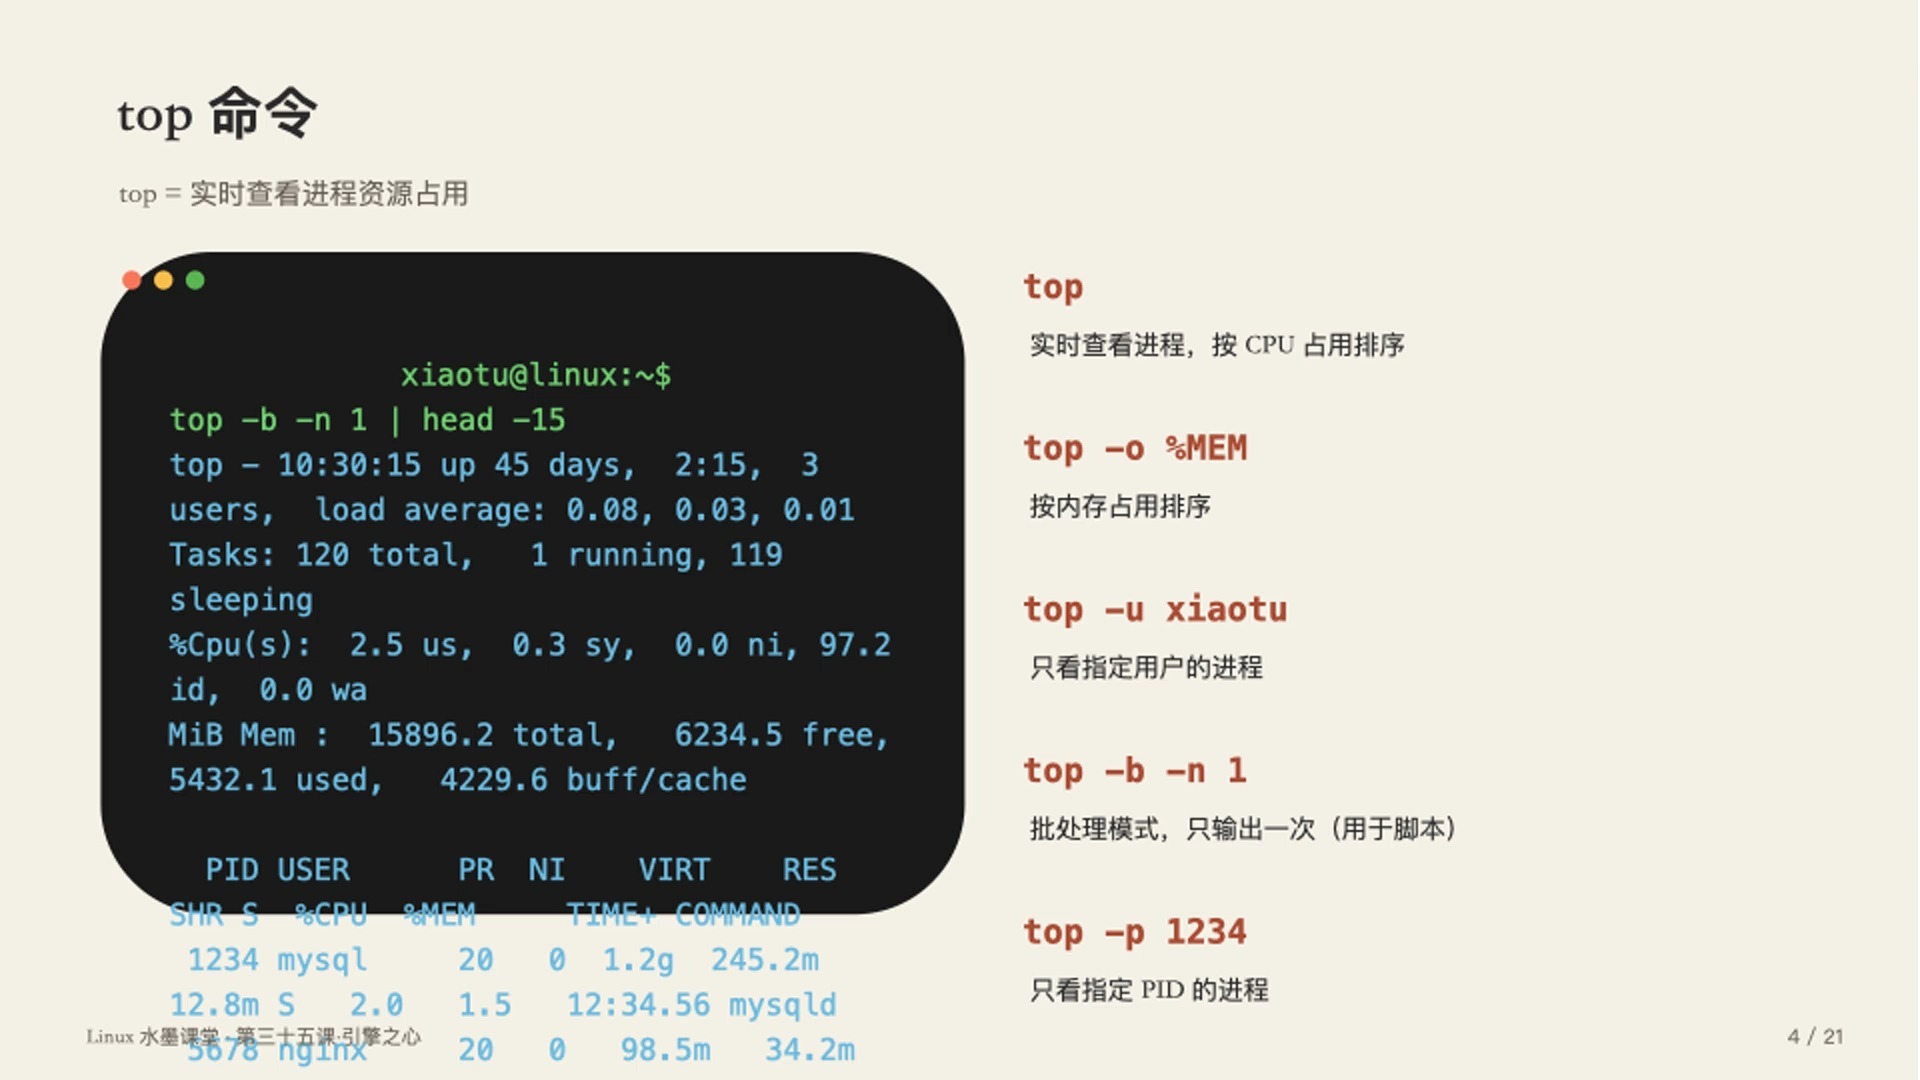

Top命令是第一个入场选手。
top -c关注三个指标:load average、%CPU、%wa。load average超过CPU核数的70%,系统已经拥挤了。%wa高,说明磁盘IO在拖后腿。%us高,是应用层在消耗CPU。
Vmstat看全局走势。
vmstat 1 5每秒刷一次,连续五次,看r列(运行队列)和wa列(IO等待),r列持续大于CPU核数,说明进程在抢CPU,wa列常年离谱,磁盘是瓶颈实锤了。
Iostat点名磁盘。
iostat -x 1 5重点盯util和await。util超过80%,磁盘已经非常吃力了,await飙高,说明IO请求排队严重。
这三板斧下来,资源瓶颈基本水落石出,接下来就是要针对处理了。
CPU百叶窗:找出谁在消耗算力
CPU被打满,通常是慢SQL、死循环进程或者突发流量,处理路径是:
- 执行top后按P键,按CPU占用排序
- 记下高CPU进程的PID
- 用perf或strace跟踪进程行为
- 是数据库进程,直接进数据库查正在执行的SQL
MySQL的话,一条命令看清当前所有会话:
SELECT FROM information_schema.processlist WHERE command != 'Sleep';PostgreSQL对应的是:
SELECT FROM pg_stat_activity WHERE state = 'active';发现了大查询,能kill就直接kill,不能kill就优化SQL,不是数据库进程,是别的程序在捣乱,直接处理那个进程就行。
内存危局:Swap和OOM的连锁反应
内存不足时,Linux会启用Swap,服务器性能会断崖式下跌,用free -h看一眼内存水位。
可用内存低于20%且Swap有持续读写,就到了必须干预的程度,处理步骤:
- 找出大内存进程:ps aux –sort=-%mem | head -20
- 数据库的话,重点排查buffer pool、连接数、临时表配置
- 检查dmesg看有没有OOM Killer的记录
dmesg | grep -i oom看到OOM Killer在杀进程,说明内存到了非常危急的状态,优先调整数据库的内存参数,其次才是加物理内存。
数据库层排查:谁在拖垮SQL性能
系统层看完没问题,卡顿大概率来自数据库内部,慢查询日志是数据库自己的求救白皮书。
MySQL开启慢查询日志:
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 2;
分析慢日志,推荐用pt-query-digest(Percona Toolkit)或者mysqldumpslow,PostgreSQL则要开启auto_explain模块,把慢SQL的执行计划自动打出来。
慢查询擒贼:先抓最耗时的SQL
慢日志里,要优先关注三类SQL:
- 全表扫描的查询,该建索引没建
- 排序或临时表操作,SQL写法或参数类型有问题
- 锁等待严重的更新操作,事务忘了提交
处理原则很简单:给高频查询的WHERE字段建索引,把SELECT 改成明确字段,JOIN的关联字段类型保持一致,据统计,大部分生产环境的性能问题,都能靠加索引和改SQL写法解决。
索引不是越多越好,每个索引都是写入的负担,遵循原则是:区分度高的列优先,联合索引遵守最左前缀规则。
连接与锁:并发场景下的隐形杀手
连接数满了,新请求全部排队,表现为服务器假死,MySQL看max_connections,PostgreSQL看max_connections。
一般建议把连接数控制在200以内(根据内存容量调整),连接过多还有一个副作用:锁竞争加剧,用show engine innodb statusG看锁信息。
处理锁问题的优先级是:
- 找出持锁时间最长的事务
- 确认事务代码是否有休眠等待
- 杀掉长时间空闲的事务连接
网上那句“服务器高并发卡顿怎么排查”的答案,很大程度上就是查连接、查锁、查慢SQL这三件事。
配置调优:让数据库吃得少跑得快
MySQL关键参数调整
- innodb_buffer_pool_size:设为可用内存的70%左右
- innodb_log_file_size:调整为1GB以上,减少日志切换频率
- max_connections:根据实际并发估算,别盲目设大
- innodb_flush_log_at_trx_commit:追求性能可设2,追求安全设1
PostgreSQL关键参数调整
- shared_buffers:设为内存的25%左右,过高反而引发性能回退
- effective_cache_size:设为内存的50%~75%,帮助优化器做正确判断
- work_mem:复杂排序操作可调高,但别过大导致内存爆掉
- maintenance_work_mem:建索引和VACUUM时用,可加大到1GB以上
配置修改后需要重启数据库,重启前务必用配置检查工具验证语法,别一个参数写错让服务器雪上加霜。
架构层面:治本不是靠调参
调参只能延缓,不能根治,流量见涨后,架构层面的技术改造才靠谱。
读写分离扛住主库压力
主库负责写入,从库分担读操作,这是最基础的扩展手段,MySQL用主从复制,PostgreSQL用流复制,读写分离后,主库的CPU和IO压力能降一大截,业务方只需把读请求切到从库地址即可。
缓存挡在数据库前面
Redis或Memcached前置,把热点数据缓存起来,一个简单原则:同一条数据在短时间被读超过三次,就应该进缓存,缓存命中率在60%以上时,数据库压力释放效果非常明显。
数据归档让表瘦身
单表数据量过亿后,索引和查询性能都会下降,归档策略是:
- 热数据保留在线上(近3个月)
- 温数据按月分表存储
- 冷数据迁到历史库或大数据平台
预防比救火更重要:运维体检清单
卡顿处理完,要复盘为什么卡,一套日常巡检机制能避免大多数问题:
- 每天定时查看慢查询日志数量和最长耗时
- 每周检查一次磁盘空间和inode使用率
- 每月分析一次数据库性能基线变化
- 版本升级前,先在测试环境做性能压测
行业共识认为,数据库的性能问题90%发生在变更后,代码上线、配置调整、数据批量导入,都是事故高发时刻,变更窗口期的高频监控,比平时的检查更能兜底。
操作系统层面的参数也要配合:文件句柄数、网络连接队列长度、磁盘调度算法(deadline或none模式对数据库更友好),这些系统参数和数据库参数是配套的,只调一边,效果都会打折。
如果这些手段都用上了,卡顿依旧频繁,就该考虑是否到了升级硬件的节点了,换SSD硬盘、加内存、升级CPU,是最直接的物理手段,在“linux数据库服务器卡顿怎么办”这个问题上,硬件的最后兜底作用不可忽视。
Q&A:linux数据库服务器卡顿怎么办
问:数据库服务器CPU占用率100%,但看不到明显的高SQL进程,怎么查?
答:很可能是后台任务或系统进程吃掉了CPU,排查方式:执行top -c看完整命令行,排除自研Agent、备份脚本、日志采集器,再用pidstat -t -p PID查看线程级消耗,用perf top定位内核层面的热点函数,如果疑似数据库内部线程,查information_schema.processlist或pg_stat_activity确认是否存在并行维护操作(如索引重建、统计信息更新)。
问:数据库卡顿期间,是选择重启服务还是原地排查?
答:如果服务完全无响应,且监控显示负载持续飙升,先抓取3秒的performance_schema数据或pg_stat_activity快照,再执行重启,裸重启会丢失现场信息,后续原因无从查起,注意清空binlog或WAL目录,避免重启后磁盘空间被大量日志写满,导致二次故障,如果还有响应能力,优先杀掉卡顿源头进程,观察是否能自然恢复。
问:mysql和postgresql在卡顿处理上有什么明显差异?
答:MySQL更依赖慢查询日志和EXPLAIN执行计划定位问题,InnoDB的锁信息和缓冲池命中率是核心诊断依据,PostgreSQL则更重视autovacuum的及时性和共享缓冲区命中率,PostgreSQL遇到卡顿,先检查pg_stat_activity里是否存在长事务和锁等待链,再确认vacuum是否滞后,因为vacuum失控会导致表膨胀失控,查询性能剧烈下降。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/766810.html