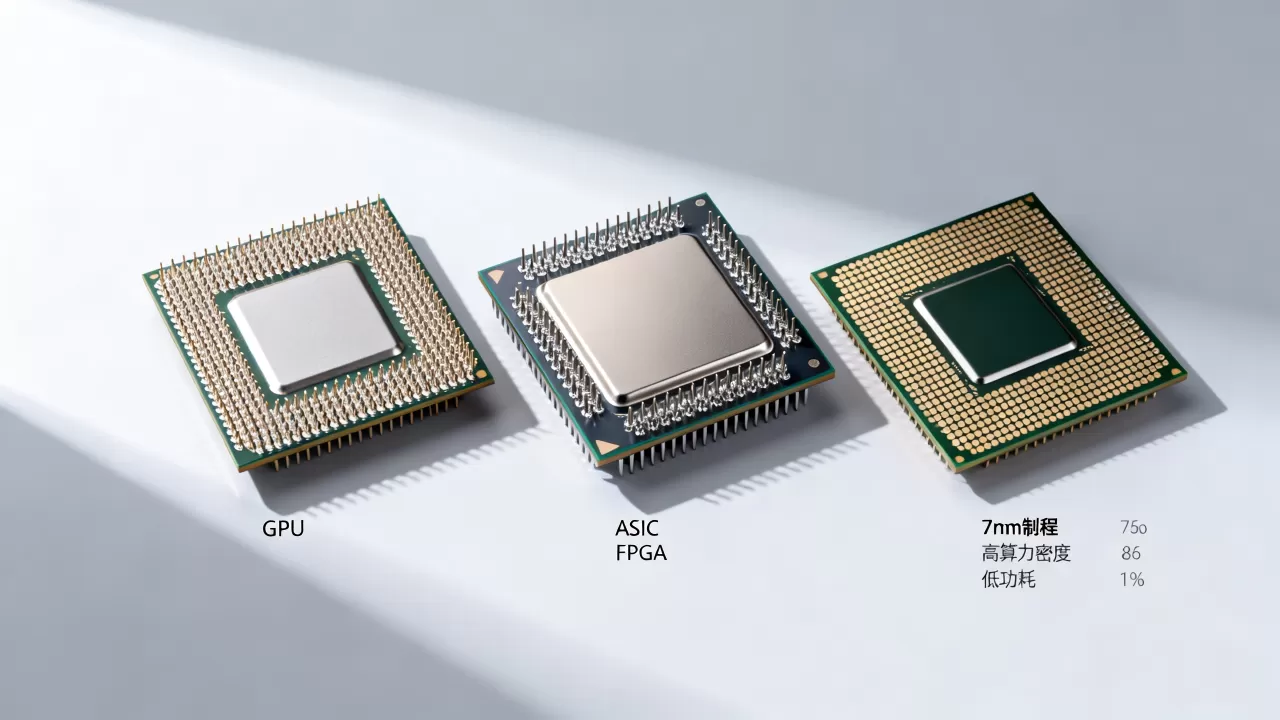
推理服务器芯片主要有GPU、ASIC专用加速卡、FPGA、CPU以及云厂商自研芯片这几类;选型时先看模型规模、延迟要求和软件生态,再算功耗与预算。
推理服务器芯片有哪些?主流阵营一次讲清
把推理服务器拆开看,芯片并不只有一种答案,训练集群里常见的通用GPU,到了推理阶段会分化出更细的路线,核心判断标准是:模型多大、并发多高、延迟多低、预算多紧。
GPU:通用性最强,生态最成熟
GPU是目前推理服务器里占比最高的选择,NVIDIA的L4、L40S、A10、A30、H100、H200以及后续Blackwell架构产品,覆盖从视频分析到百亿参数大模型推理,AMD的MI300X、MI210也在推理市场持续发力,Intel则通过Flex系列和Max系列切入。
GPU的优势是软件栈成熟,CUDA、TensorRT、TensorRT-LLM、Triton Inference Server、vLLM等工具链,让多数模型可以较快上线,缺点也直接:高端卡价格高、功耗高、供货受周期影响。
ASIC/专用加速卡:能效比高,绑定软件栈
ASIC路线包括Google TPU、AWS Inferentia和Trainium、华为昇腾310/910、寒武纪思元、百度昆仑芯、天数智芯、燧原、壁仞等,这类芯片针对矩阵运算和低精度推理做优化,单位功耗下的吞吐往往更有优势。
代价是生态绑定更强,模型迁移、算子支持、框架版本都要看厂商工具链,如果业务固定、模型变化少,ASIC能压低长期成本;如果模型迭代快,就要先做兼容性验证。
FPGA:灵活可编程,适合特定流水线
AMD Alveo、Intel Agilex等FPGA方案,适合低延迟、定制化流水线、视频编解码加推理的组合场景,它的优势是硬件可重构,缺点是开发门槛高,需要专业团队写RTL或HLS,不适合快速上线。
CPU与SoC:轻量推理和边缘场景
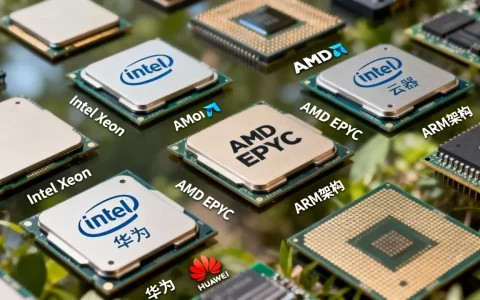
Intel Xeon、AMD EPYC、Ampere Altra、华为鲲鹏、飞腾等CPU,适合小模型、推荐系统、风控规则加轻量神经网络,边缘侧还有NVIDIA Jetson、地平线征程、寒武纪边缘芯片等SoC方案。
| 类型 | 代表产品 | 优势 | 局限 | 典型场景 |
|---|---|---|---|---|
| GPU | NVIDIA L4/L40S/H100、AMD MI300X | 生态成熟、通用性强 | 价格高、功耗高 | 云端大模型、视频分析 |
| ASIC | 昇腾、TPU、Inferentia、昆仑芯 | 能效比高、批量成本低 | 生态绑定、迁移成本 | 固定模型、大规模推理 |
| FPGA | Alveo、Agilex | 低延迟、可重构 | 开发难、门槛高 | 视频流水线、定制加速 |
| CPU/SoC | Xeon、EPYC、鲲鹏、Jetson | 部署简单、成本低 | 算力有限 | 边缘推理、轻量服务 |
AI推理服务器芯片怎么选?先分清训练与推理
训练看重峰值算力、互联带宽和大显存;推理更看重显存容量、访存带宽、低精度性能和单位成本,很多团队直接拿训练卡做推理,结果资源利用率并不理想。
算显存和带宽:大模型推理的硬门槛
以70B参数模型为例,FP16精度下权重约140GB,INT8约70GB,INT4约35GB,实际部署还要留KV Cache空间,单卡显存不够,就要多卡并行或量化,显存带宽决定token生成速度,带宽越高,解码延迟通常越低。
精度与量化:INT8/INT4能省多少
推理常用FP16、BF16、INT8、INT4,INT8和INT4能显著降低显存占用和带宽压力,但可能带来精度损失,实操路径是:先用FP16跑通,再用TensorRT-LLM或厂商工具做INT8量化,最后用业务数据集评估准确率。
软件栈与框架:CUDA、ROCm、CANN、OpenVINO
选芯片就是选软件栈,CUDA生态最全,ROCm在追赶,CANN绑定昇腾,OpenVINO适合Intel平台,部署前至少验证:PyTorch/ONNX模型能否转换、算子是否支持、是否支持动态shape、是否有生产级服务框架。
实操选型六步
- 明确模型参数量、输入长度、输出长度和QPS目标。
- 估算显存:权重加KV Cache加框架开销。
- 选定精度:FP16、INT8还是INT4。
- 验证软件栈:转换、量化、压测。
- 小规模POC:用真实流量测P99延迟。
- 算总拥有成本:购卡、整机、电费、运维、迁移人力。
业内专家指出,推理选型失败多数不是算力不够,而是显存、带宽或软件兼容性提前没算清。
国产推理服务器芯片和英伟达差距大吗?场景决定答案
差距存在,但不是所有场景都受影响,行业共识认为,国产芯片在信创、政务、金融、能源等合规场景有明确空间,在通用云端大模型推理上仍在追赶。
生态差距:CUDA护城河与国产生态追赶
CUDA积累了十几年工具链和开发者习惯,国产厂商通过CANN、OpenCL、自研编译器兼容主流框架,但算子覆盖、调试工具、社区文档仍有差距,模型越新、结构越特殊,迁移成本越高。
供货与合规:信创、政务、金融场景
在信创采购中,国产CPU加国产加速卡是常见组合,华为昇腾、寒武纪、海光、昆仑芯等都有整机方案,若项目要求国产化率,选型顺序会先看合规清单,再看性能。
北京推理服务器芯片采购注意点
在北京推理服务器芯片采购中,除了价格,还要看机房电力、散热、等保要求和供货周期,北京部分数据中心对PUE和功耗密度有约束,高功耗GPU整机不一定能直接上架,建议先确认机柜功率上限,再决定风冷还是液冷方案。
边缘推理服务器芯片推荐:低功耗与实时性优先
边缘推理和云端推理是两套逻辑,边缘侧通常没有大集群,要求低功耗、宽温、实时响应,还要支持多路视频或传感器接入。
边缘场景芯片特点
算力多在几TOPS到几十TOPS,功耗从几瓦到几十瓦,常见方案包括NVIDIA Jetson Orin、华为昇腾310、寒武纪边缘思元、地平线征程、瑞芯微RK3588等,它们适合安防、工业质检、智慧零售、车载感知。
推荐思路:先看框架,再看接口
如果团队熟悉CUDA,Jetson迁移最快,如果要求全国产,昇腾和寒武纪更合适,如果做视频分析,要重点看解码路数和内存带宽,部署时先用lspci确认加速卡识别,再用nvidia-smi或厂商工具查看利用率,最后跑真实视频流压测。
推理服务器芯片价格多少钱?按整机与云实例拆账
价格不能只看单卡,单卡从数千元到数万元不等,高端推理卡整机可达数十万元,云实例按小时或包月计费,短期测试更灵活,长期稳定负载则自建可能更划算。
单卡价格区间
入门推理卡常见于数千到万元级,主流数据中心推理卡多在数万元,旗舰训练推理一体卡更高,据行业公开报价,供货周期和汇率也会影响实际成交价。
整机与云成本
整机成本包括CPU、内存、主板、电源、机箱、散热和加速卡,8卡整机还要考虑NVLink或PCIe交换,云上则按实例规格、显存和带宽计费,据工信部数据,近年来智能算力需求持续上升,云厂商推理实例价格也在动态调整。
总拥有成本
总拥有成本等于采购成本加电费加运维加迁移加折旧,电费常被低估,一张300W到700W的卡,多卡整机功耗很容易超过2kW,若机房电费高,能效比就是关键指标。
推理服务器芯片常见问题答疑
推理服务器芯片有哪些适合大模型?
大模型推理优先看显存和带宽,NVIDIA H100/H200、L40S、AMD MI300X适合较大规模部署;国产昇腾910、昆仑芯、寒武纪思元在信创场景可用,70B以上模型通常需要多卡并行或INT4量化。
国产推理服务器芯片能替代英伟达吗?
在合规要求高、模型相对固定的场景,国产芯片已经可以承担生产推理,在模型快速迭代、依赖CUDA自定义算子的场景,替代成本仍然较高,是否替代,取决于业务对迁移周期和性能损失的容忍度。
推理服务器芯片价格多少钱一张?
单卡价格从数千元到数万元不等,高端型号整机可达数十万元,云实例按小时计费,适合短期POC;长期稳定负载需对比电费、运维和折旧后再决定自建或上云。
推理服务器芯片没有唯一答案,GPU适合通用快速上线,ASIC适合固定模型降本,FPGA和边缘SoC各有专长;先算显存和带宽,再验软件栈,最后算总拥有成本,才能选出真正匹配业务的方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/768330.html