直播课弹幕峰值对后端系统的冲击,本质是瞬时写入压力远超出常态水位,消息队列削峰的落地思路是:在弹幕入口与业务处理之间插入一个高吞吐的缓冲层,先承接再消费,把“同时涌进来”变成“按节奏处理”。
直播课弹幕高峰期的消息队列削峰方案
直播课和普通视频课最大的区别在于互动是实时的,当老师抛出一个问题,或者某个知识点特别有共鸣时,弹幕会在几秒内从稀疏变得密集,这就是典型的流量尖峰,这个峰值不是慢慢爬坡,而是瞬间爆发,后端服务如果直接面对这种压力,很容易出现连接数被打满、数据库写入锁等待、接口响应超时等问题。
弹幕消息的特点是单条数据量小,但数量极大,且对实时性有一定要求,用户发出一条弹幕,期望的是几秒内能出现在屏幕上,而不是像发邮件那样可以等几分钟,这就要求削峰方案既要能扛住压力,又不能引入过高的延迟。
为什么直接处理弹幕请求会出问题
大多数直播课系统的瓶颈不在应用服务器,而在数据库,应用服务器可以通过横向扩展来提升并发能力,但数据库的写入能力受限于磁盘IO和锁机制,扩展成本高且效果有限,当弹幕峰值到来时,成千上万的写入请求同时打到数据库,会产生大量锁竞争和日志写入等待,导致整体吞吐量急剧下降。
业内专家指出,多数情况下数据库的写入性能衰减是非线性的,并发量超过阈值后,响应时间会成倍增加,而不是缓慢增长,这就是为什么单纯靠优化SQL或加索引无法解决根本问题,需要在架构层面引入缓冲机制。
消息队列削峰的核心思路:先承接,再消费
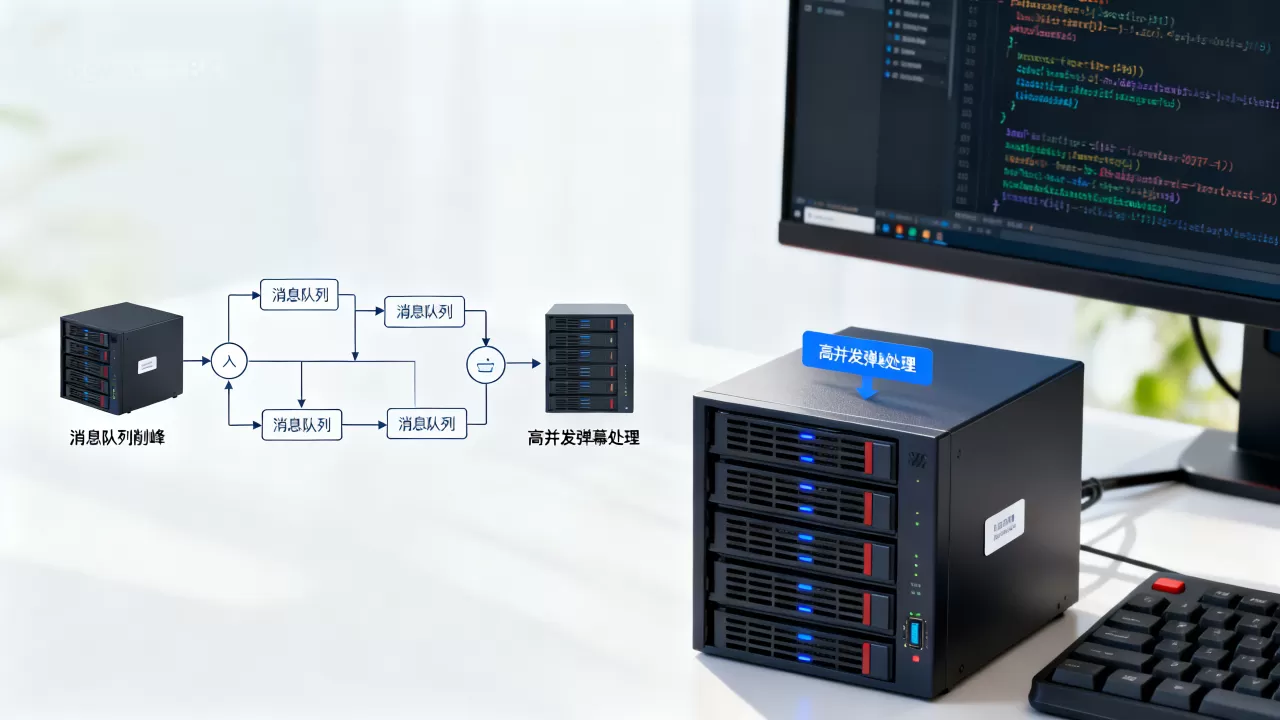
消息队列在这个场景里扮演的角色是“蓄水池”,弹幕请求先快速写入消息队列,由队列承接全部瞬时压力,然后后台消费者按照自己的处理能力从队列中拉取消息,批量写入数据库或推送至实时通道。
这个过程把“同步写入”变成了“异步削峰”,用户的弹幕请求在写入队列后就得到确认,前端可以立即显示发送成功,而实际的存储和分发在后台有序进行,用户感知不到异步处理的存在,但系统的稳定性得到了保障。
具体实施时有几个关键点需要考虑:
- 队列选型:优先考虑吞吐量高的消息队列,如Kafka或RocketMQ,Kafka的吞吐能力较强,适合海量日志类消息;RocketMQ在消息可靠性方面表现更好,支持事务消息。
- 分区策略:弹幕消息需要保证同一用户的消息顺序,可以按照用户ID进行哈希取模,将同一用户的消息路由到同一个分区,避免乱序问题。
- 消费者配置:消费者数量应与分区数匹配,避免出现部分消费者空闲、部分消费者过载的情况,建议消费者线程数略大于分区数,以应对单条消息处理耗时波动。
消息队列削峰方案对比:选型与落地
不同的直播课业务场景对消息队列的需求侧重点不同,中小型在线教育平台和大型直播平台的弹幕量级差异很大,选择方案时需要结合实际业务规模和技术团队能力来权衡。
Kafka的优势在于极高的吞吐量和天然的分布式架构,它的分区机制使得水平扩展非常方便,适合处理千万级甚至亿级日消息量的场景,但Kafka也有短板,比如消息可能重复消费,需要业务侧做幂等处理;同时它的功能相对底层,一些高级特性需要自己开发实现。
RocketMQ在功能丰富度上更胜一筹,支持延迟消息、事务消息、消息轨迹等特性,对于直播课场景,事务消息可以保证弹幕数据不丢失,消息轨迹功能方便排查问题,RocketMQ的缺点是社区活跃度和生态不如Kafka,但阿里巴巴在内部大规模使用,稳定性经过了充分验证。
RabbitMQ则更适合消息量较小、对路由灵活性要求高的场景,它的Erlang语言实现使得并发处理能力不错,但吞吐量相比Kafka和RocketMQ有明显差距,在弹幕峰值场景下可能成为瓶颈。
弹幕消息的批量消费与内存控制
消费者从队列拉取消息时,默认是一次拉取一批消息,而不是一条一条拉取,批量拉取可以显著减少网络往返次数,提升处理效率,但批量大小需要根据消息体大小和业务处理耗时来调整。
弹幕消息体很小,通常只有几十字节,拉取500条或1000条并不会占用太多内存,但如果消费者的业务处理涉及数据库写入,每批消息的处理时间就会拉长,此时需要关注堆积情况,建议设置合理的消费者拉取超时时间和最大拉取数量,避免单次拉取过多导致内存溢出。
消息积压是削峰方案中最需要关注的问题,当生产速度持续大于消费速度时,积压会不断累积,处理积压有几个常用手段:
- 临时扩容消费者:通过动态调整消费者实例数量来提升消费速度,这在Kubernetes环境下可以通过HPA自动完成。
- 降低单条消息处理耗时:将数据库写入改为批量插入,或者合并多条消息后一次性写入,减少IO次数。
- 丢弃非关键消息:如果弹幕消息允许部分丢失,可以在积压严重时开启丢弃策略,优先保证系统稳定。
直播课弹幕架构设计经验:从实际踩坑中总结
在真实项目中,弹幕削峰方案往往不是一步到位的,第一次做直播课系统时,可能只是简单地把弹幕请求直接写入数据库,等到第一次高峰期来临时才发现扛不住,后来引入消息队列,又遇到了消息重复消费、消费者分配不均、积压告警不及时等问题。
比较典型的坑是消费者处理逻辑中调用了第三方接口,比如敏感词过滤服务,当弹幕峰值到来时,第三方服务的响应时间也会变长,导致消费者处理速度下降,进而引发积压,解决方案是把敏感词过滤也做成异步链路,或者在消费者内部增加本地缓存,减少对远程服务的依赖。
另一个常见问题是消息队列的监控告警不到位,如果没有对积压量、消费延迟等指标设置合理的告警阈值,等到发现问题时往往已经积压了数百万条消息,建议对以下指标设置监控:
- 消息积压量:超过一定阈值触发告警
- 消费延迟时间:最新消息的生产时间与消费时间的差值
- 消费者活跃度:消费者心跳是否正常,是否有消费者宕机
弹幕峰值时的消息积压预警与应急处理
即使有了消息队列削峰,也不能保证万无一失,当直播课的在线人数远超预期,或者消费者服务出现异常时,积压仍然可能发生,此时需要有一套应急预案来应对。
积压预警的指标设定与监控
积压量是核心指标,但单纯看积压量不够全面,假设消费者每秒能处理1000条消息,生产者每秒产生1200条,积压会以每秒200条的速度增长,如果不加干预,一小时后的积压量将达到72万条,不仅要看积压的绝对值,还要关注积压的增长趋势。
行业共识认为,积压量超过队列容量的50%时就应该触发预警,超过80%时应该启动应急处理流程,消费延迟时间也是一个重要参考,如果延迟超过30秒,说明消费者的处理能力已经跟不上生产速度,需要介入处理。
弹性扩容与降级兜底策略
弹性扩容是最直接的应对方式,如果消息队列部署在云上,可以通过容器编排平台自动增加消费者实例,扩容前需要确认消费者的无状态性,确保新增实例可以无缝接入消费组。
如果扩容后仍然无法消化积压,或者消费者依赖的下游服务(如数据库)已经达到瓶颈,就需要启动降级策略,弹幕场景下可选的降级方案包括:
- 合并写入:将多条弹幕合并为一条消息进行存储,减少数据库写入次数
- 部分丢弃:对于非核心用户的弹幕,可以随机丢弃一部分,保证主流用户体验
- 关闭历史回放:停止弹幕的历史记录存储,只保留实时展示功能
直播课弹幕的高并发处理,本质上是一个资源调度和权衡的艺术,消息队列削峰解决了“扛不住”的问题,但后续的消费速度、积压处理、降级策略同样需要精心设计,在方案落地过程中,建议先从简化版本开始,逐步完善监控和应急机制,最终形成一套能够应对极端情况的完整体系。
Q&A:直播课弹幕消息队列削峰常见问题
问:直播课弹幕高峰期的消息队列削峰方案,如何评估需要多大的集群规模?
答:评估集群规模需要结合历史峰值数据,先统计过去一段时间内弹幕的每分钟最大发送量,乘以1.5到2倍的冗余系数,得到目标吞吐量,然后根据单台机器处理能力计算所需节点数,Kafka单节点吞吐量通常在几万到十几万条每秒,但实际部署时需要考虑磁盘IO和网络带宽限制,建议先做压测验证。
问:消息队列削峰方案对比中,Kafka和RocketMQ在直播课场景哪个更合适?
答:如果团队已有Kafka运维经验,且弹幕量级较大,Kafka是稳妥选择,如果项目对消息可靠性要求较高,或者需要事务消息、消息轨迹等功能,RocketMQ更合适,对于中小型直播课平台,RabbitMQ也可以胜任,但需要确认其吞吐量满足峰值需求。
问:弹幕消息积压严重时,如何保证用户体验不受影响?
答:积压发生时,优先保证用户能看到最新的弹幕,而不是补齐历史弹幕,可以在消费者中设置优先级,优先消费最新分区的消息,旧消息延后处理,同时前端可以适当降低弹幕展示密度,避免画面过于拥挤,如果积压持续时间较长,可以临时关闭弹幕回放功能,减少后端压力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/770121.html