服务器缓存方式主要有本地内存缓存、分布式缓存、反向代理缓存、CDN边缘缓存、数据库缓存和HTTP浏览器缓存六类,选型时先看访问热点和一致性要求,再谈成本。缓存这件事,说穿了就是让数据离用户近一点、离磁盘远一点,但不同层的延迟、容量和运维成本差别很大。
服务器缓存方式有哪些:先看六种主流路径
本地内存缓存:最快,但别把它当共享仓库
本地缓存把热点数据放在应用进程或本机内存里,常见做法是Guava Cache、Caffeine,或者自己维护一个带过期时间的Map,它的优势是访问通常在微秒级,不跨网络,适合字典、配置、权限码这类读多写少的数据,问题也明显:多台机器各存一份,更新时容易不一致;进程重启缓存就没了。

实操上先看机器内存余量:
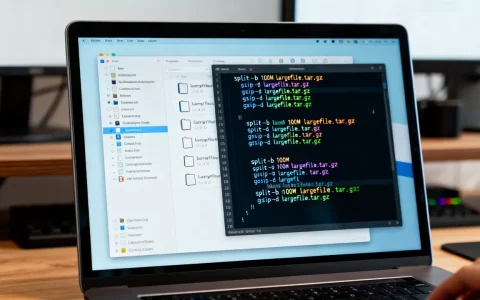
free -h
cat /proc/meminfo
如果应用堆内存已经吃紧,再塞大对象进本地缓存,容易把GC压力放大,更稳妥的做法是给本地缓存设上限和过期时间,只放小体积、高命中、可容忍短时不一致的数据。
分布式缓存:跨机器共享的常用方案
Redis和Memcached是常见选择,Redis更常用,因为支持字符串、哈希、列表、集合等结构,还能做简单限流和分布式锁,它解决的是多台应用服务器共享同一份热点数据的问题,配置时要盯住内存上限和淘汰策略,
redis-cli info memory
redis-cli config set maxmemory 4gb
redis-cli config set maxmemory-policy allkeys-lru
allkeys-lru适合纯缓存场景,volatile-lru只淘汰设置了过期时间的键,业内专家指出,缓存键设计要带业务前缀和版本号,避免不同环境互相覆盖,分布式缓存的代价是网络往返和运维复杂度,访问延迟通常在毫秒级,但容量可以横向扩展。
反向代理与CDN缓存:把请求挡在源站之外
Nginx做反向代理缓存,适合商品详情页、静态接口结果这类可短时复用的内容,典型配置路径是:
proxy_cache_path /data/nginx/cache levels=1:2 keys_zone=my_cache:10m max_size=10g inactive=60m;
proxy_cache my_cache;
proxy_cache_valid 200 302 10m;
add_header X-Cache-Status $upstream_cache_status;
CDN则把缓存推到离用户更近的边缘节点,适合图片、视频、下载包和部分HTML,它的关键是缓存键和刷新策略:URL带随机参数会让命中率掉下去,发布新版本时要主动刷新目录或文件。CDN命中时延迟可以做到较低水平,回源时则受源站和网络影响。
数据库与文件系统缓存:别忽视底层
MySQL的InnoDB缓冲池、查询缓存(新版本已弱化)、操作系统的页缓存,都是服务器缓存体系的一部分,Linux会把读过的文件页留在内存里,用free -h看到的buff/cache就是这部分,文件缓存适合频繁读取的配置、模板和小文件,但要注意脏页回写和磁盘IO。
数据库缓存不能替代业务缓存,热点查询反复打到数据库,即使有缓冲池,连接数和锁竞争也会成为瓶颈,把高频读结果放到Redis或本地缓存,通常比单纯调大数据库缓冲池更直接。
浏览器与HTTP缓存:离用户最近的一层
通过Cache-Control、ETag、Last-Modified控制浏览器和中间代理的缓存行为,能省掉大量重复请求,静态资源可以设长缓存加文件名哈希:
Cache-Control: public, max-age=31536000, immutable
接口结果则要谨慎,登录态、订单状态这类内容不适合长缓存,HTTP缓存不占服务器内存,但版本发布时要处理好文件名或URL变化,否则用户可能一直看到旧资源。
高并发场景下服务器缓存怎么选
高并发场景下,缓存不是越多越好,而是分层要清楚,可以把请求链路想成漏斗:
- 浏览器缓存挡住重复静态请求;
- CDN挡住跨地域的图片和下载;
- Nginx缓存挡住可复用的页面片段;
- Redis承接跨实例的热点数据;
- 本地缓存承接极热的小字典;
- 数据库缓冲池兜底。
选择时看三个指标:命中率、数据一致性容忍度、故障影响面,商品库存、支付状态这类强一致数据,缓存只能做短时只读副本,写后要主动失效;资讯列表、商品详情可以容忍几十秒到几分钟的延迟,多级缓存要设好失效顺序,通常先更新数据库,再删缓存,避免旧值被重新写回。
服务器缓存和本地缓存区别在哪
行业共识认为,本地缓存和分布式缓存不是替代关系,而是分工关系,对比如下:
| 对比项 | 本地内存缓存 | 分布式缓存 |
|---|---|---|
| 访问位置 | 应用进程或本机内存 | 独立缓存集群 |
| 延迟量级 | 微秒级 | 毫秒级 |
| 容量扩展 | 受单机内存限制 | 可横向扩展 |
| 一致性 | 多机之间容易不一致 | 集中管理,相对好控制 |
| 故障影响 | 进程重启即丢失 | 集群故障影响面更大 |
| 适用场景 | 小字典、配置、极热数据 | 会话、热点对象、跨实例共享 |
如果团队机器少、数据量小,本地缓存加短过期时间就能撑一阵;机器一多,会话和热点数据最好放到Redis这类共享层。
服务器缓存配置多少钱才不花冤枉钱
“服务器缓存配置多少钱”没有统一答案,费用通常拆成三块:缓存实例规格、网络带宽或请求次数、运维人力,云上Redis按内存规格和架构计费,包年包月适合流量稳定业务,按量计费适合波动明显的活动期,自建Redis则要把服务器、内存、备份和监控算进去。
控制成本的做法很具体:
- 先估算热点数据体积,别按全量数据买内存;
- 给键设置合理过期时间,减少无效占用;
- 监控命中率和内存碎片率,命中率长期偏低时先查键设计和过期策略;
- 静态资源尽量放CDN,别让缓存实例扛图片流量;
- 非核心业务可以用较小规格加本地缓存兜底。
北京服务器缓存方案怎么落地
如果业务用户集中在华北,北京服务器缓存方案要优先考虑地域和网络路径,云上购买Redis时,在控制台选择“华北-北京”地域,再选可用区和网络类型,让缓存实例和应用服务器尽量同地域、同VPC,减少跨地域回源,操作路径通常是:云控制台→缓存服务→购买实例→选择北京地域→选规格和架构→配置白名单→应用侧改连接地址。
部署时注意三点:同城多可用区做高可用;CDN节点覆盖华北用户,静态资源就近分发;跨地域容灾时,缓存同步要评估延迟,别把强一致写操作压到远距离链路上,北京地域资源相对紧张,规格和带宽要留余量,活动前做压测比事后扩容更稳。
服务器缓存方式常见问答
服务器缓存方式有哪些适合中小团队起步?
优先用Redis做分布式缓存,再配合Nginx静态资源缓存和浏览器HTTP缓存,数据量不大时,本地缓存只放配置和小字典,避免一开始就维护多级缓存。
服务器缓存和本地缓存区别在哪,能不能只用本地缓存?
可以只用本地缓存,但前提是应用实例少、数据可容忍短时不一致,多实例部署后,会话、库存、权限变更这类数据更适合放共享缓存,本地缓存只做加速层。
服务器缓存配置多少钱,云上按量计费会不会更贵?
费用取决于内存规格、架构、带宽和请求量,按量计费适合波动明显的业务,包年包月适合流量稳定的业务,账单差异主要来自容量和请求次数。
缓存选型的核心不是追新技术,而是把数据按热点和一致性分层放对位置,先把命中率和失效策略做扎实,再考虑扩容和跨地域,服务器缓存才会真正变成性能杠杆而不是故障源。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771240.html