目前市面上所有专门用于图形计算、AI训练与推理、高性能计算场景的服务器,本质上都属于GPU服务器,它们或是由云服务商提供的GPU云主机,或是物理形态的GPU托管服务器,核心标志就是搭载了NVIDIA、AMD或华为昇腾等厂商的独立GPU加速卡。
需要说明的是,普通服务器和GPU服务器最直观的区别,在于后者多了一颗或多颗专门处理并行计算的“超级大脑”,如果你正在犹豫该选哪款,或者好奇自己项目里的服务器到底算不算GPU机器,跟着这篇文章往下看就明白了,这里会从最实际的角度,帮你把GPU服务器这件事理清楚。
按产品形态划分:哪些服务器是GPU的范畴
我们常说的GPU服务器,其实不是一个孤立的硬件概念,它贯穿了从购买到使用的全过程,业内专家指出,选GPU服务器先分清楚形态,后面才不会踩坑。
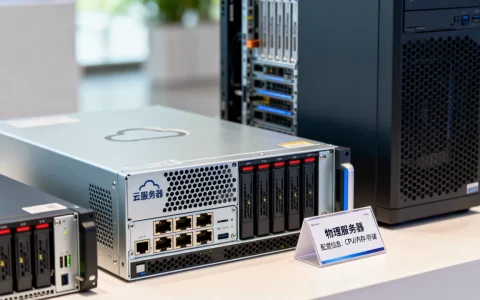
云GPU服务器(GPU云主机)
目前应用最广的形态,几乎所有主流云厂商,如简米云、酷番云、华为云、AWS,都在提供这种服务,你不用买物理机,在控制台选的“GPU计算型”、“异构计算实例”就是典型的GPU服务器,代表型号比如NVIDIA的A100、A800、H800、V100、T4、L40S,还有AMD的MI系列。
这种形态的优势在于弹性伸缩,按小时或者包年付费,适合大多数中小企业和个人开发者,尤其对于想快速跑深度学习框架的团队,没必要自己买卡被硬件故障折腾,云上直接开就完事了。
物理GPU服务器托管
指你自己采购了配有GPU加速卡的机架式服务器,然后放到数据中心托管,这种服务器硬件配置通常为双路Intel Xeon或AMD EPYC处理器,搭配4张或8张全高全长GPU卡,像GPU服务器租用价格一般多少这个问题,如果算上电费和带宽,托管反而比云主机更划算,前提是你业务足够稳定。
这类机器常见于游戏公司做云游戏渲染节点,或是影视公司做离线渲染农场,毕竟一次渲染几万帧的任务,长期跑在云主机上成本挺高的。
按应用场景识别:这些机器也是GPU服务器
除了看外形,更实用的是从你的业务场景反推,如果你所在的项目组正在处理以下任务,那你们用的几乎肯定是GPU服务器。
AI模型训练与微调
大语言模型、Stable Diffusion绘图、推荐系统模型训练,这些任务的共性是需要稠密矩阵运算,这时候用到的服务器,比如内置了8卡A800的集群节点,就是标准的GPU服务器,行业共识认为,没有GPU加速,现代AI模型的迭代周期会长到无法接受。
AI推理与在线服务
当你把训练好的模型部署上线,比如一个识图API或者聊天机器人,它跑在云厂商的GPU推理实例上,这类实例通常会搭配T4或L40S这样的推理卡,显存够大,延迟更低,很多公司问哪些服务器是gpu的,其实发现自己生产环境里的那几台推理机器就是,只不过平时叫法没带GPU两个字。
图形渲染与视频编解码
这是被很多人忽略的地方,动画渲染农场、房地产效果图渲染、4K/8K视频转码,这些重度依赖并行浮点运算的活儿,用的机器同样是GPU服务器,像NVIDIA的A10、RTX A6000显卡,虽然不走数据中心路线,但插在服务器主板上工作,它就该被算作GPU服务器。
科学计算与仿真
基因测序分析、流体力学模拟、气候预测,这类传统HPC领域现在已经全部转向GPU加速,哪怕是FPGA或ASIC方案,只要不是纯CPU计算,归到广义的GPU服务器类别下都没问题。
如何快速判断一台服务器到底是不是GPU的
站在机房或者云控制台前面,往往有更直接的方法判断,下面这两个步骤,你可以跑一遍。
在物理服务器或Linux命令行里查询
如果你能SSH登录服务器,执行一条命令就能看清底细:
nvidia-smi
如果命令能运行成功,并且显示出一块或多块GPU卡的型号、显存、温度、功耗信息,这毫无疑问就是GPU服务器,如果提示 command not found,那要么是没装驱动,要么是纯CPU机器,不放心的话,再跑一条:
lspci | grep -i nvidia
只要输出里有“NVIDIA Corporation”字样的设备列表,那这台机器就是耐打的GPU服务器,可能是V100或者A100系列。
在云厂商控制台看规格
打开云服务器购买页面,在实例规格里只要看到“GPU”、“计算型”、“异构”等标签,或者规格名称里带 g、gn、p(比如简米云ecs.gn7i、酷番云GN10Xp),那这个云主机就是GPU服务器,如果是按GPU卡数量售卖,1卡”、“4卡”、“8卡”选项,也直接说明它是GPU云主机。
GPU服务器和普通服务器区别是什么
把这个问题单独挑出来讲,因为这是用户搜得最多的长尾词,普通服务器更像是一个任劳任怨的管家,什么活儿都能接,擅长处理高并发请求、数据库读写、简单的文件存储,而GPU服务器更像是为你专门雇的一支特种兵小分队,人多势众,擅长把一个复杂的大任务拆分成几千个小任务同时处理。
具体差异体现在这几个核心维度:
- 计算架构差异:普通CPU服务器设计逻辑是“低延迟、串行计算”,单核性能再强也双拳难敌四手,GPU服务器拥有成百上千个计算核心,专门干大规模并行计算。
- 内存带宽差异:GPU服务器通常配备超高带宽的HBM显存或GDDR6显存,访问速度是普通内存的几倍,尤其是在处理图像矩阵和Transformer模型时,这种带宽优势是压倒性的。
- 体积与功耗:一台标准4U GPU服务器重量普遍在100公斤以上,满载功耗能到3000瓦甚至更高,而普通2U服务器一般几百瓦就够用,重量也在30公斤以内。
- 成本与维护门槛:单个NVIDIA A100显卡的价格就超过一台普通中端服务器的总价,GPU服务器对散热、供电、机柜承重要求都极为苛刻。
针对常见采购场景的选型建议
搞清楚哪些服务器是GPU的之后,更重要的问题是怎么选,这里分几类常见需求给一些实操参考。
大模型预训练与微调场景
这类需求优先级是显存和卡间通信速度,预算充足的情况下,直接选择8卡A100/H100架构的整机租用,或者直接使用云厂商的PAW集群,如果预算有限,退而求其次选择A800或者国产昇腾910B。
- 关键指标:显存容量(至少60GB以上)、NVLink高速互联带宽
- 性价比方案:4卡A100或8卡A800服务器
- 避坑提示:不要用消费级RTX 4090卡去跑多卡预训练,虽然单卡便宜,但缺少NVLink导致扩展效率极差。
中小规模业务GPU推理与部署
这种情况不用追求顶配,云服务器上选择带T4或L20的实例已经完全够用,你的模型如果只是做OCR、语音识别或常规图片分类,用GPU服务器租用价格一般多少来衡量,按小时计费通常也就几块到十几块,唯一要注意的是选择支持自动扩缩容的托管集群,防止流量高峰打满显存。
财大气粗的渲染农场与云游戏机房
如果是自建机房,关注重点在功率密度和散热,这个场景不太适合云托管,物理服务器托管反而更划算,选购时可以多留意本地城市机房的政策,像北京GPU服务器托管一般价格较贵,但胜在延迟低,适合做云游戏机房和自动驾驶仿真,深圳、贵州的数据中心虽然在物理距离上更远,但电费和托管价格有较大优势。
远程使用GPU服务器的服务器配置什么模式比较好
很多高校学生和自由职业者,习惯通过远程连接来用GPU服务器,这种“服务器配置什么”的问题也很常见,这时候买整机不如租用GPU容器实例,配置远程环境时,强制要求自己使用SSH密钥认证,然后用Chrome远程桌面或者VS Code Remote-SSH插件来写代码,这套组合拳,体验感不输本地机房。
如果你的需求是快速跑通一个小型模型demo,在AutoDL或者恒源云这些算力租赁平台直接租按量计费的GPU节点就好,这些平台背后的云服务器池子里,全部是标准GPU服务器,你只需要关注显存够不够用,其余的底层细节平台全包了。
快速答疑:关于GPU服务器的几个高频疑问
Q1:GPU服务器和显卡服务器是同一个东西吗?
是同一个东西,显卡服务器就是GPU服务器的俗称,日常口语说显卡服务器指的是搭载了独立显卡(通常为NVIDIA数据中心GPU)的服务器主机,适合用来跑AIGC、3D渲染、科学计算等任务。
Q2:GPU服务器租用价格一般多少?市面上为什么差价那么大?
价格主要看显卡型号和时长,按小时租用带一颗T4显存16GB的云主机,价格低至数元一小时;带一颗A100 80GB显存的主机,价格则高出十余倍,年度包机比按量付费更划算,但主流云厂商都要求保留期资源,差价大的原因在于显存带宽、是否含NVLink互联、CPU与内存搭配不同,便宜的机器往往在算力隔离和数据安全方面做了让步。
Q3:深度学习用GPU服务器和普通服务器差距真的很大吗?
非常大,用普通CPU服务器训练一个中型卷积神经网络(例如ResNet-50跑ImageNet数据集),可能要数周时间,同样的任务放到搭载V100的GPU云服务器上,只需要几十个小时,如果换成更大的Transformer架构模型,CPU服务器甚至可能因为内存带宽瓶颈而跑不起来,GPU服务器则能轻松应对多Batch Size的并行矩阵运算,无论是开发调试还是生产推理,这个差距都是专业AI工程师无法忽视的核心选择标准。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771564.html